


写 C++ 时,真正拖慢进度的往往不是复杂语法本身,而是看起来密密麻麻、却不知道该从哪一行下手的编译报错。下面这篇内容把常见错误按类型拆开,再配合一套从“读信息”到“重新编译”的排查路径,帮助你判断问题属于语法、类型、链接还是警告级别,并据此选择更省时间的修复方式。
什么是 C++ 编译错误
当 C++ 编译器无法把源代码成功转换为可执行机器代码时,就会出现编译错误。它会直接阻止程序生成可执行文件,因此无论是初学者还是日常开发者,都需要先学会读懂这类错误信息。
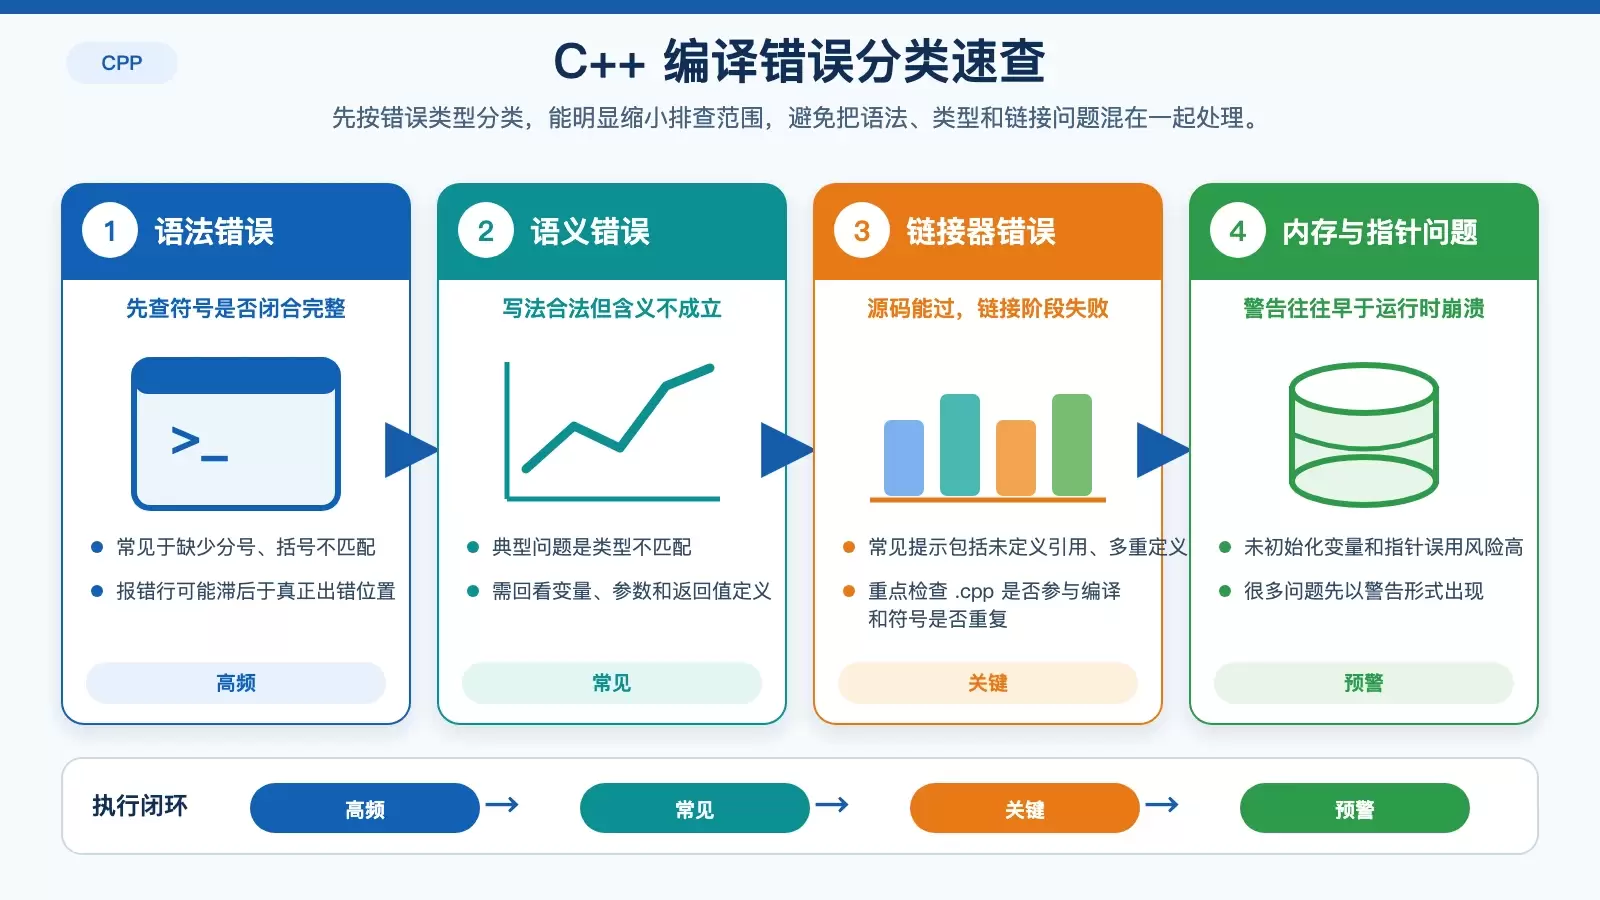
编译错误通常分哪几类
| 错误类型 | 描述 | 常见示例 |
|---|---|---|
| 语法错误 | 违反语言语法规则 | 缺少分号、括号不匹配 |
| 语义错误 | 代码结构或类型使用不正确 | 类型不匹配、函数调用不正确 |
| 链接器错误 | 连接不同代码模块时无法解析符号 | 未定义引用、多重定义 |
一次编译实际会经历哪些阶段
在 Ubuntu 上使用 g++ 编译 C++ 程序时,通常会经过以下几个阶段:
- 预处理
- 编译
- 汇编
- 链接
理解这个顺序很有用,因为很多报错其实能直接对应到具体阶段。比如语法和类型问题通常出现在编译阶段,undefined reference 这类问题则多半落在链接阶段。
先用带警告的基础命令编译
g++ -Wall -std=c++11 myprogram.cpp -o myprogram
-Wall 会开启常见警告,能帮助你在错误变成更大问题之前先看到提示。如果需要更严格一些,后文还会提到 -Wextra。
常见错误类型与典型原因
语法错误:先看符号和结构是否完整
语法错误是最常见、也通常最容易定位的一类问题。它往往来自少写一个符号,或者代码块结构没有闭合。
// 缺少分号
int x = 5  // 错误:语句末尾应添加分号

// 括号不匹配
void function() {
    int x = 10;
    if (x > 0 {  // 错误:缺少右括号
        // 代码块
    }
}
遇到这类报错时,重点检查分号、圆括号、花括号,以及模板尖括号是否配对完整。编译器提示的行号有时并不是根因所在,真正的问题可能出现在前一行。
语义错误:编译器能读懂,但代码含义不成立
语义错误的特点是“写法像是合法的”,但类型、对象或调用关系并不正确。最常见的就是类型不匹配。
int main() {
    std::string name = 42;  // 错误:无法将整数转换为字符串
    return 0;
}
这类问题通常需要你回到变量声明、函数参数和返回值定义,逐个核对类型是否一致。
链接器错误:代码能编过去,但程序连不起来
如果源码阶段没有报错,但最终生成可执行文件时失败,问题通常出在链接器。典型场景是函数声明了却没定义,或者同一个符号被定义了多次。
| 错误类型 | 描述 | 示例 |
|---|---|---|
| 未定义引用 | 函数或符号定义缺失 | 调用未实现的函数 |
| 多重定义 | 同一符号重复定义 | 在多个文件中定义同名函数 |
看到这类错误时,应该重点检查:
- 对应的
.cpp文件是否参与编译 - 函数是否只有声明没有实现
- 头文件里是否误放了非
inline的定义
与内存和指针有关的问题
有些问题不一定都在编译期直接报错,但编译器的警告已经在提醒你代码存在风险,尤其是未初始化变量和指针误用。
int* ptr;  // 未初始化的指针
*ptr = 10;  // 未定义行为
这类问题最好不要等到运行期再处理。只要编译器已经给出警告,就应该立刻回头修正。
模板和泛型代码为什么更难排查
模板报错通常更长,也更容易把真正的问题藏起来。根因往往不是模板本身,而是传入类型不满足模板要求。
template <typename T>
T add(T a, T b) {
    return a + b;
}

int main() {
    // 如果自定义类型未定义'+'运算符,则会出错
    MyCustomType result = add(obj1, obj2);
    return 0;
}
看到模板错误时,不要一上来盯着一长串实例化栈。更有效的做法是先确认:传入类型是否支持模板内部依赖的操作,比如这里的 + 运算符。
警告级别也要认真看
| 警告级别 | 描述 | 建议操作 |
|---|---|---|
| 低 | 小问题 | 可选复查 |
| 中 | 潜在问题 | 调查 |
| 高 | 可能是错误 | 立即修复 |
很多 C++ 问题一开始只是警告,拖到后面才演变成更难排查的运行时错误。把警告当成待修复事项,通常能省下更多调试时间。
更高效的排查流程:从报错信息一路追到根因
系统处理比反复猜测更有效
遇到编译错误时,建议按下面的顺序处理,而不是一边改一边试:
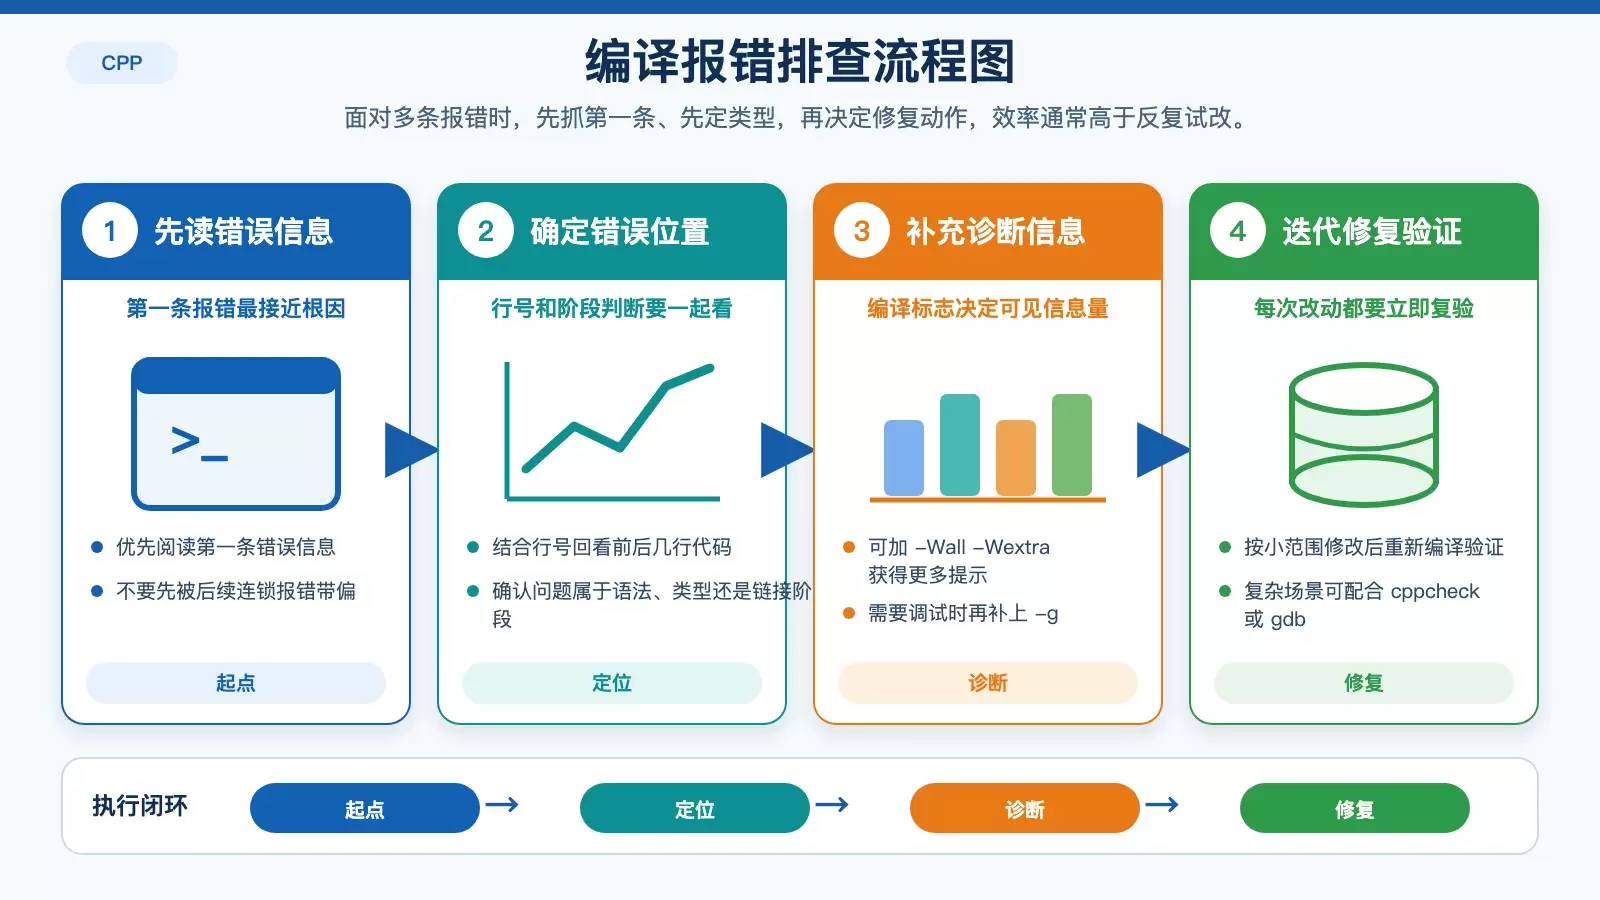
- 读取错误信息
- 确定错误位置
- 理解错误类型
- 应用针对性修复
- 重新编译验证
这个顺序的价值在于,先确定“编译器在说什么”,再决定“你要改哪里”。很多时候,连续出现的多条错误其实由同一个根因触发。
详细诊断时该加哪些编译器标志
| 标志 | 用途 | 示例 |
|---|---|---|
-Wall |
启用常见警告 | g++ -Wall main.cpp |
-Wextra |
启用额外警告 | g++ -Wextra main.cpp |
-g |
生成调试信息 | g++ -g main.cpp |
如果你只保留一个习惯,建议至少把 -Wall -Wextra 加上;如果后续还要进调试器,再加 -g。
如何解读编译器信息
先看第一条错误,而不是最后一条。第一条往往最接近根因,后面的报错可能只是连锁反应。
// 示例易错代码
int main() {
    int x;
    return x;  // 未初始化变量警告
}
对应输出可能类似:
main.cpp: warning: 'x' is used uninitialized
这条信息已经明确告诉你,问题不是语法,而是变量在赋值前就被使用。此时继续盯着 return 语句本身没有意义,应该回到变量初始化逻辑去修。
增量排查适合处理复杂错误
当报错很多、代码又比较长时,可以把排查范围逐步缩小:
- 先编译较小代码段
- 单独测试某个函数
- 隔离有问题的代码块
- 必要时加入打印或调试器辅助定位
这种方法尤其适合模板、大量头文件依赖,或者一次性冒出几十条报错的情况。
静态分析和 GDB 什么时候用
如果单靠编译器信息仍然不够,可以补充使用静态分析工具和调试器。
常见静态分析工具包括:
- Clang 静态分析器
- cppcheck
- Valgrind
例如:
cppcheck --enable=all main.cpp
如果需要进一步进入调试流程,可以这样编译并启动 GDB:
## 编译时带有调试符号
g++ -g main.cpp -o myprogram

## 启动调试会话
gdb ./myprogram
减少编译错误的日常做法
把问题尽量挡在编译之前
| 技术 | 描述 | 优点 |
|---|---|---|
| RAII | 资源获取即初始化 | 自动资源管理 |
| 智能指针 | 自动内存管理 | 防止内存泄漏 |
| 强类型检查 | 严格的类型检查 | 减少运行时错误 |
适合长期保留的排错习惯
- 始终使用警告标志进行编译,如
-Wall -Wextra - 认真阅读第一条报错和对应行号
- 把复杂问题拆成更小的代码单元验证
- 使用现代 C++ 特性和智能指针
- 借助版本控制跟踪修改过程
- 定期更新编译器和工具链
对 C++ 来说,排查编译错误并不是纯粹的“修 bug”过程,更像是在训练你理解语言规则、类型系统和构建流程。只要分类思路清楚,大多数错误都能比想象中更快定位。









