

Python实现七种经典排序算法详解

本文通过Python代码实例,详细解析插入、选择、冒泡、快速、归并、堆排序及希尔排序七种经典算法。涵盖各算法的核心原理、时间复杂度分析及适用场景,提供多种优化实现方案,帮助开发者深入理解并掌握常用排序技术。
排序算法是计算机科学中的基础内容,以下所有示例均使用Python语言进行实现。
插入排序
原理:该算法通过循环遍历,每次将一个元素移动至数组中正确的已排序位置。它通常适用于长度较小的数组,或作为归并排序(mergesort)、快速排序(quicksort)等复杂排序算法的子过程。其时间复杂度为 O(n^2)。
# 1nd: 两两交换
def insertion_sort(arr):
 for i in range(1, len(arr)):
  j = i
  while j >= 0 and arr[j-1] > arr[j]:
   arr[j], arr[j-1] = arr[j-1], arr[j]
   j -= 1
 return arr
# 2nd: 交换,最后处理没交换的
def insertion_sort2(arr):
 for i in range(1, len(arr)):
  j = i-1
  key = arr[i]
  while j >= 0 and arr[j] > key:
   arr[j+1] = arr[j]
   j -= 1
  arr[j+1] = key
 return arr
# 3nd: 加速版本,利用已经排好了序的进行二分查找
def insertion_sort3(seq):
 for i in range(1, len(seq)):
  key = seq[i]
  # invariant: ``seq[:i]`` is sorted
  # find the least `low' such that ``seq[low]`` is not less then `key'.
  # Binary search in sorted sequence ``seq[low:up]``:
  low, up = 0, i
  while up > low:
   middle = (low + up) // 2
   if seq[middle] < key:
    low = middle + 1
   else:
    up = middle
  # insert key at position ``low``
  seq[:] = seq[:low] + [key] + seq[low:i] + seq[i + 1:]
 return seq
# 4nd: 原理同上,使用bisect
import bisect
def insertion_sort4(seq):
 for i in range(1, len(seq)):
  bisect.insort(seq, seq.pop(i), 0, i) # 默认插在相同元素的左边
 return seq
选择排序
原理:每一趟遍历从待排序部分中选出最小值,并与当前下标对应的元素进行交换。该算法适用于大型数组场景,时间复杂度为 O(n^2)。
# 1nd: for
def select_sort(seq):
 for i in range(0, len(seq)):
  mi = i
  for j in range(i, len(seq)):
   if seq[j] < seq[mi]:
    mi = j
  seq[mi], seq[i] = seq[i], seq[mi]
 return seq
# 2nd: min
def select_sort2(seq):
 for i, x in enumerate(seq):
  mi = min(range(i, len(seq)), key=seq.__getitem__)
  seq[i], seq[mi] = seq[mi], x
 return seq
冒泡排序
原理:通过反复比较数组中相邻的两个元素,若前者大于后者则交换位置。重复走访数列,直至将最小值移动到最顶端。该方法适用于小型数组,时间复杂度为 O(n^2)。
def bubble_sort(seq):
 for i in range(len(seq)):
  for j in range(len(seq)-1-i):
   if seq[j] > seq[j+1]:
    seq[j], seq[j+1] = seq[j+1], seq[j]
 return seq
def bubble_sort2(seq):
 for i in range(0, len(seq)):
  for j in range(i + 1, len(seq)):
   if seq[i] > seq[j]:
    seq[i], seq[j] = seq[j], seq[i]
 return seq
快速排序
原理:从数组中选择一个基准值(pivot),将数组划分为两部分:一部分小于基准值,另一部分大于基准值。最后将这两部分与基准值合并。最好情况下的时间复杂度为 O(n log n),最差情况下的时间复杂度为 O(n^2)。
def quick_sort(seq):
 if len(seq) >= 1:
  pivot_idx = len(seq)//2
  small, large = [], []
  for i, val in enumerate(seq):
   if i != pivot_idx:
    if val <= seq[pivot_idx]:
     small.append(val)
    else:
     large.append(val)
  quick_sort(small)
  quick_sort(large)
  return small + [seq[pivot_idx]] + large
 else:
  return seq
归并排序
原理:归并排序是一种基于归并操作的有效排序算法,是分治法(Divide and Conquer)的典型应用。其核心思想是将已有序的子序列合并,从而得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。
# 1nd: 将两个有序数组合并到一个数组
def merge(left, right):
 i, j = 0, 0
 result = []
 while i < len(left) and j < len(right):
  if left[i] <= right[j]:
   result.append(left[i])
   i += 1
  else:
   result.append(right[j])
   j += 1
 result += left[i:]
 result += right[j:]
 return result
def merge_sort(lists):
 if len(lists) <= 1:
  return lists
 num = len(lists) / 2
 left = merge_sort(lists[:num])
 right = merge_sort(lists[num:])
 return merge(left, right)
# 2nd: use merge
from heapq import merge
def merge_sort2(m):
 if len(m) <= 1:
  return m
 middle = len(m) // 2
 left = m[:middle]
 right = m[middle:]
 left = merge_sort(left)
 right = merge_sort(right)
 return list(merge(left, right))
堆排序
原理:堆排序利用堆积树(堆)这种数据结构设计而成,属于选择排序的一种,可利用数组特点快速定位指定索引元素。堆分为大根堆和小根堆,均为完全二叉树。大根堆要求每个节点的值不大于其父节点的值,即 A[PARENT[i]] >= A[i]。在数组的非降序排序中,需使用大根堆,因为根据定义,最大值一定位于堆顶。其平均时间复杂度为 O(n log n)。
# 1nd: normal
def swap(seq, i, j):
 seq[i], seq[j] = seq[j], seq[i]
# 调整堆
def heapify(seq, end, i):
 l = 2 * i + 1
 r = 2 * (i + 1)
 ma = i
 if l < end and seq[i] < seq[l]:
  ma = l
 if r < end and seq[ma] < seq[r]:
  ma = r
 if ma != i:
  swap(seq, i, ma)
  heapify(seq, end, ma)
def heap_sort(seq):
 end = len(seq)
 start = end // 2 - 1
 # 创建堆
 for i in range(start, -1, -1):
  heapify(seq, end, i)
 for i in range(end - 1, 0, -1):
  swap(seq, i, 0)
  heapify(seq, i, 0)
 return seq
# 2nd: use heapq
import heapq
def heap_sort2(seq):
 """ Implementation of heap sort """
 heapq.heapify(seq)
 return [heapq.heappop(seq) for _ in range(len(seq))]
希尔排序
原理:希尔排序(Shell Sort)是插入排序的一种改进版本,也称缩小增量排序,属于非稳定排序算法。该算法将记录按下标的一定增量进行分组,对每组使用直接插入排序算法进行排序;随着增量逐渐减少,每组包含的关键词越来越多,当增量减至 1 时,整个文件恰被分成一组,算法随即终止。
def shell_sort(seq):
 count = len(seq)
 step = 2
 group = count // step
 while group > 0:
 for i in range(0, group):
 j = i + group
 while j < count:
 k = j - group
 key = seq[j]
 while k >= 0:
  if seq[k] > key:
  seq[k + group] = seq[k]
  seq[k] = key
  k -= group
 j += group
 group //= step
 return seq
区别
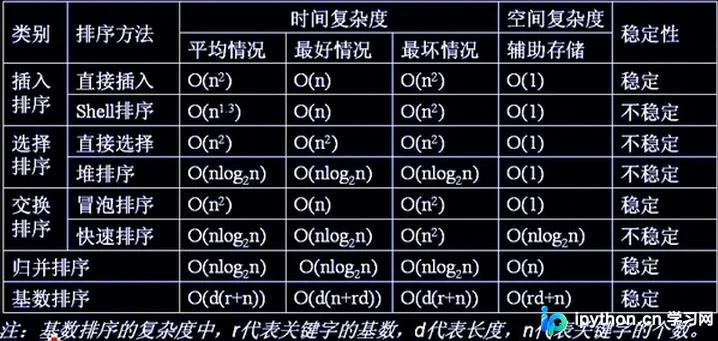
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









