

Python实现堆排序案例详解

本文详细解析Python实现堆排序的原理与步骤。从堆的定义、大顶堆与小顶堆的区别入手,通过具体列表示例演示构建完全二叉树、调整节点及交换堆顶与堆尾的过程。最后提供完整的Python代码实现,并分析堆排序的时间复杂度O(nlogn)及不稳定性。
Python实现堆排序
一、堆排序简介
堆排序(Heap Sort)是一种基于堆这种数据结构的排序算法。
堆在结构上表现为一棵完全二叉树,并满足堆的性质:除了叶节点外,每个节点的值都大于等于(或小于等于)其子节点的值。
关于二叉树和完全二叉树的详细介绍,可参考:https://www.jb51.net/article/222487.htm
堆排序首先将待排序列表中的元素按从上到下、从左到右的顺序构建为一棵完全二叉树,随后调整该树以满足堆的性质。构建完成后,将堆顶元素与堆尾元素交换,并将堆尾元素移出堆(即取出当前最大或最小值)。重复构建堆、交换堆顶与堆尾、取出堆尾元素的操作,直至所有元素被取出,列表即完成排序。
堆结构主要分为大顶堆和小顶堆两种类型:
1. 大顶堆:除叶节点外,每个节点的值均大于等于其子节点的值,根节点为所有节点中的最大值。在堆排序中,大顶堆用于实现升序排列。
2. 小顶堆:除叶节点外,每个节点的值均小于等于其子节点的值,根节点为所有节点中的最小值。在堆排序中,小顶堆用于实现降序排列。
二、堆排序原理
堆排序的具体原理如下:
1. 将待排序列表中的数据按照从上到下、从左到右的顺序,构建为一棵完全二叉树。
2. 对完全二叉树中每个非叶节点,将其值与其子节点(子节点可能有一个或两个)中较大的值进行比较。若节点值小于子节点值,则交换两者的位置(大顶堆情形;小顶堆则反之)。
3. 节点与子节点交换后,需继续将该节点(现位于子节点位置)与孙节点进行比较,直到无需交换或子节点为叶节点时停止。遍历所有非叶节点后,即可构建出完整的堆结构。
4. 数据构建为堆结构后,将堆顶元素与堆尾元素交换,随后将堆尾元素从堆中移除并加入已排序序列。至此完成一轮堆排序,堆中剩余数据个数减1。
5. 重复执行步骤2、3、4,直到堆中所有数据被取出,列表排序完成。
以列表 [10, 17, 50, 7, 30, 24, 27, 45, 15, 5, 36, 21] 进行升序排列为例。列表的初始状态如下图所示。
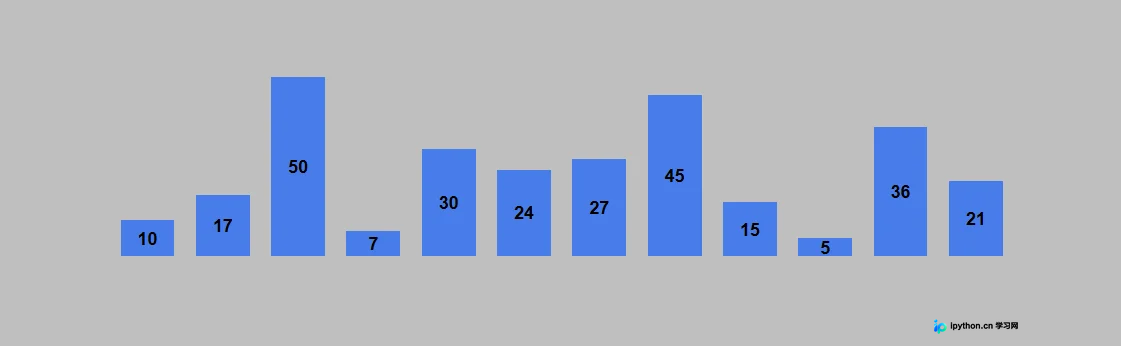
由于需要进行升序排序,在构造堆结构时应使用大顶堆。
1. 将待排序列表中的数据按从上到下、从左到右的顺序构建为一棵完全二叉树。
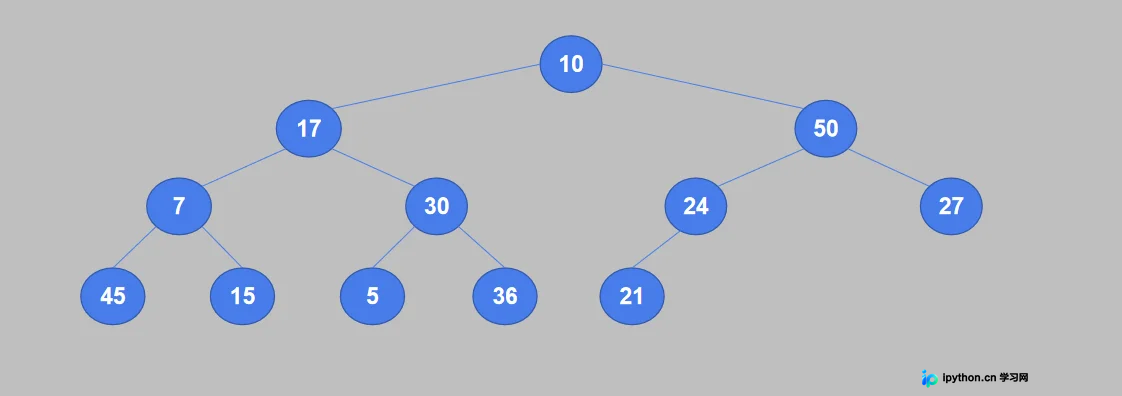
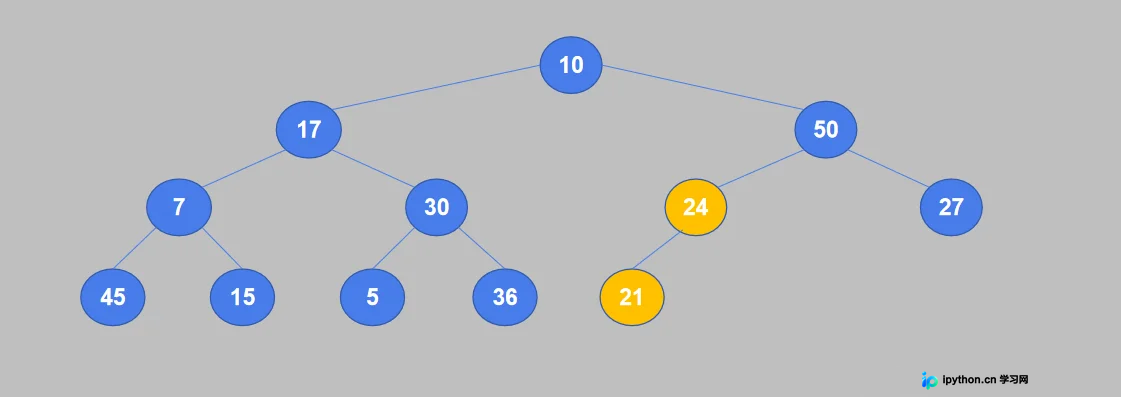
2. 从完全二叉树的最后一个非叶节点开始,将其值与子节点中较大的值进行比较,若节点值小于子节点值则交换。本例中24是最后一个非叶子节点,它仅有一个子节点21,因24大于21,故无需交换。
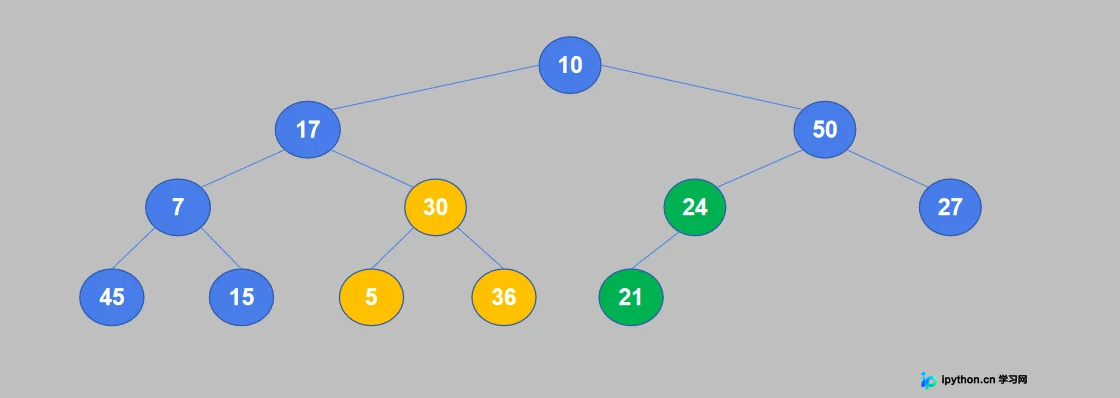
3. 继续处理倒数第二个非叶节点,将其值与子节点中较大的值进行比较,若小于则交换。节点30有两个子节点5和36,其中较大值为36,因30小于36,故交换两者位置。
4. 继续对下一个节点进行比较。因7小于45,故交换两者位置。
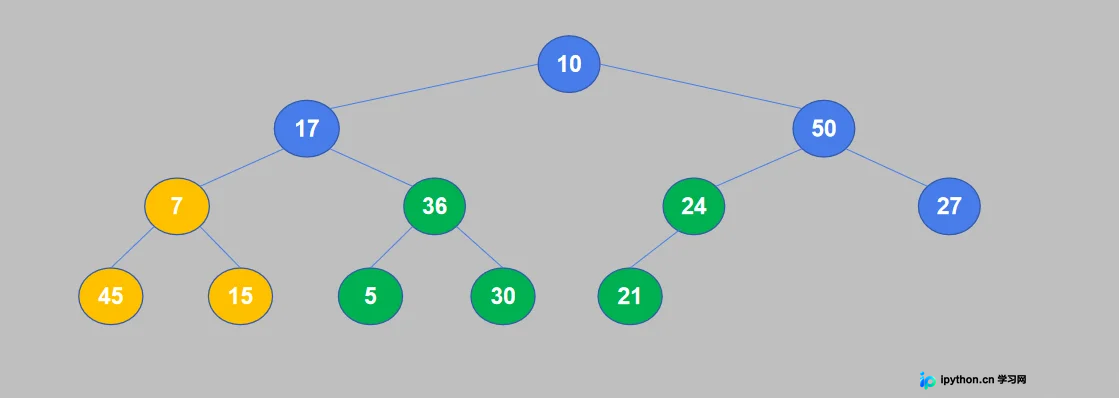
5. 继续重复上述过程。因50大于27,无需交换位置。若无需交换,则无需再比较子节点与孙节点。
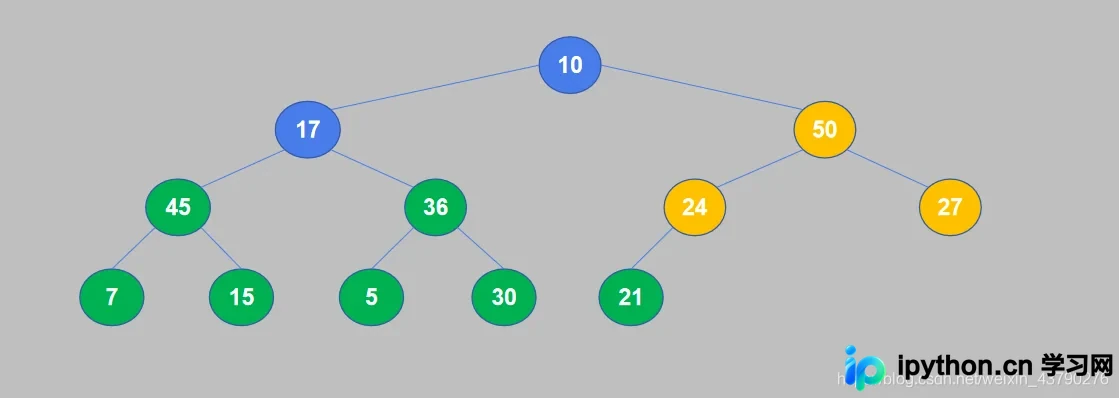
6. 继续重复,因17小于45,故交换两者位置。
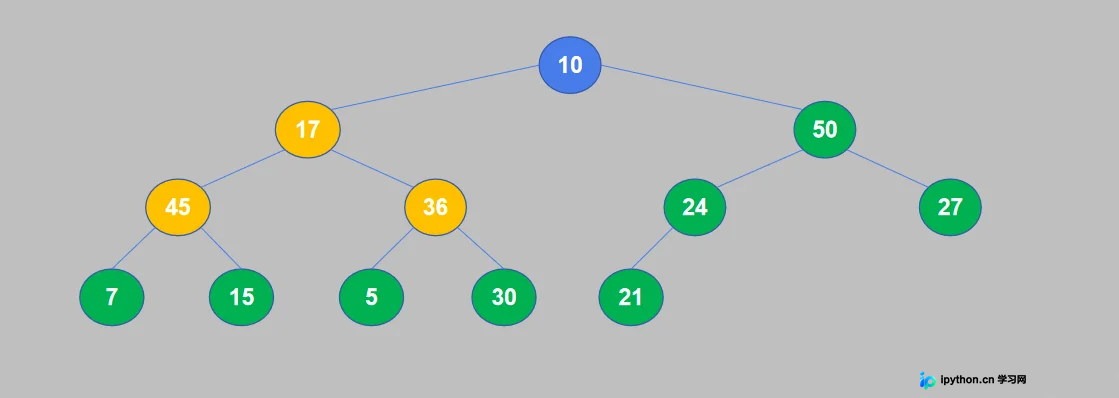
7. 17与45交换位置后,17移动到了子节点位置,此时需继续将其与孙节点进行比较。因17大于15,故无需交换。
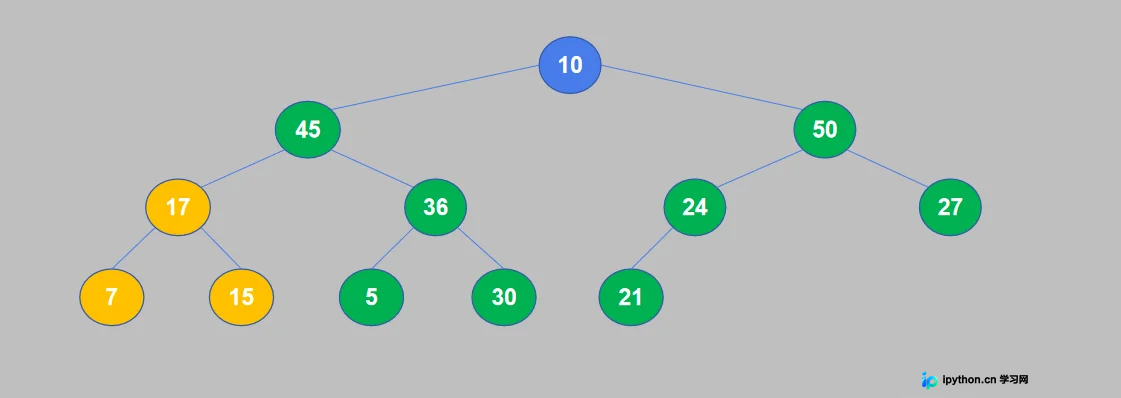
8. 继续对下一个节点进行比较,因10小于50,故交换两者位置。
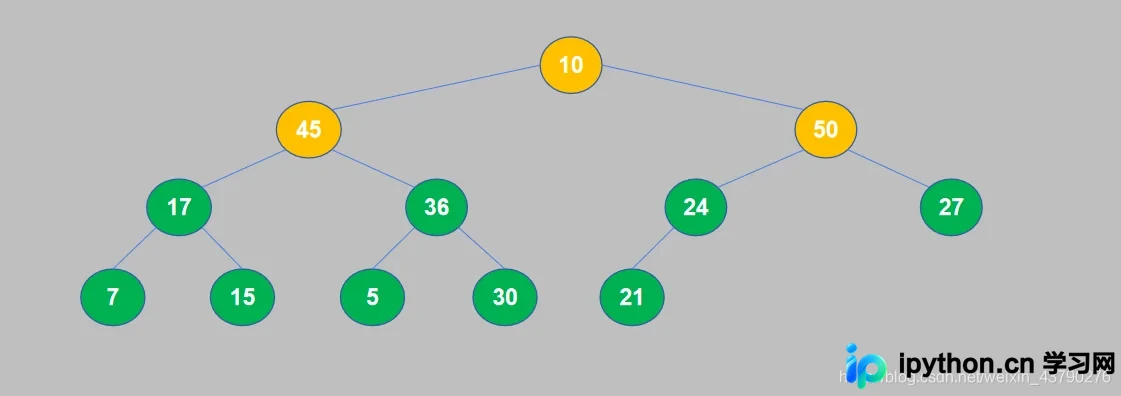
9. 10与50交换位置后,10移动到了子节点位置,需继续将其与孙节点进行比较。因10小于27,故交换两者位置。
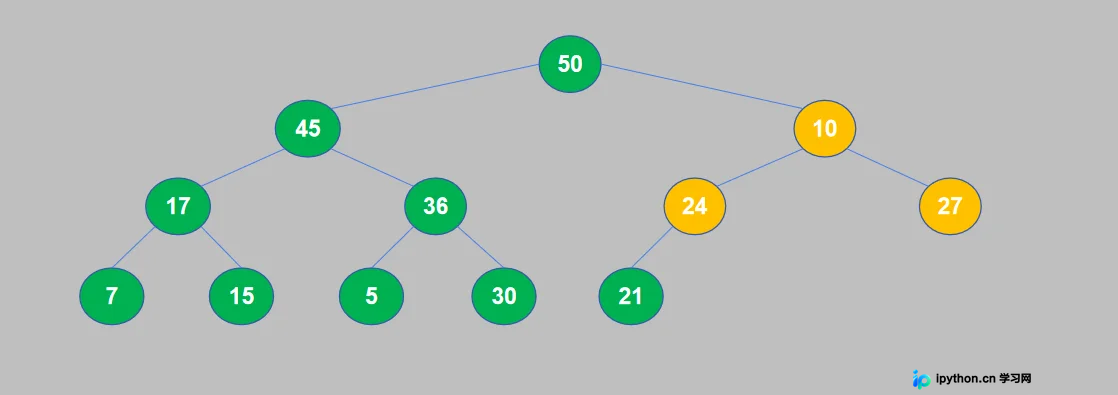
10. 此时,一个大顶堆构造完成,满足堆的性质:除叶节点外,每个节点的值均大于等于其子节点的值。
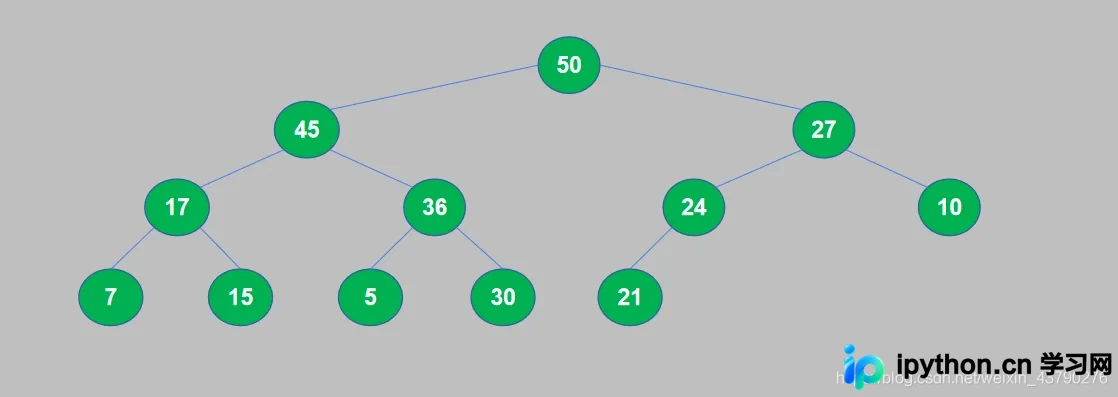
11. 大顶堆构建完成后,将堆顶与堆尾交换位置,随后将堆尾元素从堆中取出。具体操作为将50和21交换位置,交换后21位于堆顶,50(最大数据)位于堆尾,随后将50从堆中取出。
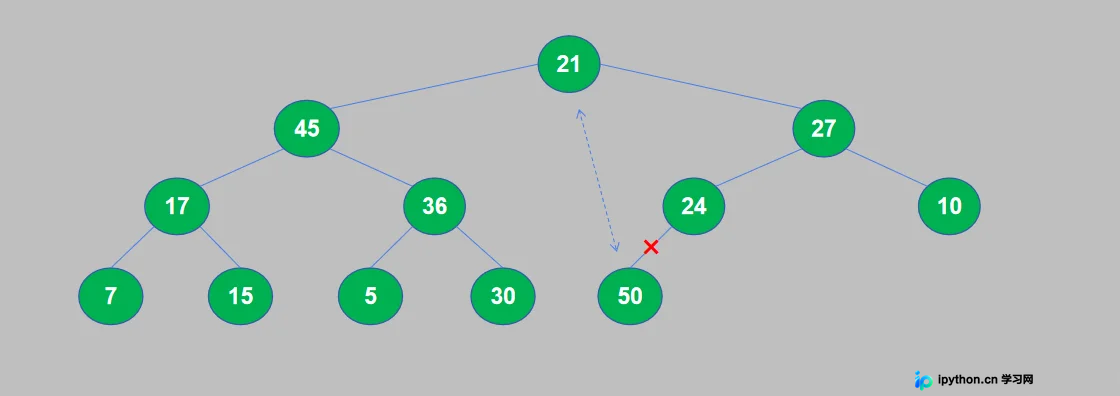
12. 将50从堆中取出后,即找到了待排序列表中的最大值。将50添加到已排序序列中,第一轮堆排序完成,堆中剩余元素个数减1。
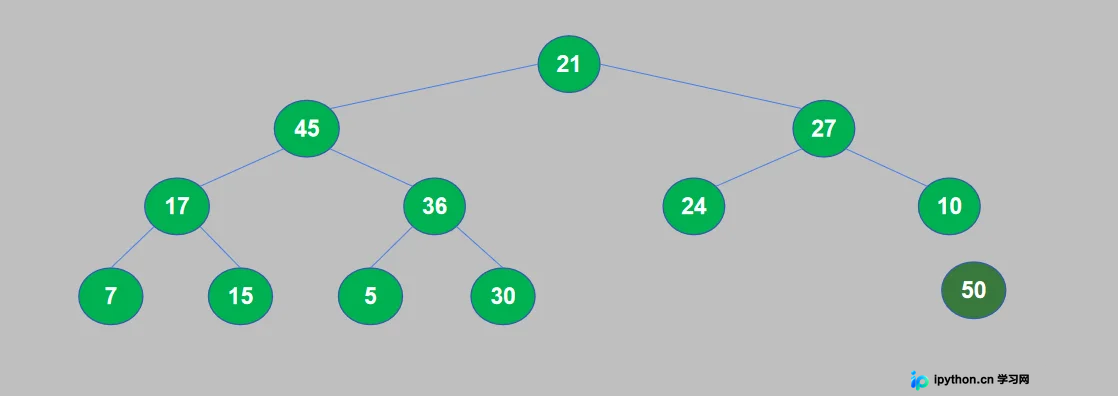
13. 取出最大数据后,重复执行将完全二叉树构建成大顶堆、交换堆顶和堆尾、取出堆尾元素的操作。每次操作均取出当前堆中最大的数据并添加到已排序序列中,直到堆中所有数据被取出。
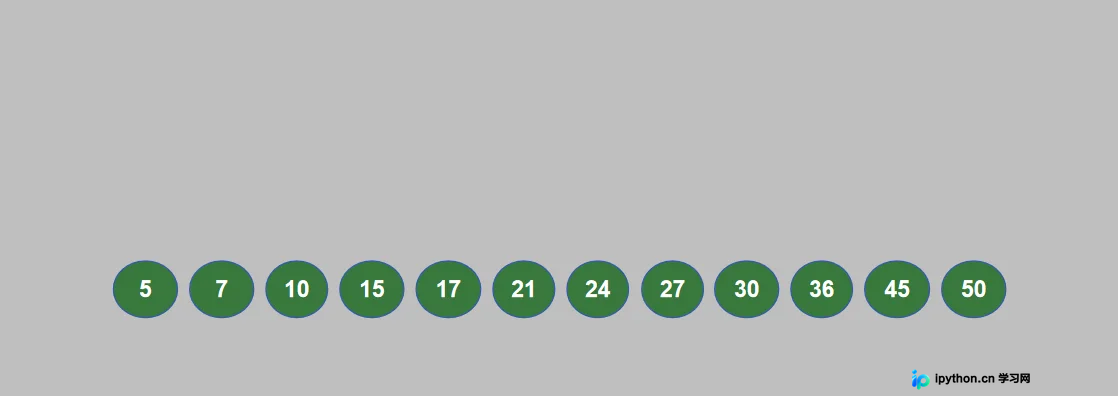
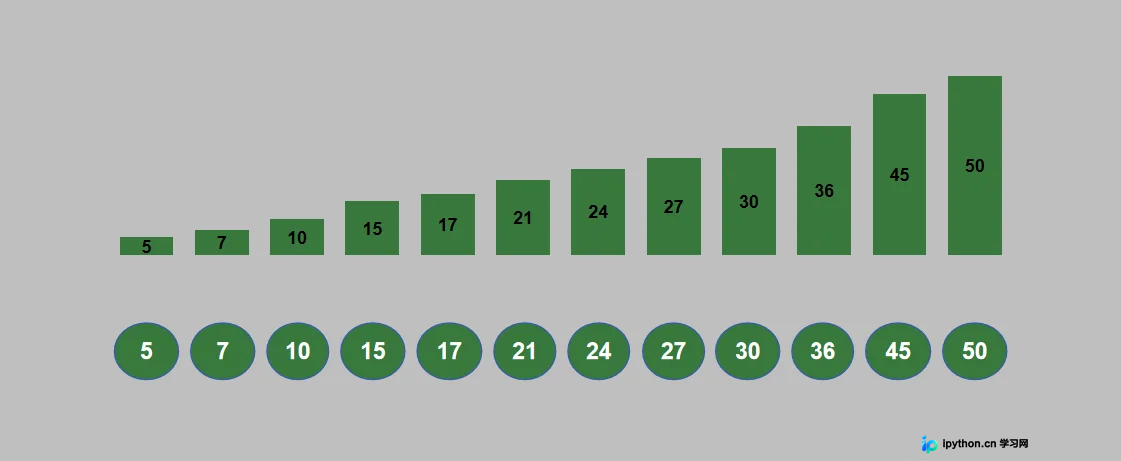
14. 循环执行 n 轮堆排序之后,列表排序完成。排序结果如下图所示。
三、Python实现堆排序
# coding=utf-8
def heap_sort(array):
    first = len(array) // 2 - 1
    for start in range(first, -1, -1):
        # 从下到上,从右到左对每个非叶节点进行调整,循环构建成大顶堆
        big_heap(array, start, len(array) - 1)
    for end in range(len(array) - 1, 0, -1):
        # 交换堆顶和堆尾的数据
        array[0], array[end] = array[end], array[0]
        # 重新调整完全二叉树,构造成大顶堆
        big_heap(array, 0, end - 1)
    return array


def big_heap(array, start, end):
    root = start
    # 左孩子的索引
    child = root * 2 + 1
    while child <= end:
        # 节点有右子节点,并且右子节点的值大于左子节点,则将child变为右子节点的索引
        if child + 1 <= end and array[child] < array[child + 1]:
            child += 1
        if array[root] < array[child]:
            # 交换节点与子节点中较大者的值
            array[root], array[child] = array[child], array[root]
            # 交换值后,如果存在孙节点,则将root设置为子节点,继续与孙节点进行比较
            root = child
            child = root * 2 + 1
        else:
            break


if __name__ == '__main__':
    array = [10, 17, 50, 7, 30, 24, 27, 45, 15, 5, 36, 21]
    print(heap_sort(array))
运行结果:
[5, 7, 10, 15, 17, 21, 24, 27, 30, 36, 45, 50]
代码中,首先实现一个 big_heap(array, start, end) 函数,用于比较节点与其子节点中的较大者,若节点值小于子节点值则进行交换。代码中无需真正将数据添加到完全二叉树结构中,而是依据待排序列表中的索引来确定节点与子节点的位置关系。在完全二叉树中,若节点索引为 i,则其左子节点索引为 2*i+1,右子节点索引为 2*i+2。对于包含 n 个节点的完全二叉树,非叶子节点共有 n//2 个。由于列表索引从0开始,因此索引范围为 0 到 n//2-1 的数据对应非叶子节点。
在实现堆排序函数 heap_sort(array) 时,首先调用 big_heap(array, start, end) 函数循环调整所有非叶子节点,以构造大顶堆。随后将堆顶与堆尾交换,将堆尾元素从堆中取出并加入已排序序列,完成一轮堆排序。接着循环构建大顶堆,每次取出最大元素,直到堆中所有数据被取出。
四、堆排序的时间复杂度和稳定性
1. 时间复杂度
在堆排序中,构建一次大顶堆可取出一个元素,完成一轮堆排序,共需进行 n 轮堆排序。每次构建大顶堆时,所需的比较和交换次数平均为 logn(第一轮构建堆时步骤较多,后续重建堆时步骤会大幅减少)。时间复杂度为 T(n)=nlogn,再乘以每次操作的步骤数(常数,不影响大O记法),因此堆排序的时间复杂度为 O(nlogn)。
2. 稳定性
在堆排序过程中,会交换节点与子节点。若存在相等的数据,交换操作可能会改变这些相等数据的相对次序。因此,堆排序是一种不稳定的排序算法。
到此这篇关于Python实现堆排序案例详解的文章就介绍到这了,更多相关Python实现堆排序内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









