

Python遍历字典列表时怎么处理KeyError和空值

在 Python 中解析接口响应数据、读取批量日志或处理由数据表导出的记录时,“字典列表”(即 list[dict])是最核心的数据载体。然而在实际遍历操作中,开发者常常面临两类常见异常与数据质量问题:一是部分记录缺少预期键,直接采用下标索引(如 item["field"])会引发 KeyError 并中断整个流程;二是键虽然存在,但其对应的值为 None、空字符串 "" 或空容器,若不加甄别直接参与业务运算,极易引发类型错误或逻辑失真。解决 KeyError 的基石是使用 dict.get(key, default) 设立安全读取屏障或通过 key in item 显式分流;而治理空值则需要厘清业务语义,利用 is not None 等精准条件完成数据清洗。本文将从根源出发,提供一套系统、实用的处理范式与代码方案。
一、KeyError 的产生根源与遍历风险
在规范的理想数据模型中,列表中每一个字典的字段结构应当高度统一。但在实际工程场景下,输入数据往往属于“异构数据”(Heterogeneous Data)。例如,不同客户端版本上报的埋点日志可能字段不一,第三方 Web API 在字段无内容时可能直接在 JSON 中剔除该键,或者来自 NoSQL 数据库的文档本身就没有严格的 Schema 约束。
Python 字典的底层依赖哈希表实现。当程序尝试访问一个字典中并不存在的键时,解释器不会默认填充空值,而是严格抛出 KeyError 异常。在批量循环中,哪怕前九十九条记录都完好无损,只要第一百条记录缺少了某个字段,整个循环就会瞬间崩溃退出,未处理的数据便会全部阻塞。
# 示例:包含缺失键与空值的典型异构字典列表
records = [
    {"id": 101, "name": "张三", "score": 95},
    {"id": 102, "name": "李四"},  # 缺少 "score" 键
    {"id": 103, "name": "王五", "score": None},  # 键存在但值为空
    {"id": 104, "name": "赵六", "score": 0}      # 合法的零值
]

# 脆弱的直接访问:循环在遇到李四时将直接崩溃
for student in records:
    # 抛出 KeyError: 'score'
    print(student["name"], student["score"])
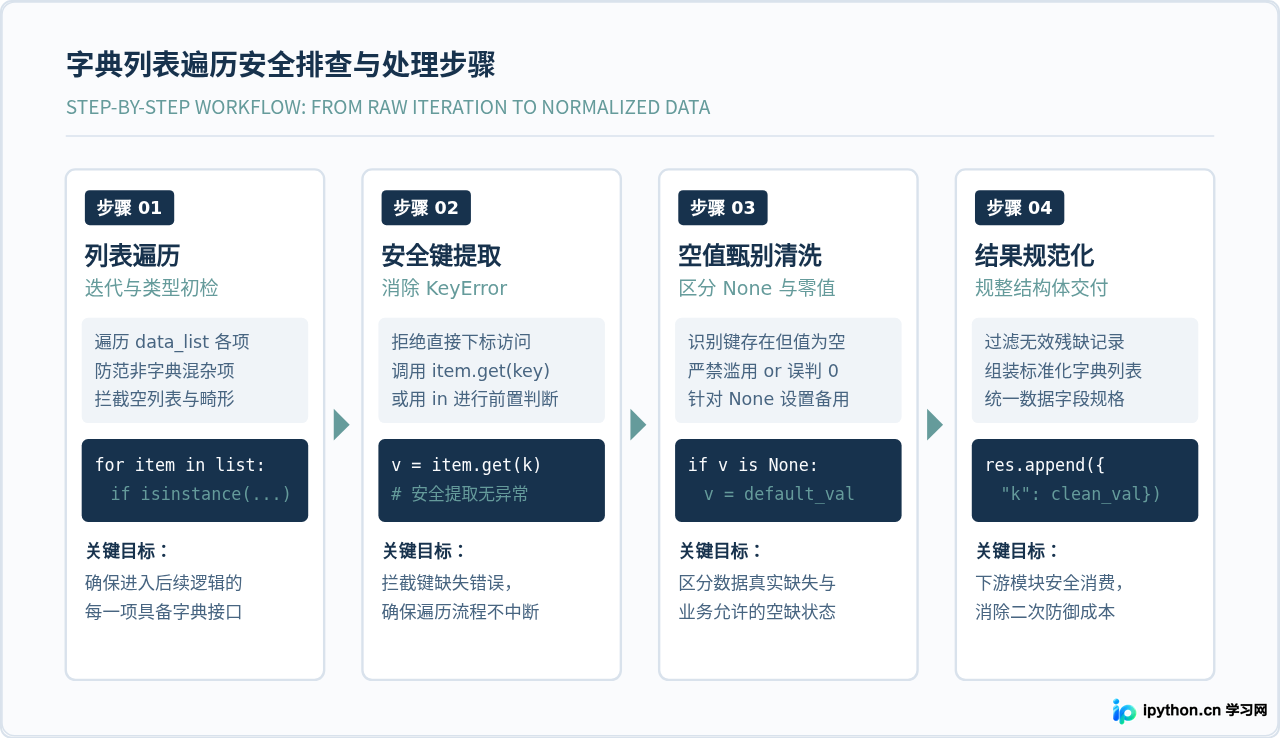
为了规避上述崩溃并保证遍历顺利完成,我们需要建立标准化的四步排查与处理路径:从外层迭代开始,逐层进行键安全提取、空值甄别与规范化组装,具体逻辑如下所示:
二、预防 KeyError 的三种实用方案对比
针对字典中可能存在的键缺失问题,Python 生态中演化出了三种成熟的应对方案。它们在代码紧凑度、执行性能和适用边界上各有侧重。
1. 原生方法 dict.get(key, default)
这是处理单字段安全访问最通用且简洁的方案。dict.get() 在底层由 C 语言原生实现,当键存在时直接返回值;当键不存在时,它不会抛出 KeyError,而是静默返回指定的默认值(若未显式指定,默认返回 None)。
for student in records:
    # 当 score 缺失时安全退回默认值 0,绝不抛出 KeyError
    score = student.get("score", 0)
    name = student.get("name", "匿名")
    print(f"{name}: {score}")
2. 成员检查操作符 in(LBYL 模式)
“先看后跳”(Look Before You Leap)是防御性编程的经典流派。如果业务逻辑规定“键存在时执行正常流水线,键缺失时执行专门的报警或归档流程”,那么使用 in 关键字显式判断键的存在性是结构最清晰的选择。
for student in records:
    if "score" in student:
        # 仅在键存在时进入处理分支
        print(f"有效记录: {student['name']} -> {student['score']}")
    else:
        # 针对缺失记录执行告警或单独标记
        print(f"告警: 学生ID {student.get('id')} 缺失 score 字段")
3. 异常捕获 try...except KeyError(EAFP 模式)
“与其请求许可,不如事后道歉”(Easier to Ask for Forgiveness than Permission)是 Python 官方推崇的设计哲学。对于绝大多数(如 99% 以上)数据结构高度规范、缺失键仅属于罕见意外的高吞吐量批处理任务,直接索引并在外层捕获异常,能省去正常分支下的多次条件判定开销。
for student in records:
    try:
        score = student["score"]
    except KeyError:
        score = 0
    # 继续后续逻辑处理
    print(f"已结算成绩: {score}")
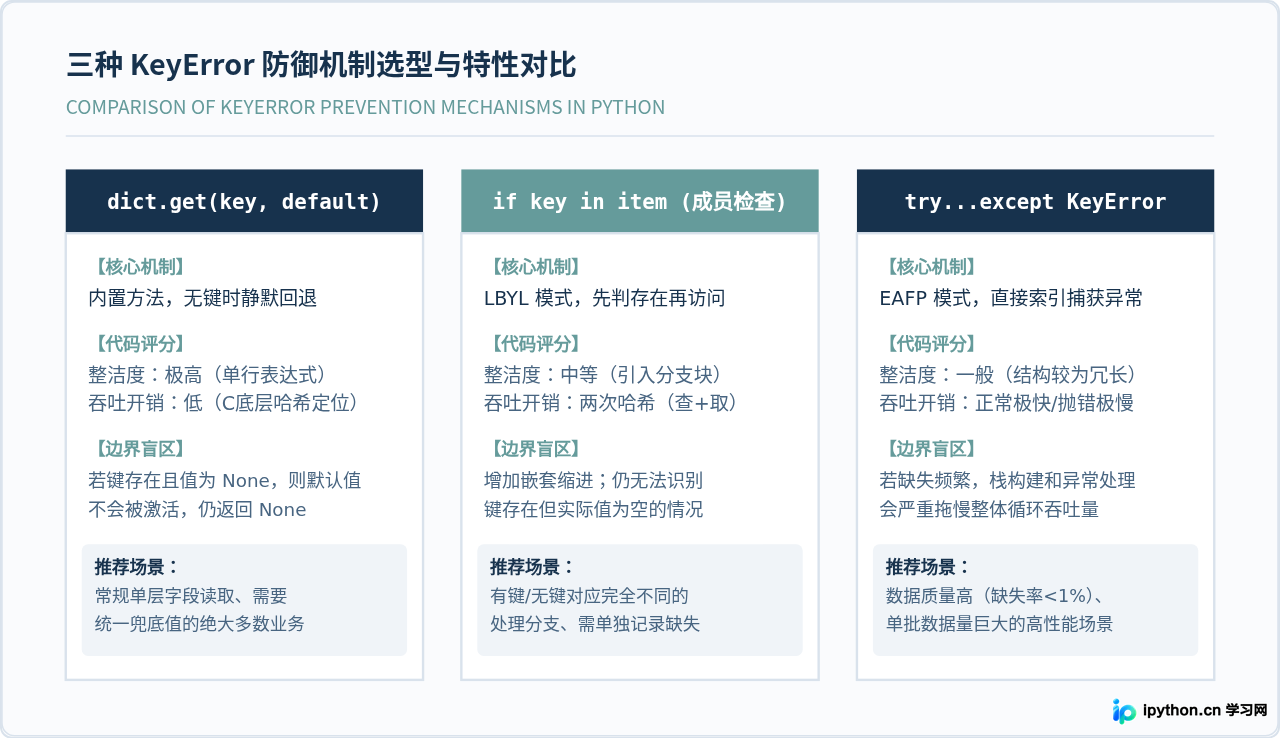
这三种方案在机制、开销和适用场景上的详细对比矩阵如下图所示:
三、区分与解决不同类型的“空值”陷阱
许多开发者在初步解决了 KeyError 后,往往会误以为数据已经完全安全,随后便撞上了更为隐蔽的“空值陷阱”。必须明确的一点是:KeyError 关注的是键是否存在(Key Existence),而空值问题关注的是键所绑定的值是否有效(Value Validity)。
1. dict.get() 无法防御已经存在的 None
回顾前文示例中的王五:{"id": 103, "name": "王五", "score": None}。如果调用 student.get("score", 0),返回的结果并不是我们期望的默认值 0,而是原封不动的 None!
原因在于:dict.get() 的默认值机制仅在字典完全找不到该键时才生效。只要字典中声明了该键(即便其值显式赋值为 None),get() 就会认为查找命中,从而直接返回 None。如果下游代码紧接着执行数学计算(如 score + 5),就会立即抛出 TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'。
2. 警惕 or 运算误杀合法假值
为了解决上述问题,部分开发者习惯性地采用短路逻辑:score = student.get("score") or 0。这种写法在面对 None 或空字符串 "" 时确实能退回 0,但潜藏着严重的逻辑漏洞:
- 对于赵六的真实记录
{"name": "赵六", "score": 0},数字0在 Python 布尔上下文中属于假值(Falsy),0 or 0虽恰好还是 0,但如果遇到布尔状态字段时就极其危险。 - 例如配置字段
is_vip = user.get("is_vip") or True:若某用户的真实属性是{"is_vip": False},执行后由于False为假,其值会被强行篡改为True,从而造成破坏性的业务逻辑错误。
3. 安全的精准空值判定范式
在需要区分“缺失/空对象”与“合法零值/假值”的场景中,应始终使用身份运算符 is None 进行严格匹配:
raw_score = student.get("score")
# 仅当键缺失返回 None,或键本身的值为 None 时,才采用备选值
score = 0 if raw_score is None else raw_score
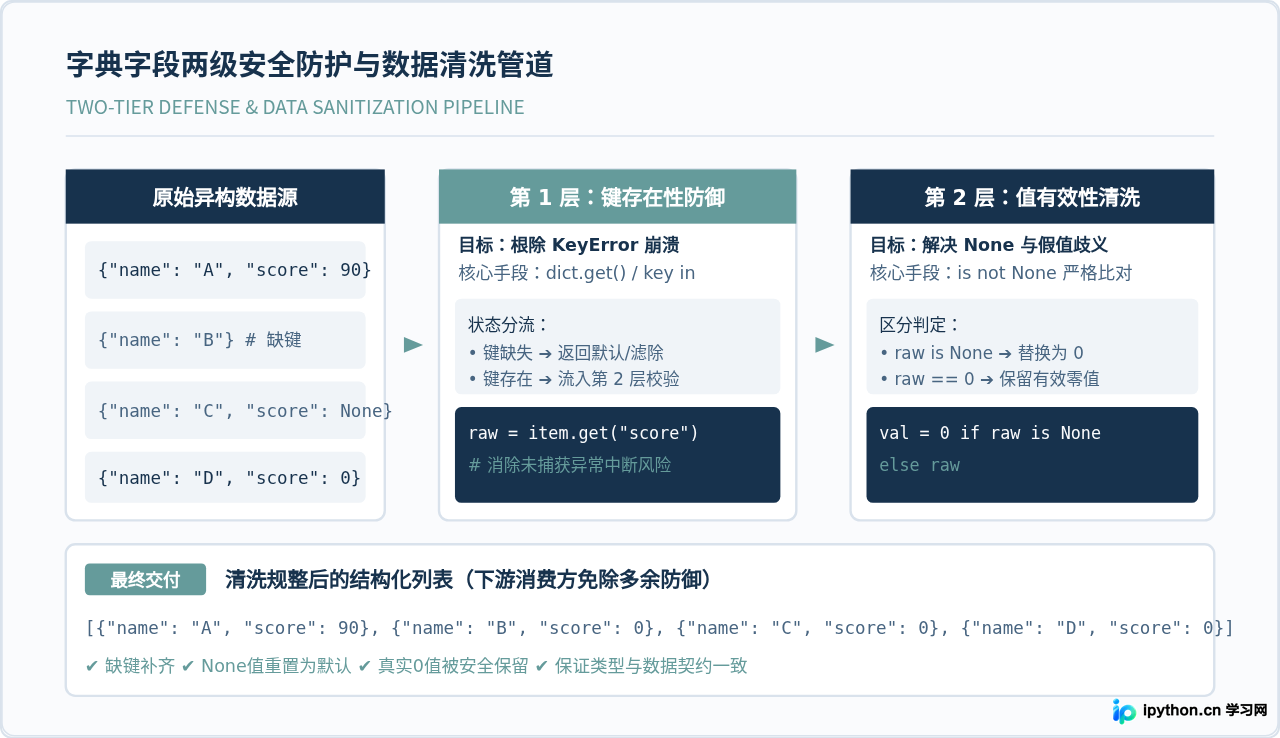
构建两级安全防护管道(第一级拦截 KeyError,第二级校验并清洗空值),可以确保异构数据源在进入下游前达到完全标准化:
四、高频实战模式:推导式与流水线数据清洗
掌握了核心原理后,我们可以在日常开发中根据业务诉求,选用以下三种高效、优雅的高频实战范式。
1. 模式一:列表推导式提取有效数据集(过滤清洗模式)
在数据分析与清洗任务中,我们通常需要直接剔除无效、残缺的脏记录,仅保留包含完整有效信息的条目:
# 仅保留拥有 "score" 键且其值不为 None 的有效记录
valid_students = [
    {
        "id": s.get("id"),
        "name": s.get("name", "未知"),
        "score": s["score"]
    }
    for s in records
    if "score" in s and s["score"] is not None
]

# 输出清洗后的纯净列表
print(valid_students)
2. 模式二:数据结构标准化映射(字段补全模式)
若下游系统要求输入列表保持原长度不变,但每一个字典都必须拥有统一的字段集合与默认值回退:
def normalize_student(record):
    raw_score = record.get("score")
    return {
        "id": record.get("id"),
        "name": record.get("name", "未命名"),
        # 精准判定:如果是 None 则回退为 0,否则保留原数值
        "score": 0 if raw_score is None else raw_score
    }

# 批量转换
normalized_records = [normalize_student(item) for item in records]
3. 模式三:深层嵌套字典的安全链式取值
面对更复杂的嵌套字典(例如 item["meta"]["contact"]["email"]),任何一层父级键缺失或对应值为 None,都会导致 KeyError 或 AttributeError: 'NoneType' object has no attribute 'get'。可以通过封装链式提取函数来保障安全:
def safe_get(dictionary, keys, default=None):
    """递归或迭代安全提取多层嵌套字典键值"""
    current = dictionary
    for key in keys:
        if not isinstance(current, dict):
            return default
        current = current.get(key)
        if current is None:
            return default
    return current

# 示例调用
user_data = {"profile": {"contact": None}}
email = safe_get(user_data, ["profile", "contact", "email"], "未提供邮箱")
print(email)  # 输出: 未提供邮箱,且不产生任何异常
五、总结与策略选择决策树
在 Python 中遍历字典列表时,处理 KeyError 和空值的核心原则可以归结为以下四点:
- 划清界限:“键缺失”由字典访问机制引起,应在第一层使用
dict.get()、in或try-except解决;“值为空”是数据内容本身的问题,必须在第二层针对值类型进行核验。 - 首选
get():对于常规扁平取值场景,dict.get(key, default)是可读性与性能的最佳平衡点。 - 禁用盲目
or:切忌用val or default粗暴替代所有默认值赋值,务必使用is not None显式保护0和False等合法假值。 - 封装清洗:复杂的多层校验与数据转换应抽离为纯函数或推导式管道,保证主业务循环逻辑的凝练与稳健。
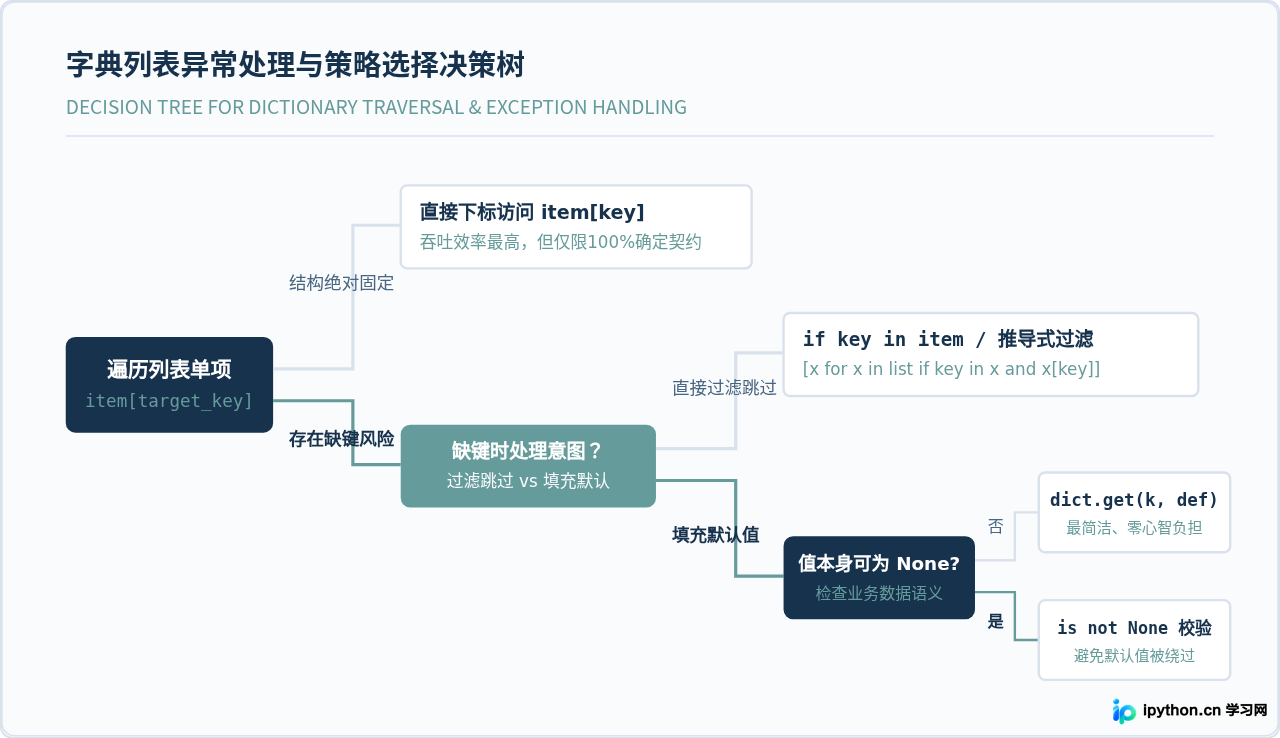
下图整理了一套完整的异常防御策略选择决策树,方便在日常编码时按需快速决策:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









