

Windows环境Python程序绑定特定物理CPU核心的方法

一、Windows CPU 拓扑识别与物理核/逻辑核映射
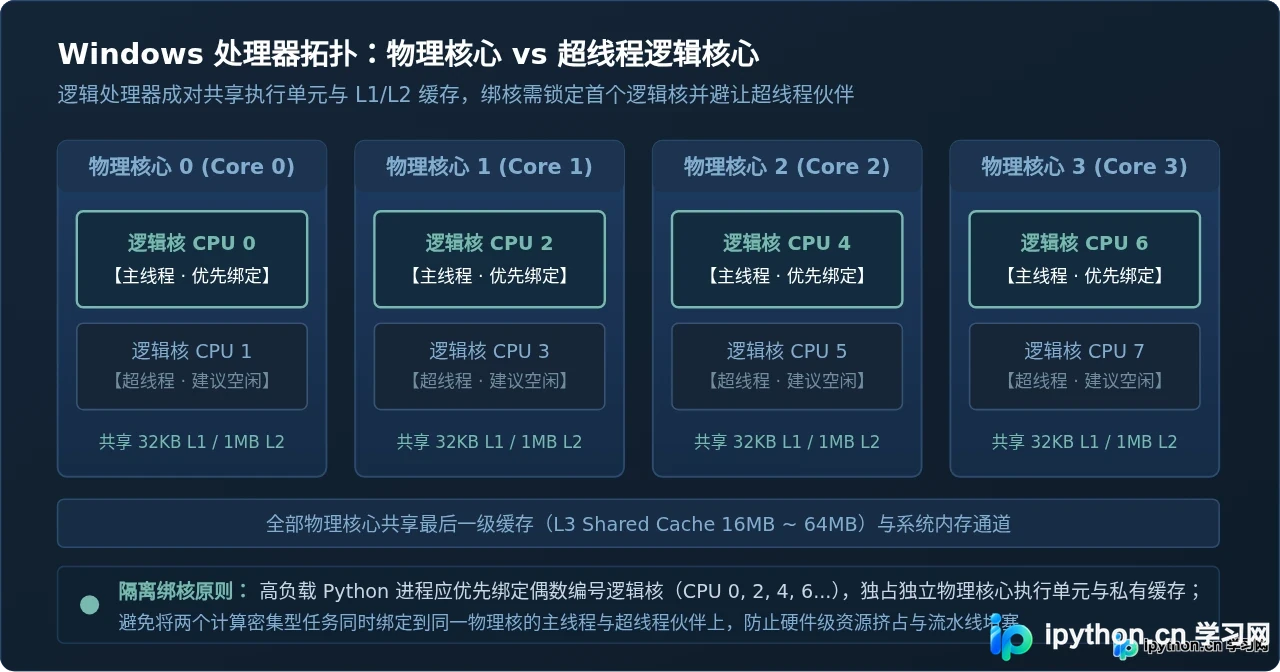
在实施绑核之前,必须清晰区分物理核心(Physical Cores)与逻辑处理器(Logical Processors)。现代主流 x86/x64 处理器普遍采用超线程技术(Intel Hyper-Threading 或 AMD SMT)。以一颗常见的 8 核 16 线程处理器为例,硬件内部实际存在 8 个独立的物理运算核心,但在 Windows 系统中,操作系统呈现为 16 个逻辑处理器,编号为 CPU 0 至 CPU 15。
在 Windows 的默认逻辑处理器编排拓扑中,通常按照成对连续的编号将逻辑处理器映射到同一物理核心。即:物理核心 0 对应逻辑核 CPU 0 与 CPU 1;物理核心 1 对应 CPU 2 与 CPU 3;物理核心 2 对应 CPU 4 与 CPU 5,以此类推。
同一物理核心内的两个逻辑超线程共享该物理核内部独占的一级指令缓存(L1i)、一级数据缓存(L1d)、二级缓存(L2 Cache)以及算术逻辑单元(ALU)与浮点运算单元(FPU)。如果将两个独立的密集计算 Python 任务分别分配到 CPU 0 与 CPU 1,二者不仅不会实现性能翻倍,反而会因为同时争抢 L1/L2 缓存线与硬件计算单元,导致严重的流水线停顿与缓存颠簸。
因此,真正的“物理核心绑定”准则为:始终绑定每个物理核心的主逻辑处理器(通常为偶数编号逻辑核 0, 2, 4, 6...),并主动让与其配对的奇数超线程保持空闲或仅处理低优先级轻量任务,从而确保 Python 计算进程独占完整的物理计算资源。
二、CPU 亲和性掩码(Affinity Mask)原理与换算
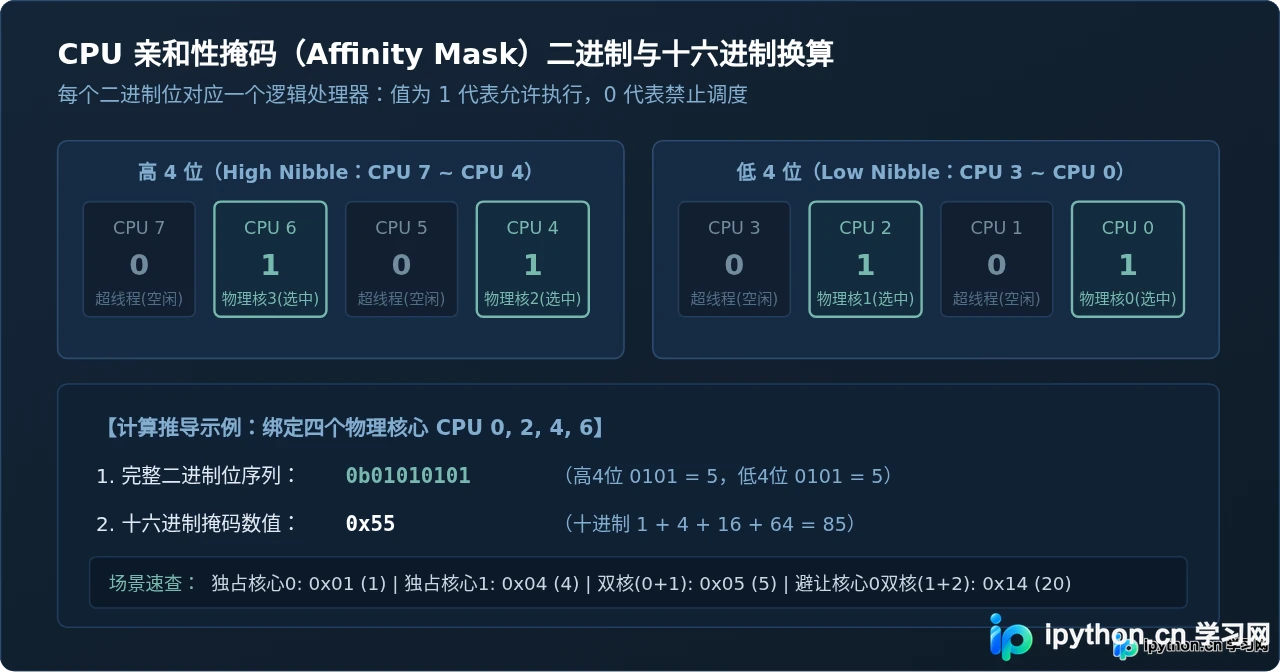
在 Windows 内核级架构中,进程或线程允许运行的核心集合是通过一个位掩码(Bitmask)表示的,对应 Win32 API 中的 DWORD_PTR 或 ULONG_PTR 整数类型。掩码中的每一个二进制位(Bit)精确对应系统中的一个逻辑处理器编号:
- 最低有效位(Bit 0)对应
CPU 0,Bit 1 对应CPU 1,Bit 2 对应CPU 2,以此类推直到 Bit n 对应CPU n。 - 若某个位的值为 1,代表允许操作系统将该进程调度到对应的 CPU 核心上运行;
- 若某个位的值为 0,则代表严格禁止该进程在对应 CPU 核心上执行。
在向 Windows 传递亲和性参数时,通常使用十六进制(Hexadecimal)表示。下面通过具体场景演示掩码的换算推导方法:
- 场景 A:仅绑定物理核心 0(逻辑核 CPU 0)
二进制序列为00000001,转换为十六进制为0x01(十进制数值为1)。 - 场景 B:仅绑定物理核心 1(逻辑核 CPU 2)
二进制序列为00000100,转换为十六进制为0x04(十进制数值为4)。 - 场景 C:同时绑定物理核心 0 与物理核心 1(CPU 0 与 CPU 2)
二进制序列为00000101,转换为十六进制为0x05(十进制数值为1 + 4 = 5)。 - 场景 D:同时绑定前四个独立物理核心(CPU 0, 2, 4, 6)
二进制序列为01010101,高 4 位0101为 5,低 4 位0101为 5,十六进制表示为0x55(十进制数值为1 + 4 + 16 + 64 = 85)。
三、方法一:使用 psutil 库实现动态绑核(推荐方案)
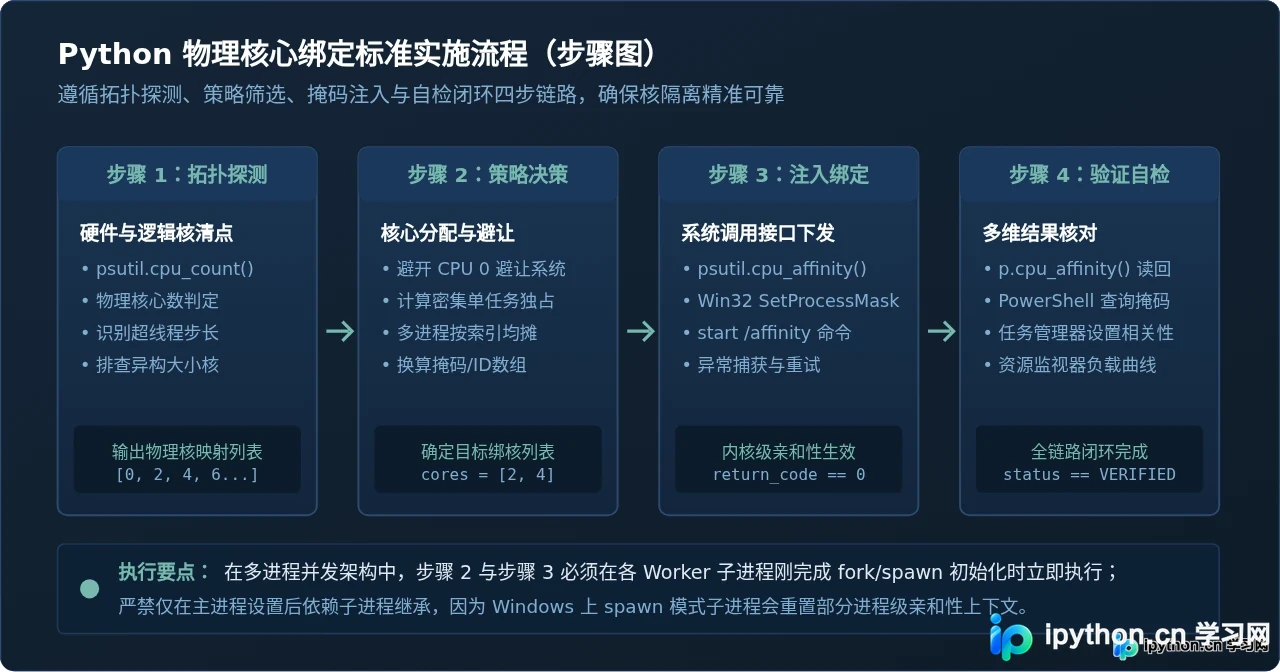
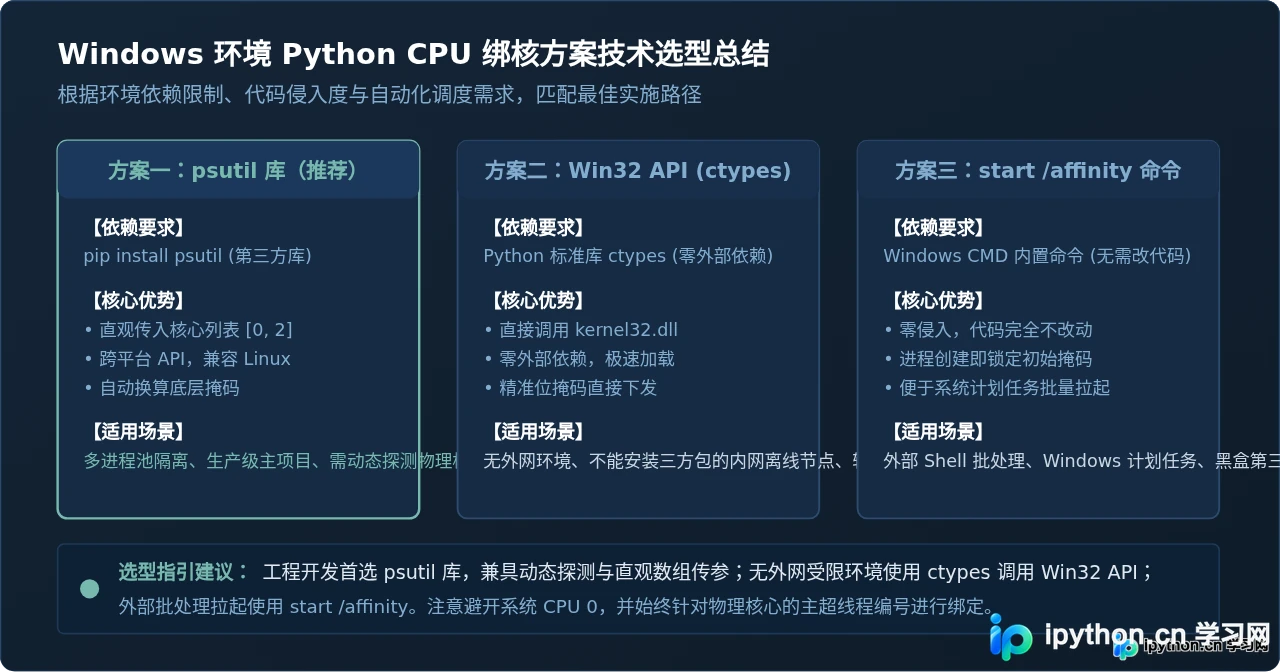
在常规工程实践中,推荐优先采用 Python 生态中功能完备的跨平台系统库 psutil。它对 Windows 原生 API 进行了清晰的高级对象封装,无需开发者手动处理底层位运算指针,且支持直接传入逻辑核心编号列表。
安装依赖命令如下:
pip install psutil
通过 psutil.Process().cpu_affinity() 方法,既可以读取当前进程的亲和核心列表,也可以传入整数列表设置绑核。以下为动态检测系统拓扑并绑定物理核心的完整工程示例:
import os
import psutil

def bind_to_physical_cores(core_indices=None):
    """
    将当前 Python 进程绑定到指定物理核心。
    若未指定 core_indices,则自动提取系统中所有物理核心的主超线程编号。
    """
    process = psutil.Process(os.getpid())

    # 打印绑定前的默认核心范围
    initial_affinity = process.cpu_affinity()
    total_logical = psutil.cpu_count(logical=True)
    total_physical = psutil.cpu_count(logical=False)
    print(f"[拓扑探测] 逻辑核心数: {total_logical}, 物理核心数: {total_physical}")
    print(f"[初始状态] 进程 PID {process.pid} 初始亲和核心: {initial_affinity}")

    if core_indices is None:
        # 在启用超线程的系统中,步长为 2 提取偶数编号作为物理核心主线程
        step = total_logical // total_physical if total_physical else 1
        core_indices = [i * step for i in range(total_physical)]

    # 执行亲和性设置
    process.cpu_affinity(core_indices)

    # 读回自检
    current_affinity = process.cpu_affinity()
    print(f"[绑核成功] 进程 PID {process.pid} 已成功绑定到物理核心: {current_affinity}")
    return current_affinity

if __name__ == "__main__":
    # 示例:将当前进程绑定到物理核心 1 和物理核心 2(对应逻辑核 CPU 2, CPU 4)
    # 避开 CPU 0 可以有效避让 Windows 系统中断与桌面合成调度
    target_cores = [2, 4]
    bind_to_physical_cores(target_cores)
运行该脚本后,控制台将输出确认信息。此时 Windows 内核调度器保证该进程仅在 CPU 2 与 CPU 4 上运行,不再被迁移至其他核心。
四、方法二:通过 ctypes 调用原生 Win32 API 零依赖绑核
在部分严格受限的离线生产环境、金融内网终端或交付单文件免安装脚本时,可能无法通过 pip 安装第三方 psutil 库。此时可以直接利用 Python 内置的 ctypes 标准库调用 Windows 内核动态链接库 kernel32.dll 中的原生函数。
需要使用的 Win32 核心函数为:
GetCurrentProcess():获取当前进程的伪句柄(返回值为HANDLE类型)。SetProcessAffinityMask(HANDLE hProcess, DWORD_PTR dwProcessAffinityMask):向目标进程句柄下发指定的亲和性掩码。GetProcessAffinityMask(HANDLE hProcess, PDWORD_PTR lpProcessAffinityMask, PDWORD_PTR lpSystemAffinityMask):获取当前进程与系统的亲和性掩码。
完整零外部依赖的代码实现如下:
import os
import ctypes
from ctypes import wintypes

# 加载 Windows 内核接口库
kernel32 = ctypes.WinDLL("kernel32", use_last_error=True)

# 定义 64 位平台指针大小的整型类型 (DWORD_PTR)
DWORD_PTR = ctypes.c_size_t
PDWORD_PTR = ctypes.POINTER(DWORD_PTR)

# 设置函数原型签名
kernel32.GetCurrentProcess.restype = wintypes.HANDLE
kernel32.GetCurrentProcess.argtypes = []

kernel32.SetProcessAffinityMask.restype = wintypes.BOOL
kernel32.SetProcessAffinityMask.argtypes = [wintypes.HANDLE, DWORD_PTR]

kernel32.GetProcessAffinityMask.restype = wintypes.BOOL
kernel32.GetProcessAffinityMask.argtypes = [wintypes.HANDLE, PDWORD_PTR, PDWORD_PTR]

def set_cpu_affinity_mask(mask: int):
    """
    通过 Win32 API 设置当前进程的处理器亲和性掩码。
    mask: 整数掩码值(如 0x05 代表 CPU 0 和 CPU 2)
    """
    h_process = kernel32.GetCurrentProcess()
    success = kernel32.SetProcessAffinityMask(h_process, DWORD_PTR(mask))
    if not success:
        errno = ctypes.get_last_error()
        raise OSError(f"SetProcessAffinityMask 调用失败,Win32 错误码: {errno}")

    # 读回当前掩码进行校验
    proc_mask = DWORD_PTR()
    sys_mask = DWORD_PTR()
    kernel32.GetProcessAffinityMask(h_process, ctypes.byref(proc_mask), ctypes.byref(sys_mask))
    print(f"[Win32 API] 进程 PID {os.getpid()} 亲和性掩码已生效: 0x{proc_mask.value:X} (十进制: {proc_mask.value})")
    return proc_mask.value

def bind_cores_by_list(core_list):
    """根据核心编号列表计算二进制掩码并下发"""
    mask = 0
    for core in core_list:
        mask |= (1 << core)
    return set_cpu_affinity_mask(mask)

if __name__ == "__main__":
    # 示例:绑定物理核心 1、2、3(对应逻辑核 2, 4, 6)
    # 掩码计算: (1<<2) | (1<<4) | (1<<6) = 4 + 16 + 64 = 84 (0x54)
    target_cores = [2, 4, 6]
    bind_cores_by_list(target_cores)
该方案直接与 Windows 内核交互,执行开销极小且无需任何外部包支持,适合嵌入底层系统服务与高性能运算启动入口中。
五、方法三:通过 Windows start 命令与任务管理器外部绑核
如果手头已存在封装好的第三方 Python 运行程序或编译后的可执行文件(exe),不希望或无法直接修改源码时,可以通过操作系统提供的外部方式进行绑核。
1. CMD 命令行 start /affinity 参数启动
Windows 内置的命令解释器 cmd.exe 提供了 start 命令,其中 /affinity 参数支持在进程创建瞬间直接指定初始处理器掩码。语法格式如下:
start /affinity <十六进制掩码> python <脚本名.py> [参数...]
注意:命令行中的掩码必须为十六进制格式,且不需要添加 0x 前缀。示例如下:
start /affinity 1 python train.py:仅在CPU 0上启动。start /affinity 4 python train.py:仅在CPU 2(物理核心 1)上启动。start /affinity 14 python train.py:在CPU 2和CPU 4上启动(十六进制 14 = 二进制 00010100)。start /affinity 55 python train.py:在CPU 0, 2, 4, 6上启动(十六进制 55 = 二进制 01010101)。
2. 任务管理器图形化动态绑核
对于正在运行的 Python 进程,如果需要临时进行性能排查或动态核隔离验证,可以直接使用任务管理器:
- 按下快捷键
Ctrl + Shift + Esc打开 Windows 任务管理器。 - 切换到左侧或顶部的“详细信息”(Details)选项卡。
- 在进程列表中定位到目标
python.exe,右键点击并选择“设置相关性”(Set affinity)。 - 在弹出的处理器选择窗口中,取消勾选“所有处理器”,仅勾选目标物理核对应的复选框(例如“CPU 2”与“CPU 4”),点击“确定”即可实时生效。
六、进阶实战:Python 多进程(multiprocessing)物理核隔离架构
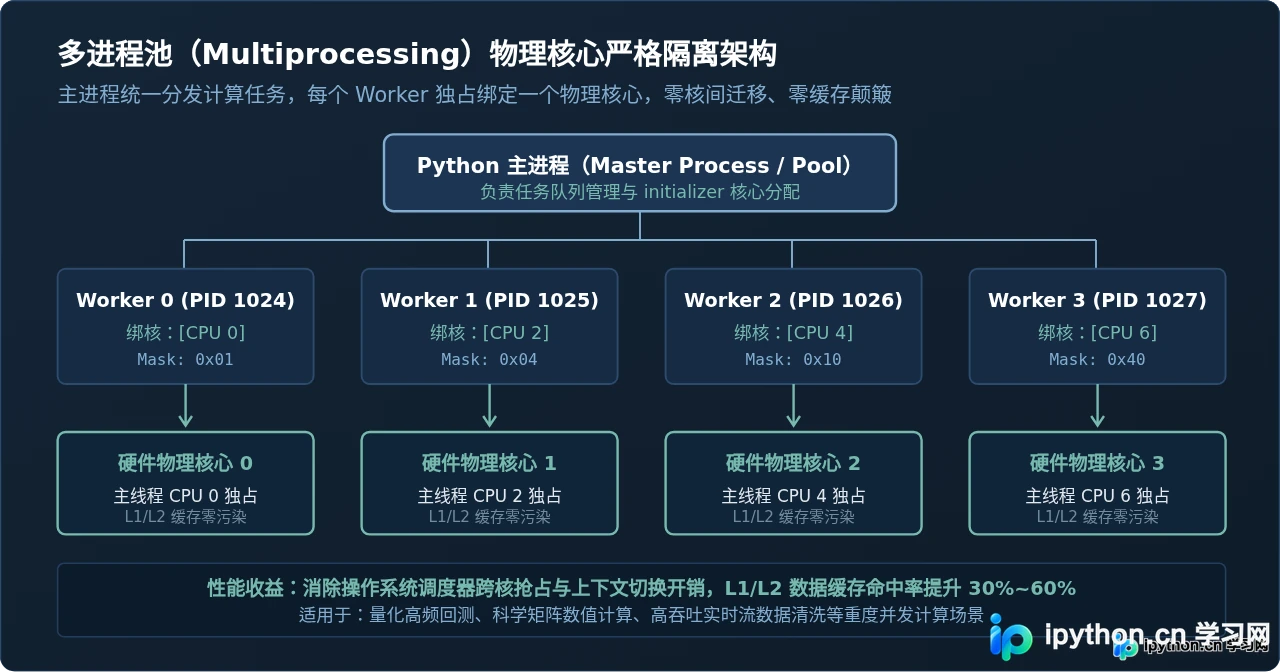
在实际并发工程中,最严苛的场景通常是利用 multiprocessing.Pool 运行多进程任务。如果在主进程中绑定了多个核心,默认情况下所有 Worker 子进程都会共享这一掩码,进而在多个核之间互相抢占。
最优解是:在 Worker 子进程初始化的生命周期钩子(initializer)中,为每个 Worker 分配唯一的独占物理核心,使 N 个 Worker 与 N 个独立的硬件物理核心形成一对一严格静态映射。
在 Windows 系统中,multiprocessing 默认采用 spawn 启动模式,主进程状态不通过内存写时复制(fork)直接继承,因此需要通过进程安全的计数器或同步队列向子进程传递其分配的核心编号。
完整的多进程池物理核隔离绑定代码实现如下:
import os
import time
import psutil
from multiprocessing import Pool, Manager

def worker_init(core_queue):
    """Worker 进程初始化回调函数:从核心队列中取出专属核心并执行绑定"""
    try:
        # 获取专属物理核心编号
        assigned_core = core_queue.get_nowait()
    except Exception:
        assigned_core = 0  # 兜底核心

    # 为当前子进程绑定独占核心
    proc = psutil.Process(os.getpid())
    proc.cpu_affinity([assigned_core])
    print(f"[Worker 启动] 子进程 PID: {os.getpid()} -> 独占锁定物理核心: [CPU {assigned_core}]")

def heavy_compute_task(task_id):
    """模拟 CPU 密集型计算任务并校验当前运行核心"""
    proc = psutil.Process(os.getpid())
    current_affinity = proc.cpu_affinity()

    # 模拟高负载矩阵运算或循环
    start_time = time.time()
    total = sum(i * i for i in range(10_000_000))
    elapsed = time.time() - start_time

    return f"任务 {task_id}: PID {os.getpid()}, 绑核 {current_affinity}, 耗时 {elapsed:.3f}s, 结果 {total}"

def main():
    # 规划分配的物理核心列表:避让 CPU 0,选取 3 个独立物理核心的主超线程
    target_physical_cores = [2, 4, 6]
    worker_count = len(target_physical_cores)

    # 使用 Manager 队列在进程间安全传递核心分配清单
    manager = Manager()
    core_queue = manager.Queue()
    for core in target_physical_cores:
        core_queue.put(core)

    print(f"=== 主进程启动:初始化 {worker_count} 个隔离 Worker 进程池 ===")
    with Pool(processes=worker_count, initializer=worker_init, initargs=(core_queue,)) as pool:
        # 并发分发 6 个批次计算任务
        tasks = list(range(1, 7))
        results = pool.map(heavy_compute_task, tasks)

    print("\n=== 并发执行结果汇总 ===")
    for res in results:
        print(res)

if __name__ == "__main__":
    main()
该架构彻底根除了多进程环境下的跨核抢占、CPU 上下文切换损失以及 L1/L2 缓存污染,使得批处理任务的耗时极度平稳,整体并行计算效率提升显著。
七、执行流程与结果自检验证方法
完成代码层面的绑核之后,必须通过多维度工具进行结果交叉验证,确保亲和性设置未被操作系统底层策略重置。
- 代码运行时读回校验:在计算循环内部定期打印
psutil.Process().cpu_affinity(),确保列表始终仅包含预设核心编号。 - PowerShell 命令行批量核对:在 Windows PowerShell 终端中执行以下命令,实时查询当前所有活跃 Python 进程的处理器掩码:
其返回的Get-Process -Name python | Select-Object Id, ProcessName, ProcessorAffinityProcessorAffinity为十进制数字。例如绑核[2, 4]时,对应的输出应精确为20(即0x14)。 - Windows 资源监视器(resmon.exe)波形监控:按下
Win + R运行resmon,切换至“CPU”选项卡。在右侧展开每个逻辑处理器的负载曲线。当高负载任务运行时,应当观察到被绑定的特定核心(如 CPU 2)利用率稳步达到 100%,而未绑定的其他相邻超线程保持低功耗静默状态。
八、注意事项与避坑指南
- 避让 CPU 0:Windows 系统的硬件中断请求(IRQ)、延迟过程调用(DPC)以及图形窗口管理服务(DWM)默认偏好在
CPU 0上排队。重度计算若强行占满 CPU 0,极易引发键鼠响应顿挫或音频掉帧。建议计算任务从CPU 2开始往后分配。 - Intel 混合异构架构(P-Core 与 E-Core):在 Intel 第 12 代及更新的酷睿平台上,CPU 划分为高性能 P核与能效 E核。P核支持超线程且拥有高频浮点单元,E核不支持超线程且缓存较小。如果追求最高单核峰值吞吐,应优先绑定 P核编号,避免将关键流水线误锁在能效小核上。
- 超大核心数与处理器组(Processor Groups):当 Windows Server 系统的逻辑核心总数超过 64 时,内核会启用处理器组机制(每组最多 64 核)。标准的
SetProcessAffinityMask仅对进程当前所属的 Group 0 生效。若需跨组绑定,需调用进阶的SetThreadGroupAffinityAPI。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









