

Python中format、%和f-string在字符串拼接中的区别

在 Python 中,字符串格式化经历了三代技术演进:最早期的 % 百分号操作符、Python 2.6 引入的 str.format() 方法,以及 Python 3.6 带来的 f-string(格式化字符串字面量)。这三者在语法直观性、底层字节码机制、运行性能、高级表达能力及安全边界上有着本质区别。在现代 Python 开发中,常规业务拼接首选 f-string,兼具最优可读性与字节码级执行速度;在需要模板解耦、动态配置或延迟渲染时选用 str.format();而 % 语法除标准库 logging 的参数惰性传递或维护遗留系统外,已不再作为推荐方案。
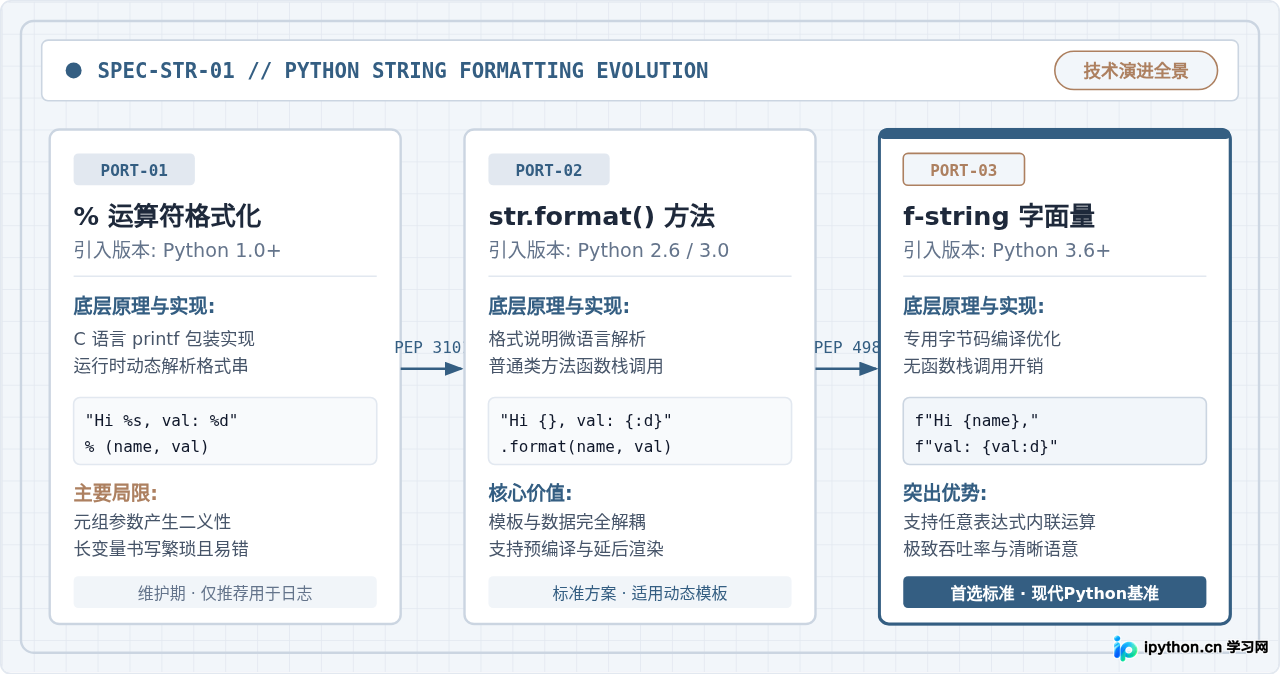
一、三种格式化语法的基本形态与直观对比
为了具体掌握三者的语法差异,我们通过一个包含变量嵌入、数值格式化以及字典提取的场景进行横向对照。
1.1 % 百分号操作符(printf 风格)
% 是 Python 最早期的字符串格式化手段,直接沿袭了 C 语言的 printf 风格。它的左侧为模板字符串,右侧为参数。当参数超过一个时,必须强制打包为元组(Tuple):
# 适用环境: Python 2.x / 3.x
user = "Alice"
score = 95.846
message = "Student: %s, Score: %.2f" % (user, score)
print(message)
主要问题与边界陷阱:% 的最大痛点在于参数解包的二义性。如果我们要传递的单一变量恰好是一个元组,Python 会误以为我们要将元组展开传入各个占位符,从而抛出 TypeError:
point = (10, 20)
# 错误写法: 抛出 TypeError: not all arguments converted during string formatting
# msg = "Coordinates: %s" % point

# 正确写法必须额外包装单元素元组:
msg = "Coordinates: %s" % (point,)
print(msg)1.2 str.format() 方法
Python 2.6 和 3.0 正式引入了 str.format()(PEP 3101)。它彻底移除了 % 对元组的依赖,采用大括号 {} 作为占位符,支持位置序号、关键字参数,以及直接读取对象的属性或字典键:
# 适用环境: Python 2.6+ / 3.x
user = "Bob"
score = 88.5
data = {"city": "Beijing", "role": "Engineer"}

# 位置传参与格式化控制
msg1 = "User: {0}, Score: {1:.1f}".format(user, score)

# 键值传参与属性提取
msg2 = "Role: {role}, City: {city}".format(**data)
print(msg1)
print(msg2)
format() 的核心优势在于模板可复用。我们可以将带有占位符的格式化字符串作为一个静态变量长期保存在配置项或数据字典中,在后续程序生命周期中按需多次调用 .format() 填充数据。
1.3 f-string 格式化字符串字面量
Python 3.6 带来了 f-string(PEP 498)。以小写 f 或大写 F 开头,大括号内部直接写入当前的变量名。它消除了在字符串末尾按顺序寻找传参对应关系的阅读负担:
# 适用环境: Python 3.6+
user = "Charlie"
score = 92.357
message = f"User: {user}, Score: {score:.2f}"
print(message)
f-string 的视觉流是单向的——代码写在哪里,变量就在哪里被读入并格式化。
二、底层实现机制与执行性能差异
许多开发者误以为 f-string 仅仅是 str.format() 的一种“语法糖”。实际上,它们在 CPython 解释器底层的 AST(抽象语法树)解析与字节码生成策略截然不同。
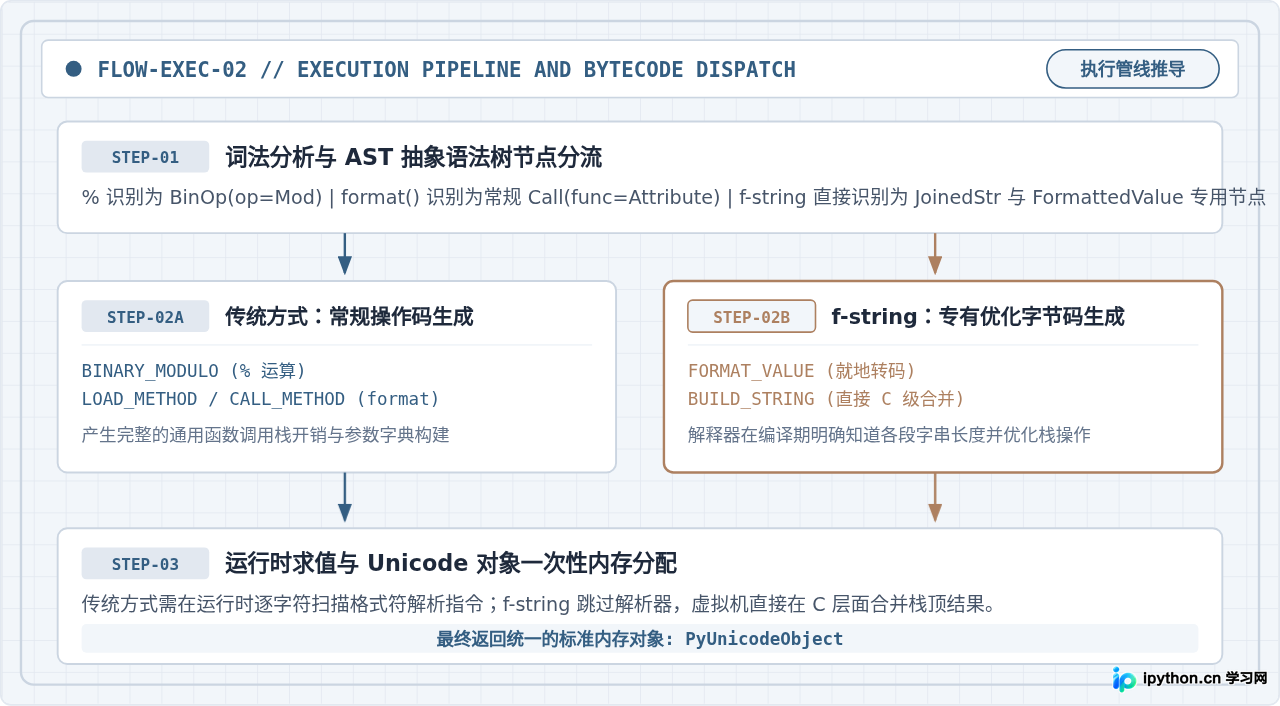
2.1 字节码指令对比(dis 模块实证)
通过 Python 标准库的 dis 模块,我们可以直接查看底层字节码指令的差异:
# 执行环境: Python 3.10+
import dis

name = "World"
print("=== % 运算符指令 ===")
dis.dis('"Hello %s" % name')

print("\n=== format() 指令 ===")
dis.dis('"Hello {}".format(name)')

print("\n=== f-string 指令 ===")
dis.dis('f"Hello {name}"')从字节码中可以清晰观察到:
format()产生了LOAD_METHOD和CALL_METHOD,这代表它完整走了一次 Python 的方法查找、参数入栈、创建栈帧以及退出栈帧的标准函数调用流程。f-string没有触发任何函数调用。编译器直接发射了FORMAT_VALUE和BUILD_STRING这两个底层的专用 CPython 操作码。它将常量'Hello '和变量name压入栈顶后,由底层 C 代码直接分配一次内存缓冲区完成拼接。
2.2 执行性能基准测试
为了验证底层指令差异带来的实际耗时影响,我们使用 timeit 模块在相同的环境下执行 1,000,000 次基准测试:
# 执行环境: Python 3.10 / macOS / Apple Silicon
import timeit

setup = 'name = "Dev"; count = 42'
t_mod = timeit.timeit('"User: %s, ID: %d" % (name, count)', setup=setup, number=1000000)
t_fmt = timeit.timeit('"User: {}, ID: {:d}".format(name, count)', setup=setup, number=1000000)
t_fst = timeit.timeit('f"User: {name}, ID: {count:d}"', setup=setup, number=1000000)

print(f"% 运算符耗时: {t_mod:.4f} 秒")
print(f"format() 耗时: {t_fmt:.4f} 秒")
print(f"f-string 耗时: {t_fst:.4f} 秒")
在纯拼接场景下,f-string 的执行速度大约是 format() 的 3.3 倍,是 % 运算符的 2.3 倍。
三、高级表达能力与语法特性对比
除性能外,三者在日常开发中的实用性还取决于其能够支持的高级表达能力。
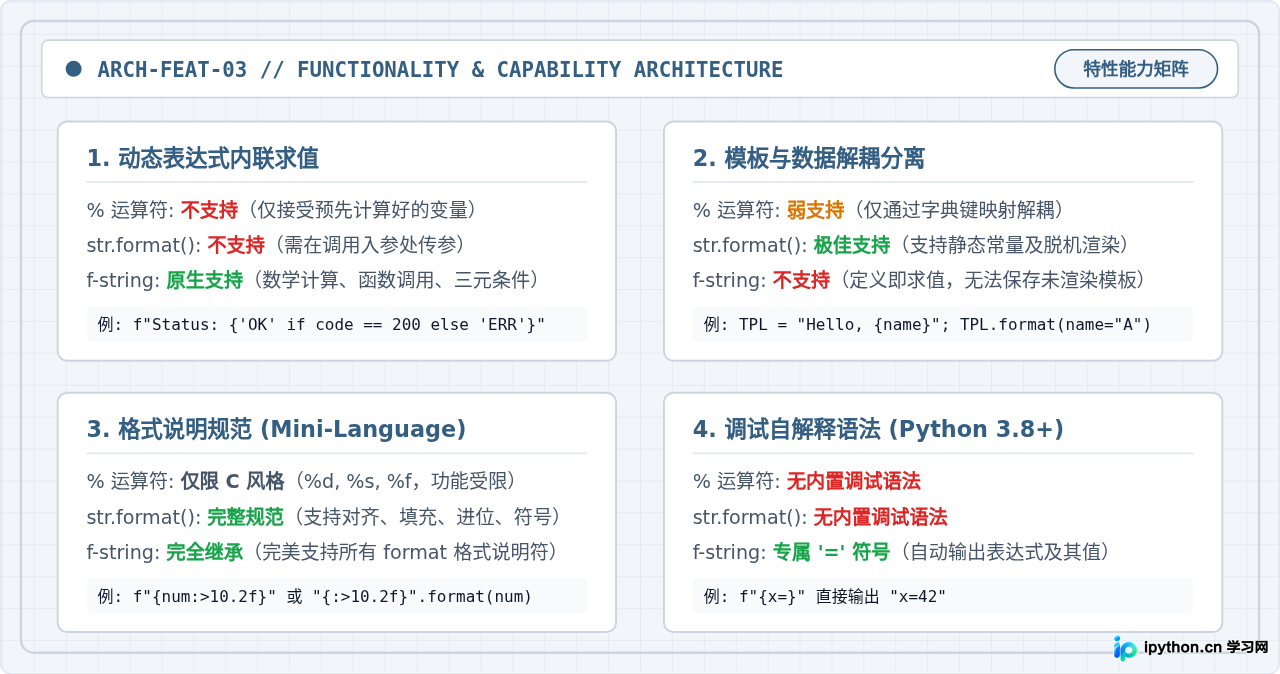
3.1 任意表达式与内联计算
f-string 的大括号内部不仅仅是变量占位符,它可以是合法的 Python 表达式:
# 适用环境: Python 3.6+
width = 12
height = 8

# 直接内联数学运算与函数调用
info = f"Area: {width * height}m², Title: {'report'.upper()}"
print(info)
如果要使用 % 或 str.format() 实现相同效果,必须在调用入参处进行计算,导致调用签名冗长且阅读不连贯。
3.2 调试语法(Python 3.8+ 等号说明符)
在 Python 3.8 及更高版本中,f-string 支持在变量或表达式后追加 = 符号,自动展开为变量名、等号与当前值:
# 适用环境: Python 3.8+
speed = 120.5
mode = "FAST"

# 调试语法输出
print(f"{speed=}, {mode=}")四、安全性、边界场景与工程选型决策
在工程实践中,盲目选用某种方案可能会引发安全漏洞或性能倒退。需要结合应用场景做出明确判断。
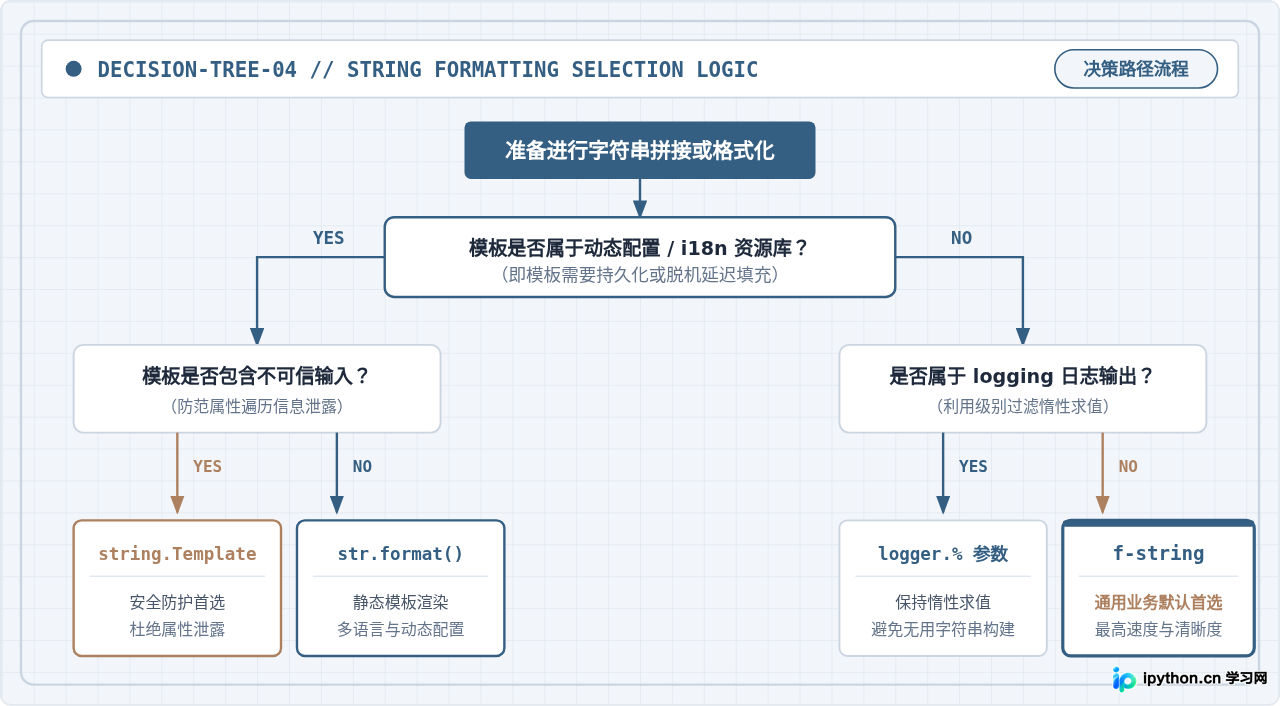
4.1 外部模板注入的安全边界
警告:绝不能将未经审查的用户输入直接作为 str.format() 的格式化模板!
因为 format() 拥有访问对象内部属性的能力。如果攻击者控制了模板字符串,他们可以通过属性遍历轻松读取敏感全局变量:
# 危险示例: 外部不可信模板直接注入
user_input_template = "{user.__init__.__globals__[SECRET_KEY]}"

class User:
    pass

SECRET_KEY = "SUPER_SECRET_TOKEN_DO_NOT_LEAK"
u = User()

# 攻击者通过属性链获取到了 SECRET_KEY
leaked = user_input_template.format(user=u)
print("泄露数据:", leaked)
安全解决方案:如果业务确实需要用户自定义消息模板,应当使用标准库的 string.Template。它只允许简单的 $var 替换,从根本上隔离了属性链访问风险。
4.2 Logging 场景下的惰性求值考量
在调用标准库 logging 打印日志时,常常看到官方推荐 logger.info("msg: %s", value),而不是 logger.info(f"msg: {value}")。
其关键原因在于惰性求值(Lazy Evaluation):
- 使用
f-string时,即使当前日志级别被设置为WARNING,logger.debug(f"{heavy_calc()}")也会在传入方法前立即计算表达式并分配字符串内存,造成无谓的性能开销。 - 使用
logger.debug("Result: %s", heavy_calc)时,logging 库会先核对当前级别是否开启。如果未开启,直接返回,永远不会触发格式化操作。
五、全景技术总结与选型速查表
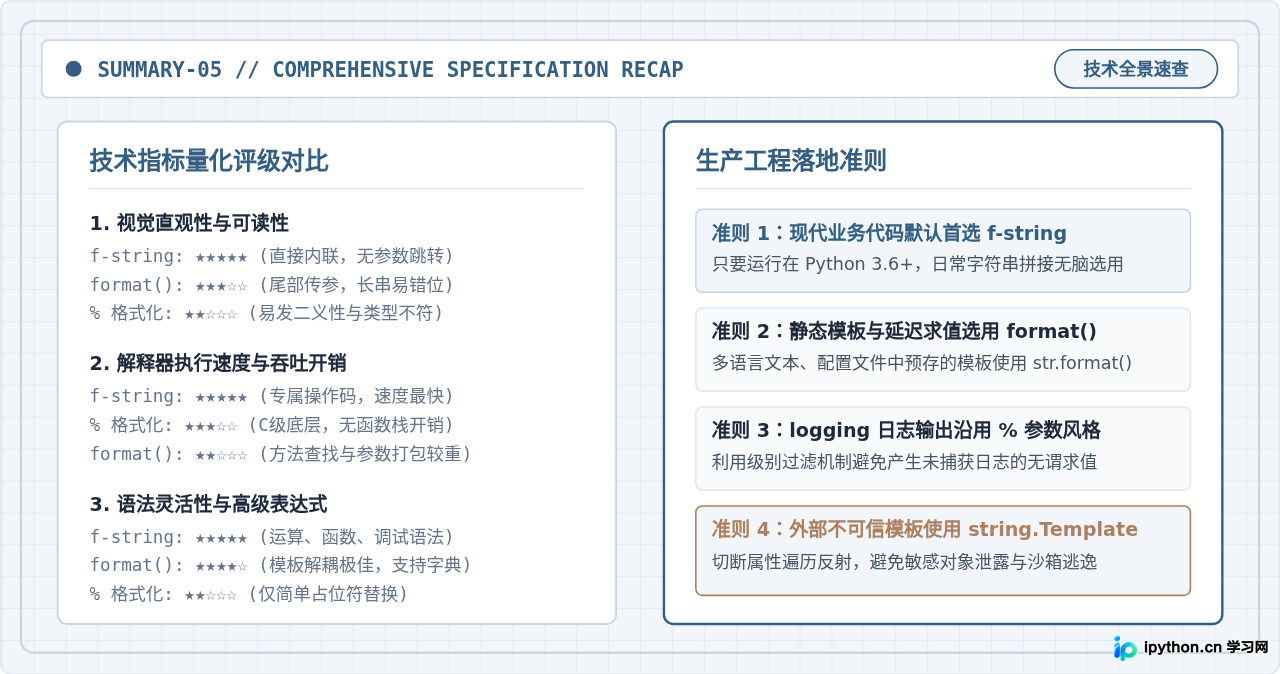
5.1 核心技术指标对比速查表
| 特性维度 | % 运算符 | str.format() 方法 | f-string 字面量 |
|---|---|---|---|
| 引入版本 | Python 1.0+ | Python 2.6 / 3.0+ | Python 3.6+ |
| 语法结构 | "%s: %d" % (k, v) |
"{}: {:d}".format(k, v) |
f"{k}: {v:d}" |
| 底层实现机制 | BINARY_MODULO C级处理 |
LOAD_METHOD + CALL_METHOD 函数栈 |
FORMAT_VALUE + BUILD_STRING 专用优化 |
| 相对性能 | 中等(比 format 快) | 较慢(函数栈开销高) | 极快(较 format 快约 2~3 倍) |
| 表达式求值 | 不支持(仅支持外部传参) | 不支持(仅支持外部传参) | 支持任意合法 Python 表达式 |
| 模板与数据解耦 | 较弱(依赖字典映射) | 优秀(支持静态保存与多次填充) | 不支持(定义处立即求值) |
| 调试语法支持 | 无 | 无 | 支持 f"{var=}" 自动解释展开 |
| 推荐应用场景 | logging 日志参数(惰性求值) |
配置文件、i18n 资源库、脱机模板 | 常规业务开发所有格式化首选方案 |
在现代 Python(3.6+ 及更高版本)开发中,f-string 已经成为绝大多数场景下的事实标准,它不仅能够消除繁重的阅读跳转,还能借助底层 CPython 专用操作码带来实打实的性能提升。当面对模板必须独立于数据存储(例如存入数据库、国际化 PO 文件或 JSON 配置文件)的特殊需求时,应当选用 str.format();如果模板来自不可信用户输入,则须切换至 string.Template。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









