

Python f-string、format与%格式化在字符串拼接中的区别

在 Python 中实现字符串拼接与变量填充,主要有三种主流方式:早期的 % 操作符(printf 风格)、Python 2.6 与 3.0 引入的 str.format() 方法,以及 Python 3.6 引入的 f-string(格式化字符串字面量)。这三者在执行性能、书写可读性、底层机制和适用边界上有着明确差异:现代日常业务开发首选 f-string,其就地编译求值速度最快且语法最清晰;而在多语言国际化或外部动态模板场景中,str.format() 能实现模板与数据解耦;% 操作符除在标准库日志模块保持延迟求值外,常规代码中已不推荐作为新语法使用。
一、三种格式化机制的语法形态与核心差异
字符串格式化本质上是把动态变量或表达式结果,嵌入到一段预先设定的字符串文本骨架中。随着 Python 语言的发展,格式化语法的演进目标始终是兼顾“可读性”、“灵活性”与“运行效率”。
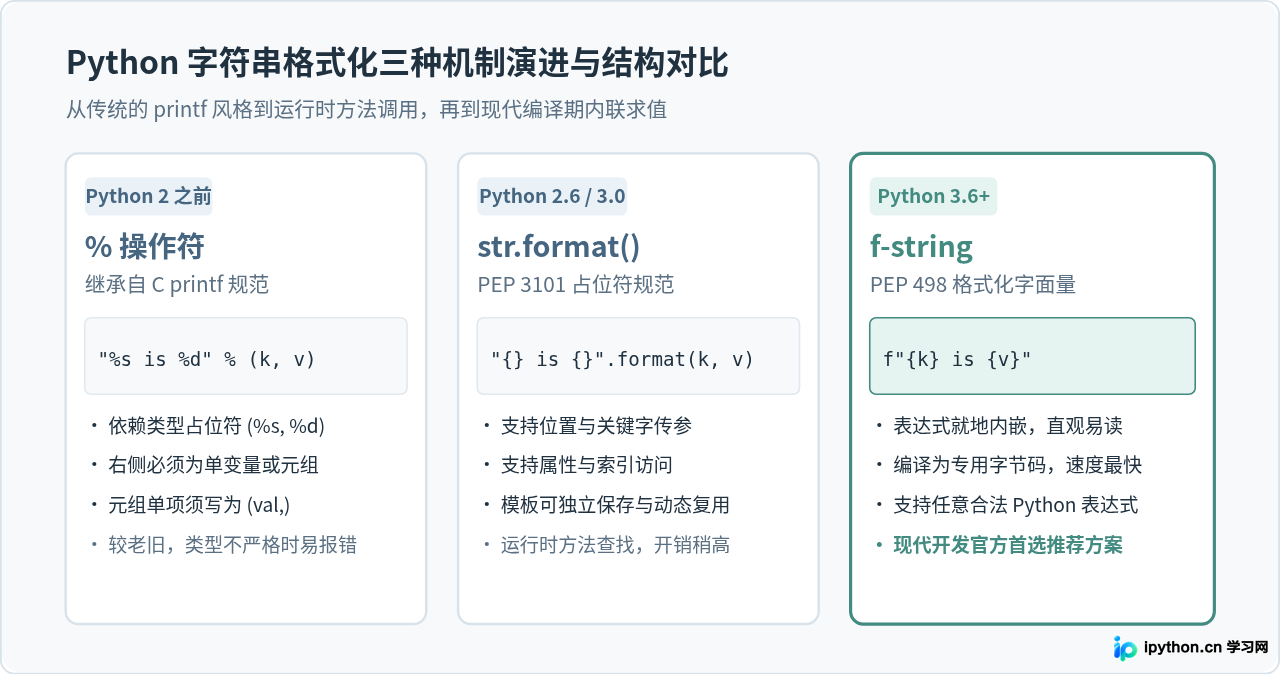
1. % 操作符格式化
% 格式化完全沿用了 C 语言 printf 系列函数的语法设计。字符串左侧是包含占位符的模板,右侧通过 % 操作符连接单个变量或一个元组:
name = "Alice"
count = 3
price = 19.5

# 基础单变量与多变量传参
text_simple = "用户: %s" % name
text_multiple = "用户: %s, 购买数量: %d, 单价: %.2f" % (name, count, price)
语法痛点与边界陷阱:当格式化右侧只有一个变量,而这个变量恰好是一个元组时,很容易引发严重运行时异常。例如对于坐标数据 point = (10, 20),执行 "坐标: %s" % point 会报错 TypeError: not all arguments converted during string formatting。原因在于 Python 解释器默认将右侧的元组展开作为多个占位符的参数来源。为了安全传递元组,必须手动将其包裹为单元素元组 "坐标: %s" % (point,),这极易引发隐蔽的边界 Bug。
2. str.format() 方法
为了解决 % 语法的参数类型脆弱性和表达能力受限问题,PEP 3101 引入了 str.format() 方法。它使用大括号 {} 作为替换字段,支持更加灵活的传参和属性访问机制:
# 自动位置匹配与显式索引匹配
text_auto = "{} 购买了 {} 件商品".format(name, count)
text_index = "{0} 购买了 {1} 件商品,欢迎下次光临 {0}".format(name, count)

# 关键字参数与对象属性访问
user_info = {"city": "北京", "vip": True}
text_named = "城市: {city}, VIP身份: {vip}".format(**user_info)
str.format() 的核心设计优势是模板与数据解耦。模板本身只是一个标准的 Python 字符串对象,可以在不同函数之间传递,或者直接存储在外部 JSON、YAML 以及数据库配置中,在需要渲染时动态调用 .format() 填充数据。
3. f-string 格式化字面量
PEP 498 提出的 f-string 是 Python 3.6 带来的重磅特性。在字符串引号前增加 f 或 F 前缀后,大括号内可以直接内嵌任意合法的 Python 表达式:
# 直接内嵌变量、算术表达式与函数调用
message = f"用户 {name.upper()},应付总额: {count * price:.2f} 元"

# 复杂内嵌与字典访问(注意引号嵌套)
user = {"name": "Bob", "role": "admin"}
user_desc = f"用户角色为: {user['role']}"
与前两者相比,f-string 完全避免了“左侧看模板,右侧逐一核对参数位置”的割裂阅读体验。代码编写直观连贯,是现代 Python 官方最为推荐的日常字符串格式化方式。
二、底层处理与执行步骤流程
理解这三种语法差异的另一个关键维度在于执行流程:Python 解释器究竟是在什么时候解析字符串、计算表达式以及分配内存的?
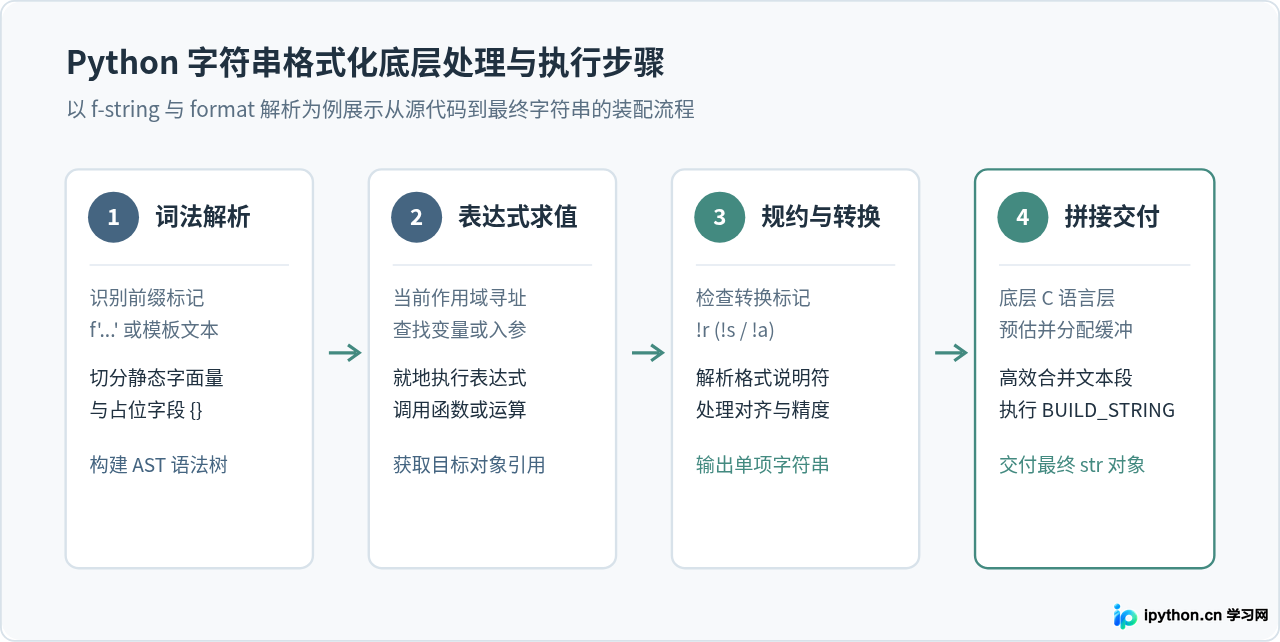
整个处理过程可以拆解为四个具体步骤:
- 步骤一:词法与语法解析(Parsing):解释器在读取代码时,遇到带有
f前缀的字面量会将其切分为若干静态字符串常量与表达式节点(FormattedValue)。若是format(),模板在编译期仅被视作普通字符串,其大括号结构直到运行时调用函数时才逐字符解析。 - 步骤二:表达式寻址与求值(Evaluation):
f-string的表达式直接在当前的局部作用域或全局作用域内执行求值指令(通过LOAD_FAST等操作码),无需像format()那样通过函数传参打包 tuple 或 dict。 - 步骤三:格式规约与转换处理(Conversion & Spec):如果指定了
!s、!r或!a,系统会先对对象执行str()、repr()或ascii()转换;接着解析冒号后的格式说明符(如.2f或05d),调用对象底层的__format__C 级实现生成格式化文本。 - 步骤四:字符串缓冲合并(Concatenation):解释器底层通过 C 语言预先计算或动态扩展一段内存缓冲区,将所有字面量片段与格式化后的变量字符串拼接在一起,最终生成目标
str对象并压入栈顶。
三、格式控制说明符(Format Specifiers)的规范演进
在数值精度、对齐补白和进制格式化等细节控制上,str.format() 与 f-string 完全统一遵循 PEP 3101 定义的“格式说明符微型语言”(Format Specification Mini-Language),而 % 操作符则严格受限于 C 语言传统的 printf 规范。
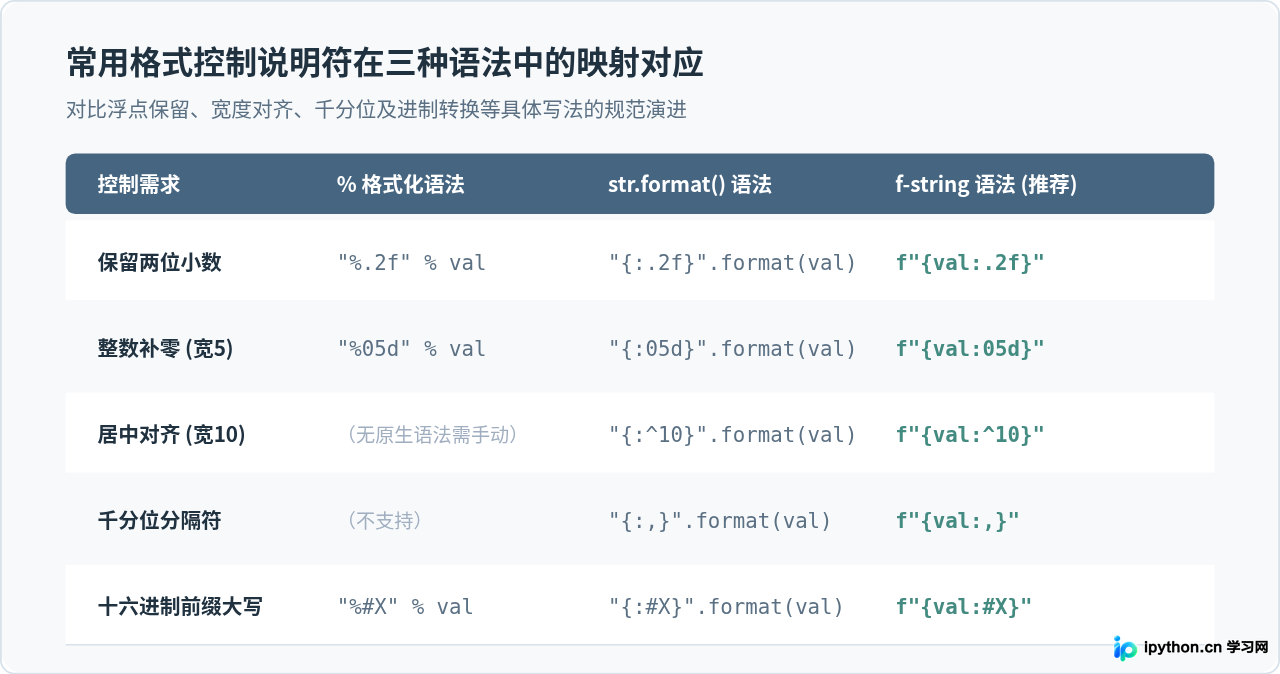
从对比中可以看出现代格式规约(PEP 3101)的重要改进:
- 对齐与填充字符:在
%语法中,仅支持使用-标志实现左对齐,居中对齐完全无法原生表达;而在str.format()与f-string中,可以通过<、^、>指定任意填充字符和对齐方向,例如f"{'标题':*^20}"会生成以星号居中填充的 20 字符宽度文本。 - 千分位与下划线:现代金融与报表开发中常用的逗号
,或下划线_千分位,在%语法中没有原生支持;现代语法直接书写{val:,}即可完成。 - 自文档化调试语法(Python 3.8+):
f-string独享的便捷特性是等号调试语法。例如书写f"{name=}, {count=}",输出会直接自动展开为name='Alice', count=3,极大简化了日常日志和终端排错的代码编写。
四、底层字节码分析与执行性能对比
为了直观展现三者的性能差异根源,我们可以使用 Python 标准库的 dis 模块反编译三段执行相同拼接逻辑的代码:
import dis

def test_percent(name, age):
    return "%s is %d" % (name, age)

def test_format(name, age):
    return "{} is {}".format(name, age)

def test_fstring(name, age):
    return f"{name} is {age}"
观察底层字节码的生成差异:
test_percent:编译器构建一个包含局部变量的元组,随后调用BINARY_MODULO操作码。虽然操作码本身较快,但需要在 Python 堆上临时构造一个 tuple 对象。test_format:需要执行LOAD_ATTR(在字符串对象上查找format方法属性),将参数压栈,然后调用CALL_METHOD或CALL_FUNCTION。函数调用引入了栈帧切换和参数打包开销,因而性能在三者中最慢。test_fstring:编译器在词法分析阶段就识别了插值结构,直接生成FORMAT_VALUE操作码对变量执行快速转换,随后调用BUILD_STRING指令。这一过程完全由 C 语言底层在栈上完成缓冲合并,没有函数查找与中间对象开销。
使用 timeit 在 Python 3.11 环境下执行 1,000,000 次循环的基准耗时表现如下:
| 格式化方式 | 示例语法 | 典型百万次执行耗时 (秒) | 相对性能比例 |
|---|---|---|---|
| f-string | f"{name} is {age}" |
约 0.038 s | 基准 (最快,100%) |
| % 格式化 | "%s is %d" % (name, age) |
约 0.076 s | 约 2.0x 耗时 |
| str.format() | "{} is {}".format(name, age) |
约 0.115 s | 约 3.0x 耗时 |
实测表明,f-string 的执行速度明显快于另外两种方案,通常是 format() 的 2.5 到 3 倍左右,比 % 操作符快约 1.5 到 2 倍。
五、工程场景选型路径与避坑指南
虽然 f-string 在性能和书写体验上处于全面领先地位,但在实际工业级软件项目中,不能机械地“一刀切”替换所有场景。必须根据具体业务需求进行技术选型。
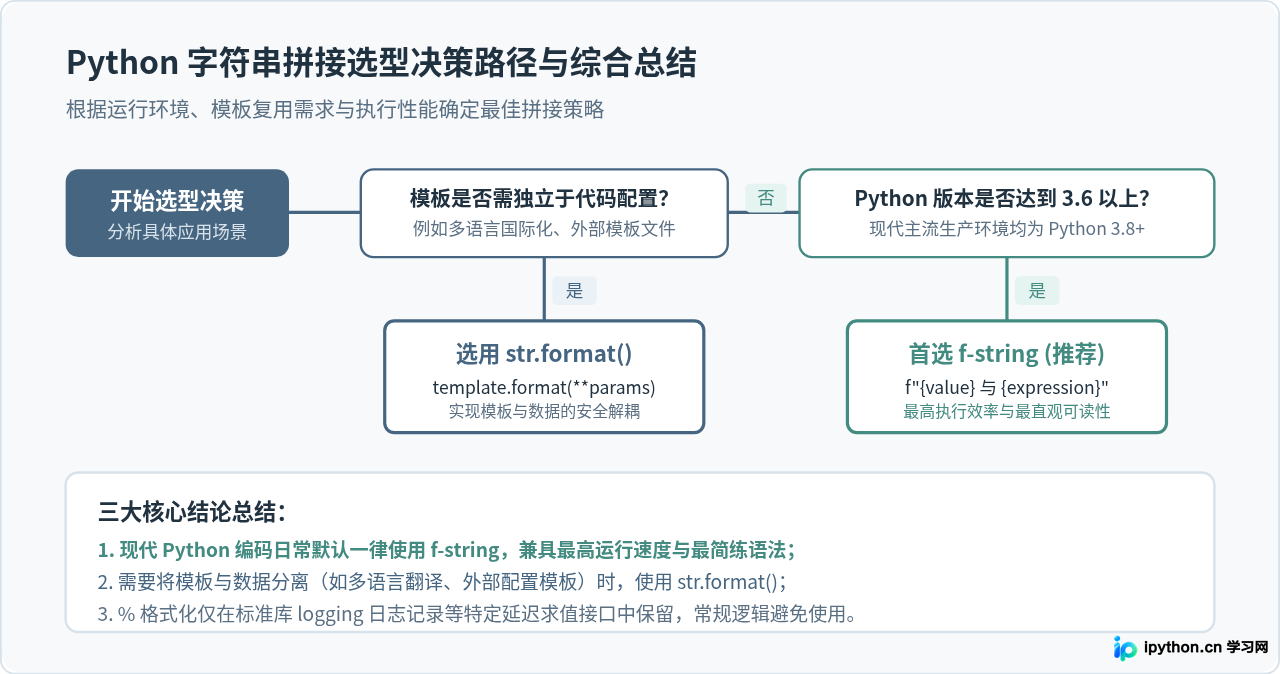
1. 典型应用场景对照
- 场景 A:日常逻辑、数据处理与接口调用(首选 f-string)
在业务逻辑、数据流水线清洗、API 客户端封装中,格式化内容与当前上下文紧密关联,使用f-string拥有最好的代码维护性和性能表现。 - 场景 B:国际化多语言与外部模版系统(选用 str.format)
在国际化(i18n)开发中,翻译词条通常存储在外部资源文件(如messages_en.json或.po文件)中。此时模板字符串必须在运行时动态加载,无法写死在 Python 源码中。通过template_str.format(**data)能够优雅地将翻译文本与渲染参数动态融合。 - 场景 C:标准库 logging 日志记录(保留 % 传参风格)
在生产环境日志记录时,推荐遵循logging模块的原生规范:logger.debug("处理数据条数: %s, 耗时: %s", count, cost)。这样做的好处是延迟求值(Lazy Evaluation):如果当前系统的日志级别设置为INFO,那么这条DEBUG级别的字符串格式化操作根本不会被触发执行,从而节省了不必要的 CPU 资源开销。
1. 严禁在 SQL 语句中使用任何字符串格式化或拼接:无论使用
f-string、format 还是 %,将不可信的用户输入直接拼接到 SQL 查询语句中都会导致灾难性的 SQL 注入风险。数据库查询务必使用数据库驱动提供的原生参数化查询机制(例如 cursor.execute("SELECT * FROM users WHERE name = %s", (username,)))。2. 注意大括号转义规则:在
f-string 与 format() 中,如果要输出字面量的大括号字符 { 或 },需要使用双大括号进行转义,例如 f"{{'status': 'ok'}}" 才会输出包含单个大括号的字面量文本。
综上所述,Python 提供的三种格式化机制各有历史渊源与技术专长。在现代 Python 3 项目中,日常编程优先使用 f-string 能够获得清晰优雅的表达与高效的运行时性能;在处理动态模板与国际化字典时合理辅以 str.format();而在标准库日志记录时保持对 % 延迟参数的运用,即可在代码健壮性、可读性与执行效率之间取得最佳平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









