

Python lambda匿名函数与def自定义函数的区别及应用场景

在 Python 编程中,定义可调用对象最常用的两种方式是使用 def 语句与 lambda 表达式。简单来说,def 是定义常规、完整函数的通用语法,支持多行逻辑、类型注解与文档字符串;而 lambda 是一种轻量级的单行匿名函数表达式,专为无需显式命名、逻辑简短的一次性回调而设计。本文从语法结构、底层执行机制、核心特性差异及实际应用场景出发,详细剖析两者的不同边界与选型依据。
一、语法形式与结构特征对比
def 是 Python 中的复合语句(Statement),而 lambda 是一个表达式(Expression)。这一语言层面的本质区别,决定了它们在代码组织上的诸多约束。
使用 def 定义函数时,必须声明函数名、参数列表并在缩进块中编写函数体。函数体内部可以容纳条件分支、循环、赋值语句、异常捕获等任意 Python 语句:
def add_numbers(x, y):
    """计算两个数字的和并返回结果"""
    result = x + y
return result相比之下,lambda 表达式以关键字 lambda 开头,后接用逗号分隔的参数列表,冒号后紧跟一个单独的表达式,其计算结果自动作为返回值:
# lambda 参数列表: 单个表达式
lambda x, y: x + y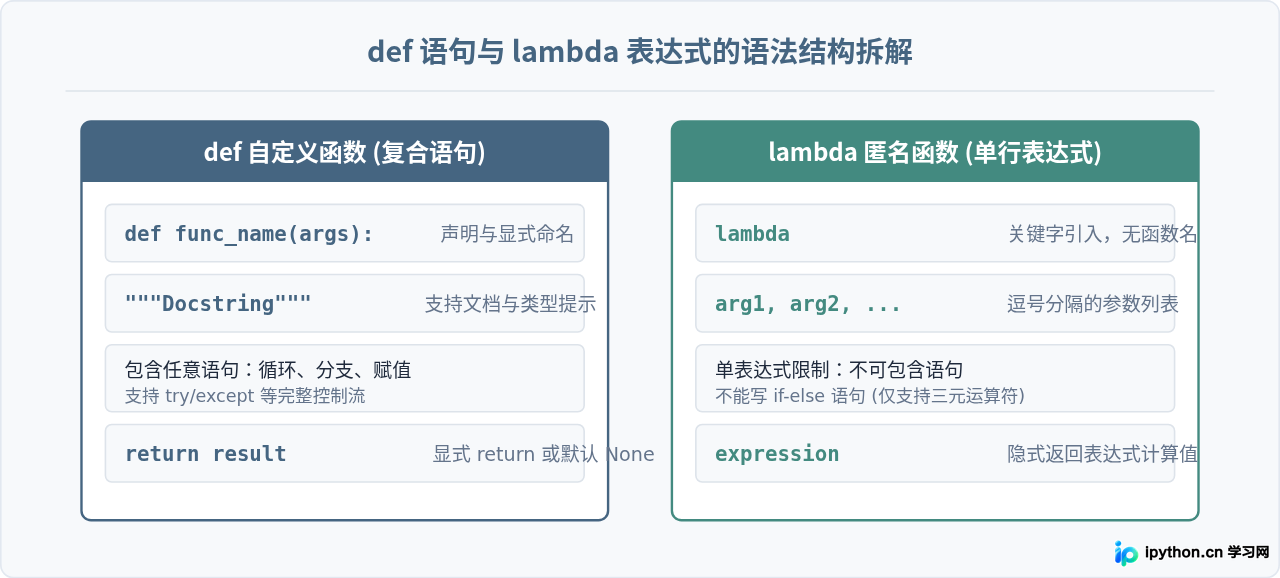
二、底层机制与语言特性差异
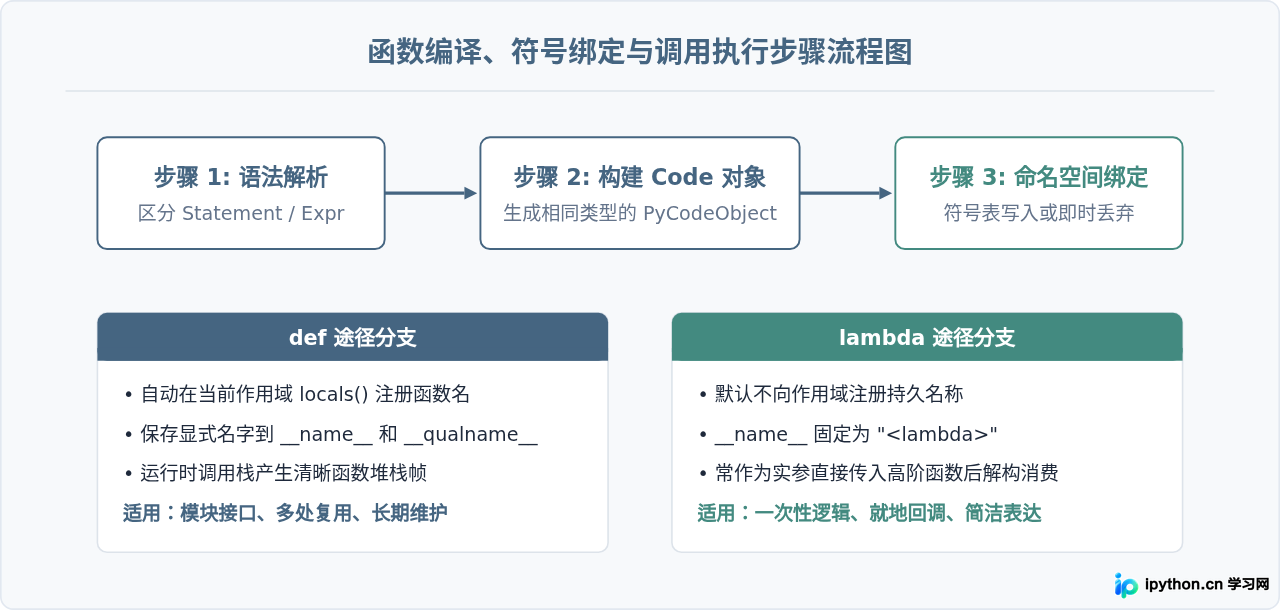
虽然 def 与 lambda 最终在 Python 虚拟机中生成的都是常规的函数对象(function 类型),但由于语法构造差异,它们在符号绑定、自省信息及调试堆栈中表现出显著不同。
1. 函数名称与标识符自省
通过 def 创建的函数,其属性 __name__ 会被自动设置为定义时的标识符。而 lambda 创建的函数对象,其 __name__ 属性固定为字符串 "<lambda>":
def standard_func(x):
    return x * 2

anonymous_func = lambda x: x * 2

print(standard_func.__name__)   # 输出: standard_func
print(anonymous_func.__name__)  # 输出: <lambda>
这一区别直接影响异常回溯(Traceback)的可读性。当程序在生产环境中抛出异常时,如果大量使用未命名的 lambda,日志中只会显示 File "...", line X, in <lambda>,排查者难以直接定位具体涉及哪一项业务逻辑。
2. 文档与类型注解支持
def 支持完整的 PEP 484 类型注解和 PEP 257 文档字符串,方便 IDE 提示与自动化静态分析工具(如 mypy)检查;而 lambda 语法不支持文档字符串,也不支持在形参和返回值中嵌入类型注解。
三、lambda 匿名函数的典型应用场景
虽然 lambda 功能受限,但在特定配合高阶函数或事件回调的场景下,它能够显著减少代码样板,避免为仅使用一次的简单转换定义大量全局或局部辅助函数。
1. 集合排序的自定义键提取 (sorted / sort)
这是 lambda 最经典且推荐的使用场景。在对复合数据结构进行排序时,利用 key 参数传入提取特定属性的 lambda 表达式:
students = [
    {"name": "Alice", "score": 88},
    {"name": "Bob", "score": 95},
    {"name": "Charlie", "score": 72}
]

# 按成绩从高到低排序
sorted_by_score = sorted(students, key=lambda s: s["score"], reverse=True)
print(sorted_by_score)
2. 函数式处理工具 (map / filter)
在对序列进行就地过滤或映射时,lambda 能保持代码紧凑:
numbers = [1, 2, 3, 4, 5, 6]

# 筛选偶数
evens = list(filter(lambda x: x % 2 == 0, numbers))

# 计算平方值
squares = list(map(lambda x: x ** 2, numbers))
注意:对于简单运算,Python 官方及 PEP 8 通常更推荐使用列表推导式(如 [x**2 for x in numbers]),其可读性往往更胜一筹。但在配合部分生成器管道或特定函数式库时,lambda 仍是不可或缺的组件。
3. GUI 事件绑定与延迟计算回调
在 Tkinter、PyQt 等桌面 GUI 开发中,按钮点击事件的 command 参数通常需要接收一个无参可调用对象。若要传递特定参数,可利用 lambda 包装:
import tkinter as tk

root = tk.Tk()
# 传递特定参数给处理函数,而非立即执行
button = tk.Button(root, text="点击", command=lambda: print("按钮被点击,ID: 101"))
button.pack()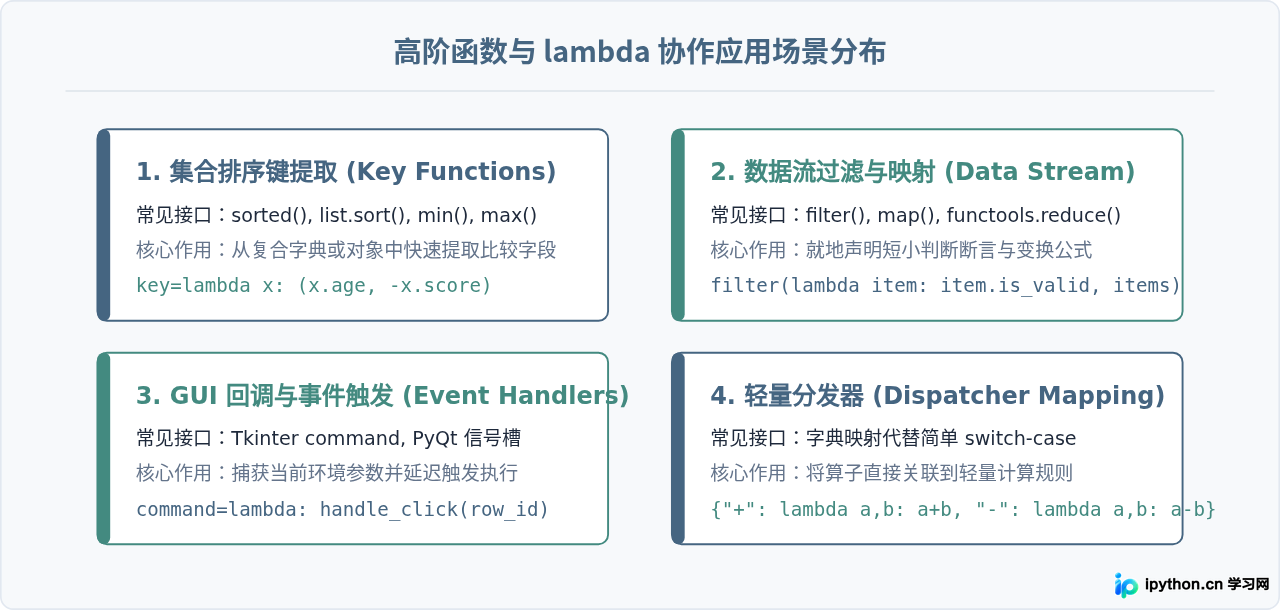
四、常见误区与反模式(Anti-Patterns)
尽管 lambda 书写简便,但在实际工程中过度或不当使用极易引发代码维护问题。以下是几个典型反模式:
PEP 8 明确指出:始终使用 def 语句,而不是将 lambda 表达式赋值给变量。
# 不推荐 (Anti-pattern)
calculate = lambda x, y: x * 2 + y

# 推荐 (PEP 8 规范)
def calculate(x, y):
return x * 2 + ylambda 赋值破坏了匿名函数的本质目的,同时剥夺了函数原本应当拥有的清晰 __name__、文档注释及可读堆栈追踪。
lambda 只能容纳单个表达式,有时开发者为了强行单行化,将多重三元条件、字典查询甚至逻辑与或运算嵌套在一起:
# 难以阅读与维护的代码
get_label = lambda x: "负数" if x < 0 else ("零" if x == 0 else ("大正数" if x > 100 else "普通正数"))def 函数,通过常规 if/elif/else 保证代码直观易懂。
在循环中生成
lambda 时,要注意晚绑定(Late Binding)问题:
funcs = [lambda: i for i in range(3)]
print([f() for f in funcs]) # 输出全部是 [2, 2, 2],而非 [0, 1, 2]funcs = [lambda i=i: i for i in range(3)]。
五、选型原则与对比总结
为了帮助在实际编写代码时快速决断,下表总结了 def 与 lambda 在关键能力维度上的具体对比:
| 特性维度 | def 自定义函数 | lambda 匿名函数 |
|---|---|---|
| 语法类别 | 复合语句 (Compound Statement) | 独立表达式 (Expression) |
| 名称标识 (__name__) | 显式定义名称,便于自省 | 固定为 "<lambda>" |
| 代码体支持 | 支持多行、循环、分支、异常捕获 | 仅限单个表达式,隐式返回值 |
| 文档与注解 | 完整支持 Docstring 与 Type Hints | 不支持 Docstring,不便写类型注解 |
| 调试堆栈 | 调用栈信息明确,易于定位问题 | 调用栈缺乏具名上下文,排查较繁琐 |
| 复用程度 | 模块级、类级或局部多次调用 | 单次、即时消费(如参数就地传递) |
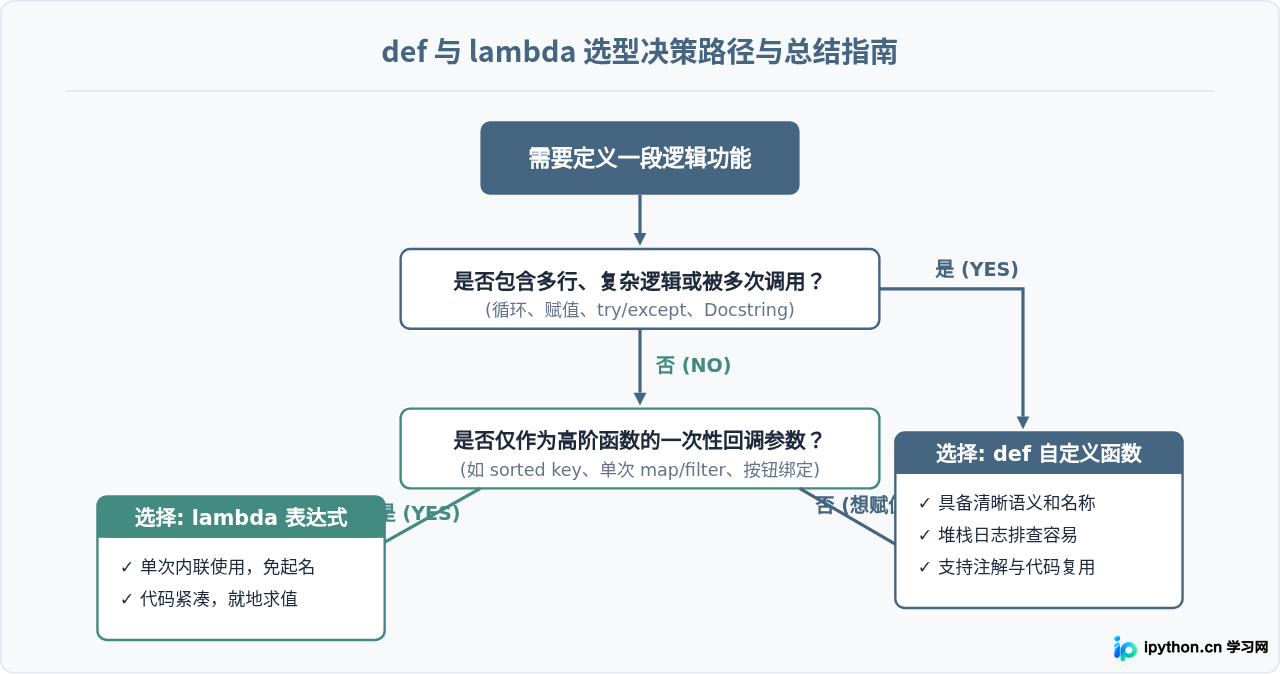
综上所述,def 是 Python 构建稳健应用的核心基石,而 lambda 是提供敏捷回调能力的有效补充。在日常开发中,只要逻辑超出一行、包含条件分支或需要重复调用,就应当始终使用 def;只有在作为简短键提取或无需命名的单次实参传递时,才选用 lambda。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









