

Python怎么快速初始化全0或全1的数组

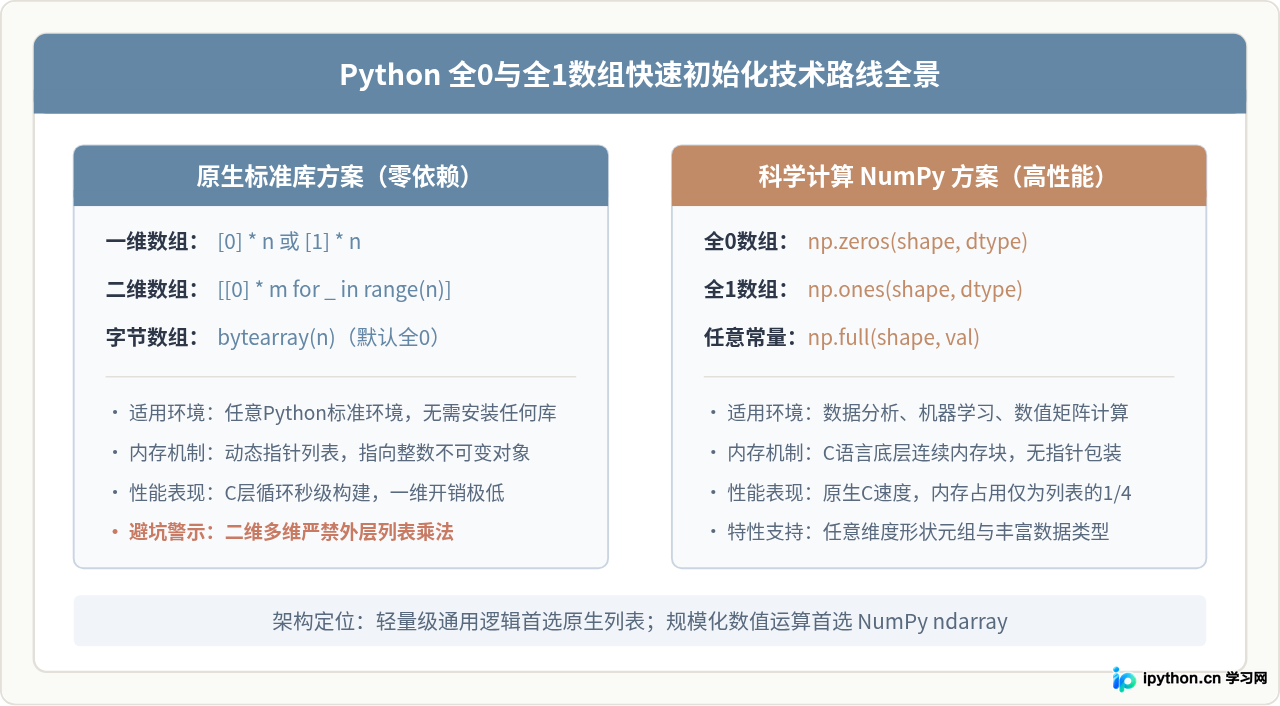
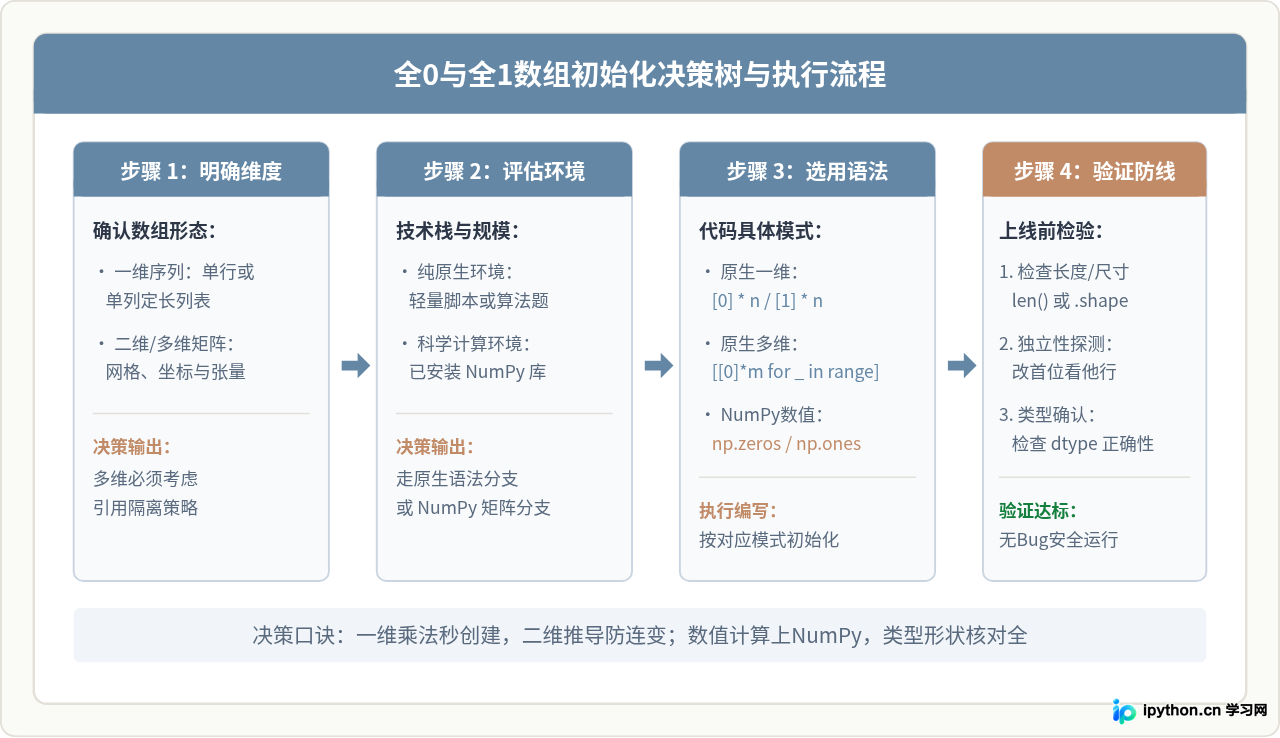
在Python开发中,初始化全0或全1的数组是一项高频基础任务。无论是在算法解题中构建动态规划表格、频次统计桶,还是在工程开发中预分配定长数据容器,选择恰当的初始化方式都直接决定了代码的运行效率与内存安全。针对这一需求,核心答案非常明确:在无需外部依赖的纯Python环境下,一维数组最快、最简洁的写法是使用列表乘法(如 [0] * n 或 [1] * n);但遇到二维或多维数组时,必须使用列表推导式(如 [[0] * cols for _ in range(rows)])以避开浅拷贝引用共享陷阱;如果处于数值计算或大数据量场景,工业级最优方案则是使用 NumPy 库的 np.zeros() 与 np.ones()。本文将逐层拆解这些方案的具体用法、底层机制与避坑关键。
一、原生 Python 快速初始化:一维数组的高效方案
在无需引入第三方库的标准Python环境中,如果需要初始化一个长度为 n 的全0或全1一维数组,最推荐的做法是利用列表乘法语法:
# 初始化长度为 8 的全0一维列表
zeros_1d = [0] * 8
print(zeros_1d)  # 输出: [0, 0, 0, 0, 0, 0, 0, 0]

# 初始化长度为 8 的全1一维列表
ones_1d = [1] * 8
print(ones_1d)   # 输出: [1, 1, 1, 1, 1, 1, 1, 1]
1. 为什么一维列表乘法又快又安全?
列表乘法 [0] * n 在CPython底层的执行流程非常高效。解释器首先在内存中开辟一段能够容纳 n 个指针的连续列表缓冲,然后直接在C语言循环中将每个位置的指针指向整数 0 的内存地址。这一过程完全绕过了Python层面的字节码循环(如 for 循环或 append 调用),其耗时为纯粹的底层连续内存填充,因而性能极佳。
许多刚接触Python的开发者会担心浅拷贝引用的问题:数组中的每个元素指向同一个对象,修改其中一个会不会影响其他元素?对于不可变数据类型(Immutable Types)如整数 0 和 1,这种担忧是不必要的。在Python中,整数是严格不可变的,且CPython在启动时会对 -5 到 256 之间的小整数进行单例常驻缓存(Small Integer Caching)。当我们执行 zeros_1d[0] = 9 时,并没有修改内存中 0 这个数字本身,而是让 zeros_1d[0] 重新指向了整数 9 的地址,其余索引位置依然保持原指向,相互之间完全独立。
2. 紧凑型字节数组:bytearray 与 array 模块
如果对内存占用有极其严苛的要求,且数据仅限于字节级别(0到255的无符号整数),Python内置的 bytearray 提供了无与伦比的初始化速度:
# 直接分配 10 个字节并默认全部置0
byte_arr = bytearray(10)
print(byte_arr)  # 输出: bytearray(b'\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00')
bytearray(n) 在底层直接通过系统的 calloc 申请已清零内存,不仅速度极快,而且每个元素精确占用 1 字节,远低于普通Python列表(每个指针占8字节加独立整数对象开销)。此外,标准库的 array 模块也支持 array.array('i', [0] * n) 形式的有符号整型连续数组。
二、二维及多维原生数组:严防浅拷贝引用陷阱
当需要初始化一个 rows 行 cols 列的二维数组(矩阵)时,很多初学者会自然而然地尝试将一维乘法嵌套使用:[[0] * cols] * rows。这是一种极具隐蔽性且后果严重的错误写法。
避坑高危警示:切勿使用 [[0] * m] * n 初始化二维数组!外层乘法复制的并不是行列表的内容,而是内层同一个列表对象的引用指针。修改其中任意一行的某一列,所有行的同一列都会发生联动修改。
# 错误示例:浅拷贝导致的连带修改 Bug
bad_matrix = [[0] * 3] * 3
bad_matrix[0][0] = 7
print(bad_matrix)
# 实际输出结果: [[7, 0, 0], [7, 0, 0], [7, 0, 0]]
# 问题现象:明明只修改了第0行,第1行和第2行却同时变成了7!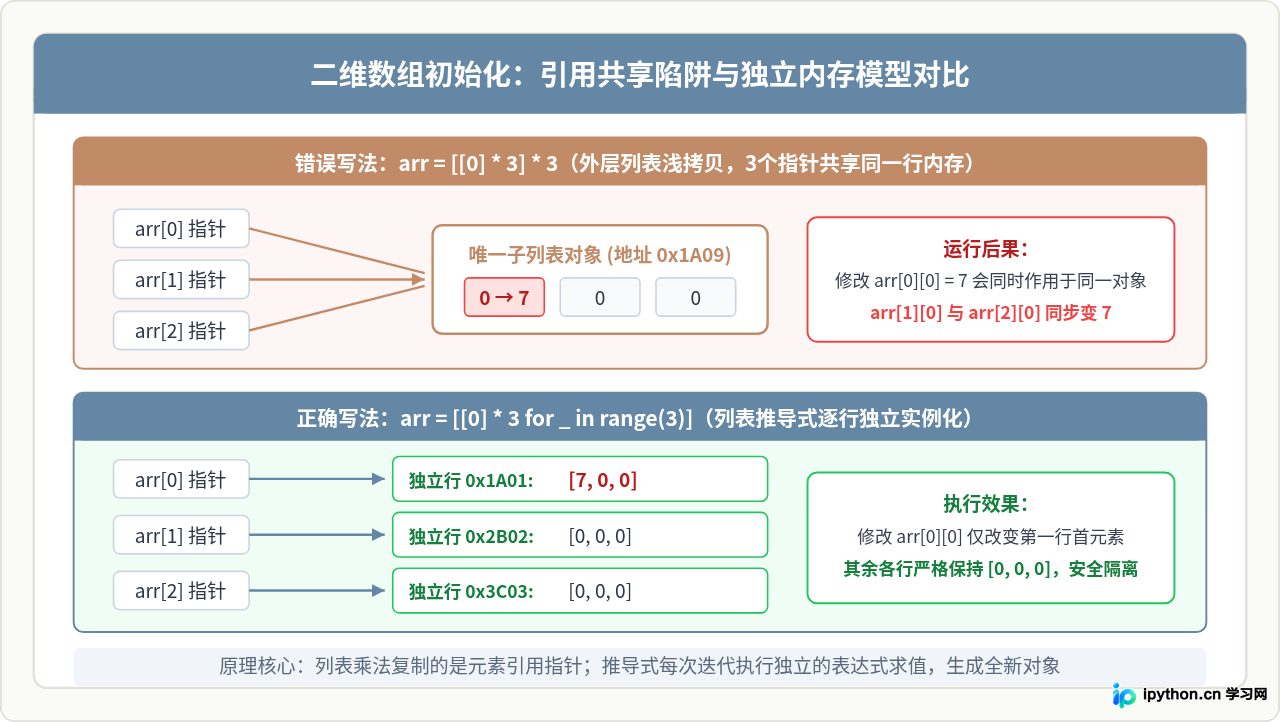
1. 正确的初始化写法:列表推导式
构建二维全0或全1数组的标准通用语法是列表推导式:
rows = 3
cols = 4

# 正确创建 3行 4列 的全0二维数组
grid_zeros = [[0] * cols for _ in range(rows)]
grid_zeros[0][0] = 7
print(grid_zeros)
# 输出: [[7, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]
# 验证:仅第0行首位被改动,其余行保持独立!

# 正确创建 3行 4列 的全1二维数组
grid_ones = [[1] * cols for _ in range(rows)]
print(grid_ones)
# 输出: [[1, 1, 1, 1], [1, 1, 1, 1], [1, 1, 1, 1]]
在这个表达式中,外层的 for _ in range(rows) 循环每执行一次,内层的 [0] * cols 就会重新求值并创建一份全新的子列表对象。外层大列表收集的是这 rows 个互不相干的独立列表引用,从而彻底杜绝了引用共享导致的连带修改Bug。
三、NumPy 高性能初始化:数值计算与多维矩阵首选
当处理大规模数据集(如数万甚至数百万个元素)或进行矩阵乘法、卷积等数学计算时,Python原生列表的劣势便会凸显:原生列表是一个“指针数组”,每个元素都包含对象头、引用计数和类型指针,不仅内存开销大,而且在内存中是非连续分布的,无法利用CPU的L1/L2高速缓存与SIMD矢量化指令。此时,NumPy库是毫无争议的最佳解决方案。
1. np.zeros 与 np.ones 的核心用法
import numpy as np

# 1. 初始化全0数组
arr_zeros_1d = np.zeros(5)               # 一维,默认浮点型: array([0., 0., 0., 0., 0.])
arr_zeros_2d = np.zeros((3, 4), dtype=int)  # 3行4列整型二维矩阵

# 2. 初始化全1数组
arr_ones_1d = np.ones(5)                 # 一维浮点型: array([1., 1., 1., 1., 1.])
arr_ones_2d = np.ones((3, 4), dtype=int)   # 3行4列整型二维矩阵

# 3. 指定布尔型(全False或全True)
arr_bool_false = np.zeros((2, 3), dtype=bool)  # 全False
arr_bool_true = np.ones((2, 3), dtype=bool) # 全True关键参数细节:np.zeros 与 np.ones 的第一个参数 shape 可以是整数(表示一维长度)或元组(表示多维各轴尺寸)。第二个关键参数 dtype 默认为 float64(64位浮点数)。如果业务逻辑需要整数或节省内存,务必显式传入 dtype=int(或 np.int32、np.int8)。
2. 拓展高效工具:np.full 与 np.empty
除 zeros 与 ones 外,NumPy还提供了两类密切相关的初始化函数:
np.full(shape, fill_value):用任意指定常数值填充整个数组。例如np.full((2, 3), 0)等价于zeros,但能灵活适应任意初值。np.empty(shape, dtype)+ 写入:empty仅在内存中分配空间而不初始化内存内容(包含随机内存垃圾数据)。如果接下来马上要对整个数组进行遍历覆盖,使用empty速度最快;结合arr.fill(0)也能达到全0初始化的目的。
四、不同初始化方式的性能对比与选型建议
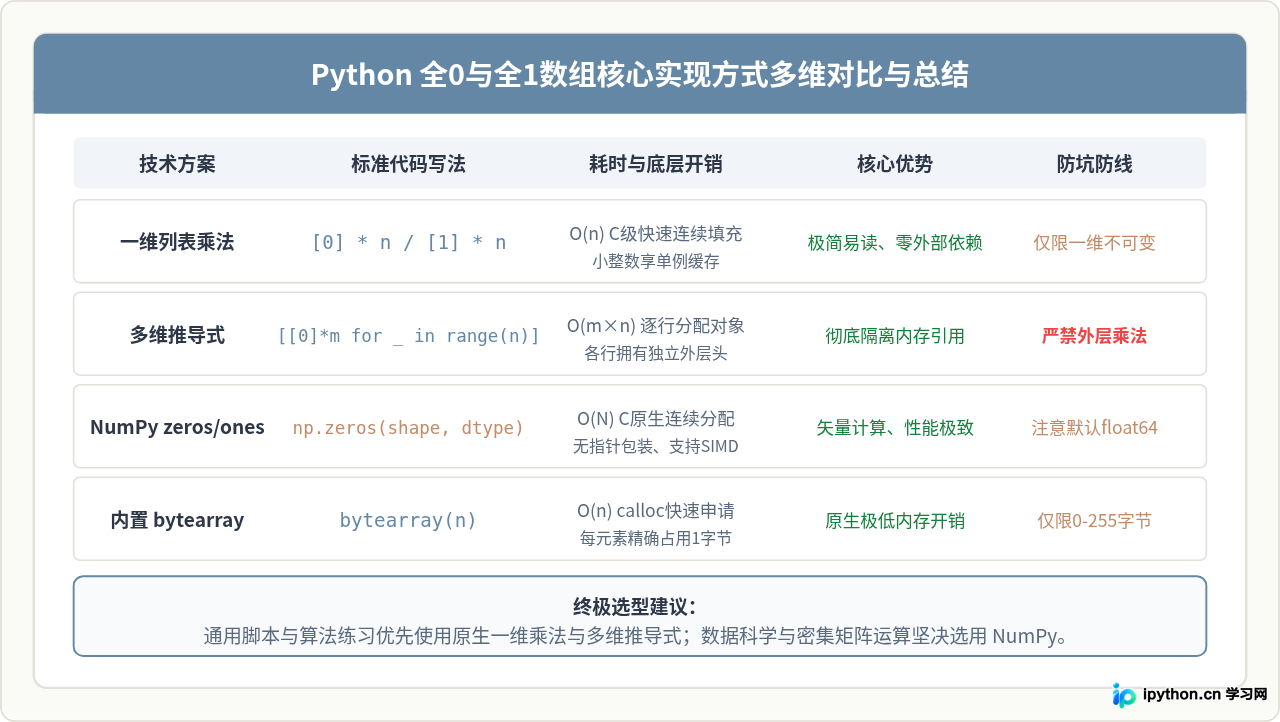
为了让不同场景下的选型依据更加清晰,我们需要从执行耗时、内存占用、语法复杂度与适用边界四个维度对上述方案进行综合对比:
| 初始化方式 | 典型代码示例 | 时间复杂度 | 单元素内存开销 | 最适场景与限制 |
|---|---|---|---|---|
| 一维列表乘法 | [0] * n / [1] * n |
O(n)(C级循环,极快) | 8字节(指针)+ 小整数单例 | 原生Python一维定长数组;仅适用于不可变元素。 |
| 多维列表推导式 | [[0] * m for _ in range(n)] |
O(m×n)(逐行分配) | 每行需独立列表头开销 | 原生Python二维/多维矩阵;彻底隔离行引用。 |
| NumPy zeros/ones | np.zeros((m, n), dtype=int) |
O(m×n)(连续内存,微秒级) | 1~8字节(由dtype决定,无指针) | 大数据量、矩阵代数、科学计算与AI;需第三方依赖。 |
| 内置 bytearray | bytearray(n) |
O(n)(calloc直接申请) | 1字节(极致紧凑) | 底层二进制I/O、网络包缓冲;仅限0~255单字节数值。 |
五、常见问题排查与注意事项
- 全0或全1布尔数组的优雅初始化:在算法题中,常需要将访问标记数组初始化为全
False或全True。由于在Python底层False == 0且True == 1,原生语法同样可以使用[False] * n与[True] * n;而在NumPy中,推荐直接传入dtype=bool,如np.zeros(n, dtype=bool)与np.ones(n, dtype=bool)。 - NumPy 默认数据类型的隐式转换:初学者常忽略
np.zeros(5)默认生成的是浮点型数组[0., 0., 0., 0., 0.]。如果在后续代码中期望进行纯整数运算或用作字典键/索引,务必记得指定dtype=int,避免隐式浮点运算带来额外的性能损耗或意外类型错误。 - 动态扩展时的预分配原则:如果数组最终长度已知,尽量使用本文介绍的乘法、推导式或 NumPy 预先分配好固定大小并根据索引赋值,避免在循环体内频繁调用
append()。预分配能够一次性完成内存申请,省去列表多次自动扩容(Over-allocation)和数据迁移的系统开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









