

Python中用rsplit和切片提取字符串后几位的对比

假设我们正在处理一批形如 "order_20261007_A98F" 的业务编号,或者包含文件扩展名的路径字符串,目标是获取末尾的特定标识或固定位数的后缀。Python 中完成这一需求最常被提及的两个工具是切片(Slicing)和 rsplit() 方法。尽管两者经常被放在同一场景下讨论,但它们底层的解析逻辑截然不同:切片基于绝对物理偏移量,而 rsplit() 基于语义分隔符。本文将具体剖析两者的实现语法、边界行为、运行效率,并给出明确的技术选型标准。
一、原理机制与基础语法
在 Python 中,提取末尾内容通常分为两类诉求:一类是“严格截取最后 N 个字符”,另一类是“截取由某个分隔符界定的最后一段数据”。理解这两者的区别是选用合适方法的前提。
1. 字符串切片:按固定字符数量截取
切片是 Python 原生序列操作,其语法为 str[start:end:step]。当需要提取末尾字符时,使用负索引即可指定从倒数第几个字符开始截取,直至末尾。
# 提取后 4 位字符
text = "order_20261007_A98F"
result = text[-4:]
print(result)切片在 CPython 底层直接计算字符内存地址偏移,执行的是只读浅拷贝,不关心字符串的具体内容与内部结构。
2. rsplit():按分隔符从右向左切分
str.rsplit(sep, maxsplit) 是字符串对象的拆分方法。sep 指定分隔符,maxsplit 限制拆分次数。当设置 maxsplit=1 时,它只从字符串右侧找到第一个分隔符并执行一次切分,返回一个长度最多为 2 的列表,取索引 [1] 或 [-1] 即可获得最后一段。
# 提取最后一个下划线后面的内容
text = "order_20261007_A98F"
parts = text.rsplit("_", 1)
result = parts[-1]
print(result)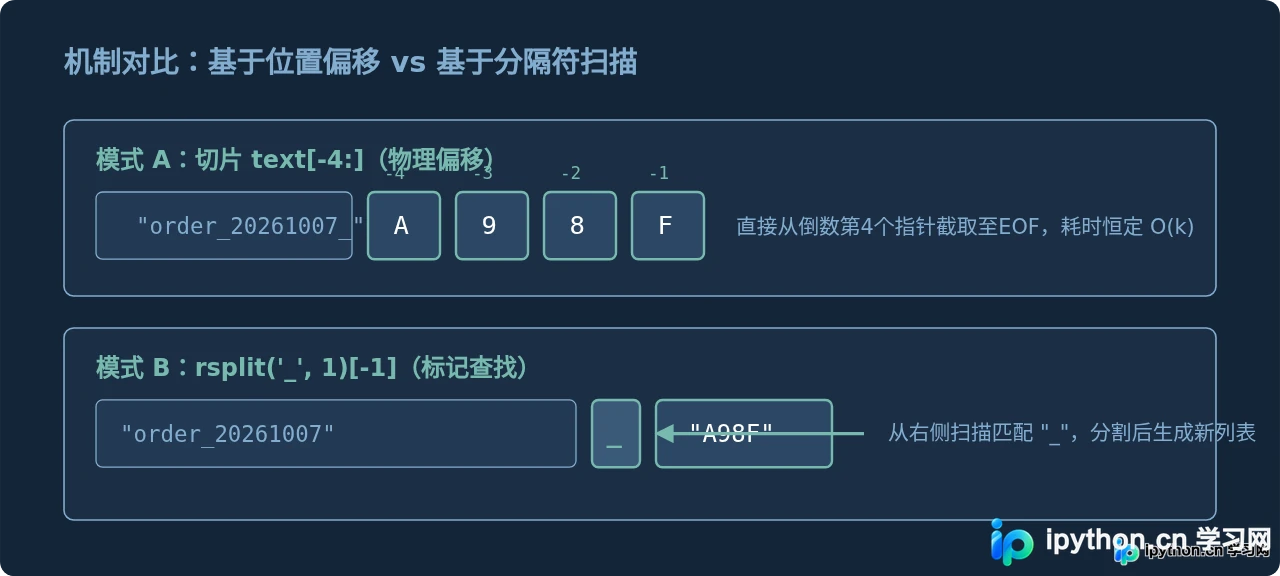
二、核心操作步骤与编码实践
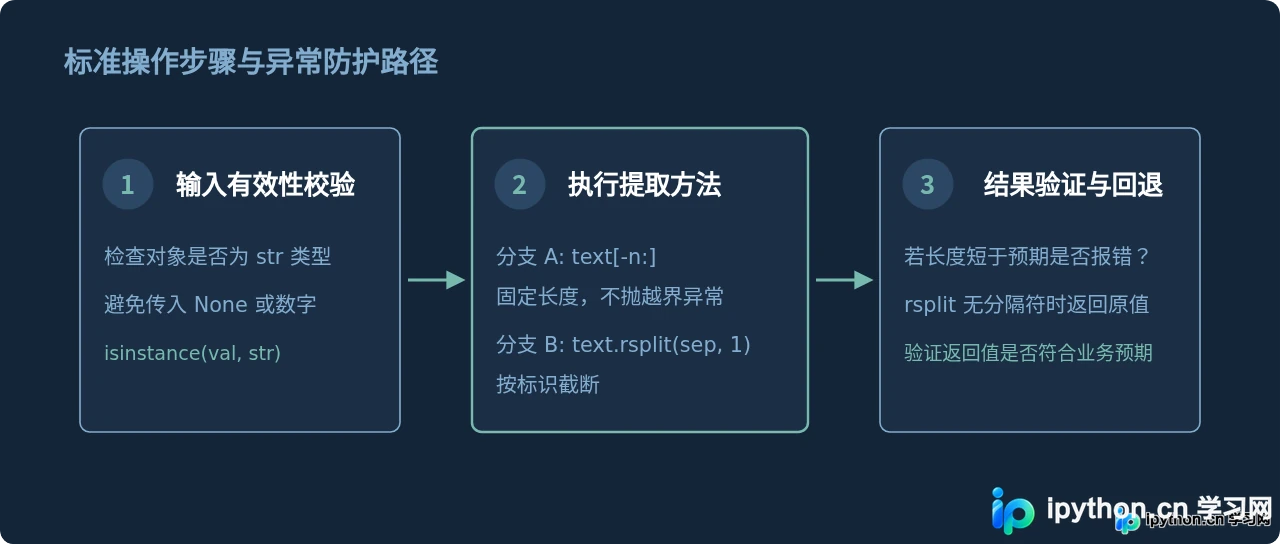
在实际编码中,处理输入数据往往需要防范异常边界(如字符串长度不足、未包含预期分隔符等)。以下为规范的实现步骤。
步骤 1:处理切片的长度容错
切片在 Python 中具备内在的“容错性”。如果字符串实际长度小于切片请求的长度,切片绝不会触发 IndexError,而是直接返回尽可能多的字符或原字符串。
short_text = "abc"
# 请求后 5 位,但原字符串只有 3 位
extracted = short_text[-5:]
print(f"提取结果: '{extracted}',字符长度: {len(extracted)}")len(text) >= 4 进行前置检查。
步骤 2:规避 rsplit 的分隔符缺失风险
如果目标字符串中不存在指定的分隔符,rsplit(sep, 1) 不会报错,而是会返回一个仅包含原完整字符串的单元素列表。
raw_id = "USER202610"
# 尝试按下划线拆分
parts = raw_id.rsplit("_", 1)
print(parts)如果此时直接写 parts[1] 会产生 IndexError: list index out of range。而若使用 parts[-1] 虽然不会报错,但得到的是未经拆分的 "USER202610",这可能会将错误的数据透传至下游。安全提取的代码模式如下:
def safe_extract_suffix(text: str, delimiter: str) -> str:
    if not isinstance(text, str):
        raise TypeError("输入必须为字符串")

    parts = text.rsplit(delimiter, 1)
    if len(parts) == 1:
        # 未找到分隔符时的策略:按业务需要返回空或抛出异常
        return ""
    return parts[1]

print("正常提取:", safe_extract_suffix("report_final_v2", "_"))
print("无分隔符:", safe_extract_suffix("reportfinalv2", "_"))无分隔符:
三、多维度核心特性对比
为了让选择依据更清晰,我们将切片与 rsplit 在各核心维度上的表现整理如下:
| 比较维度 | 负索引切片 text[-n:] |
右侧分割 text.rsplit(sep, 1)[-1] |
|---|---|---|
| 匹配依赖 | 严格依赖字符计数(固定偏移量) | 严格依赖特定的标记符号(分隔符) |
| 长度变化敏感度 | 目标后缀长度必须恒定;若长度可变则提取出错 | 后缀长度可动态变长,只要分隔符位置正确即可 |
| 异常表现 | 极其安全,索引超出范围不抛异常,返回全量或剩余部分 | 无分隔符时产生单元素列表;若取 [1] 抛 IndexError |
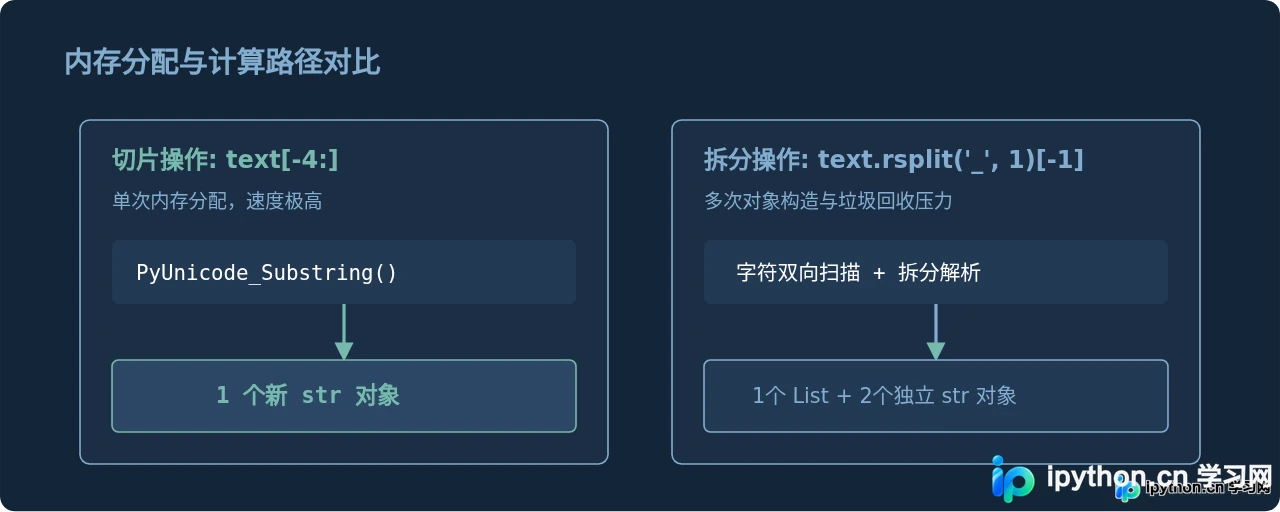
| 内存开销 | 极小:仅构造目标长度的新字符串对象 | 中等:需构造一个 Python list 容器及 2 个子字符串对象 |
| 典型场景 | 手机号后4位、定长哈希截断、固定时间戳后缀 | 文件扩展名、URL 尾部段落、带前缀的多级标识符 |
执行性能差异实测
使用标准库 timeit 模块在相同的 Python 3 解释器环境下对两种截取方式进行 10,000,000 次执行基准测试:
import timeit

setup_code = 's = "dataset_batch_2026_id9981"'

slice_time = timeit.timeit('s[-6:]', setup=setup_code, number=10_000_000)
rsplit_time = timeit.timeit('s.rsplit("_", 1)[-1]', setup=setup_code, number=10_000_000)

print(f"切片执行 1000 万次总耗时: {slice_time:.4f} 秒")
print(f"rsplit 执行 1000 万次总耗时: {rsplit_time:.4f} 秒")rsplit 执行 1000 万次总耗时: 1.1248 秒
由于 rsplit() 需要创建中间列表,并由解释器在执行完后释放该临时容器,其执行耗时通常是切片的 3 到 4 倍。因此在数百万级的高频循环或日志清洗流水线中,只要格式允许,切片具有极大的性能优势。
四、选型判断依据与场景总结
决定使用切片还是 rsplit(),本质上取决于业务数据本身的规整程度:
- 使用切片的判断条件:目标后缀的字符长度绝对固定。例如规范定义的哈希结尾(如短 Git SHA 7 位)、卡号末尾 4 位、格式化的年月日日期(YYYYMMDD 中的后 2 位代表日)。这种情况下无需引入分隔符扫描,切片是最简洁、最高效的手段。
- 使用 rsplit 的判断条件:末尾内容的长度动态不定,但存在唯一界定符。例如提取文件的扩展名(可能是
.py2位,也可能是.json4位)、从完整 URL 中获取最后的路由节点,或者从命名规范不严格的数据中提取以符号间隔的最后一栏。
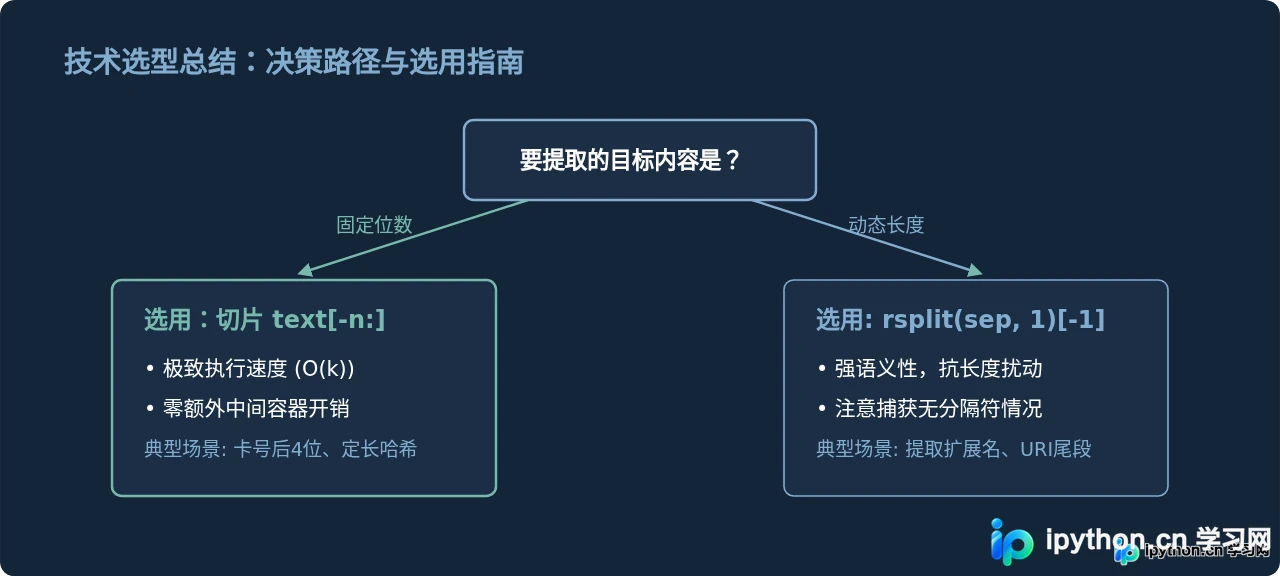
在日常开发中,建议优先明确输入协议。若属于由固定符号分隔的多段结构,哪怕当前长度看似固定,也应当使用 rsplit() 以保证语义健壮;而当面对格式严谨、纯粹依赖字符偏移截取后几位数据的场景时,负索引切片永远是性能与可读性俱佳的首选。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









