

Python基础:列表、元组、字典与集合详解

本文详细介绍Python中四种核心数据结构:列表、元组、字典和集合。涵盖定义语法、增删改查操作、循环遍历及嵌套处理,通过具体代码示例解析append、pop、get等常用方法,帮助开发者掌握数据存储与处理技巧。
1 列表
在Python编程中,高效操作数据结构是核心技能之一。理解不同数据类型的嵌套关系并明确当前使用的数据结构类型,对于编写高质量代码至关重要。
列表通过方括号定义,例如 ['数据1', '数据2', '数据3', '数据4'.....];元组则是不可变的列表,使用圆括号定义,如 t1 = (10, 20, 30)。需注意,t3 = (20) 仅表示整数类型,而 t3 = (20,) 才是元组。字典使用大括号定义键值对,如 dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}。集合(set)同样使用大括号,如 s2 = {10, 30, 20, 10, 30, 40, 30, 50},其特点是对元素自动去重。
1.1 列表语法
['数据1', '数据2', '数据3', '数据4'.....]
1.2 列表的常用操作
列表的主要功能是批量存储多个数据,程序员可对列表执行增、删、改、查四种基本操作。
1.2.1 查找
- 下标查找
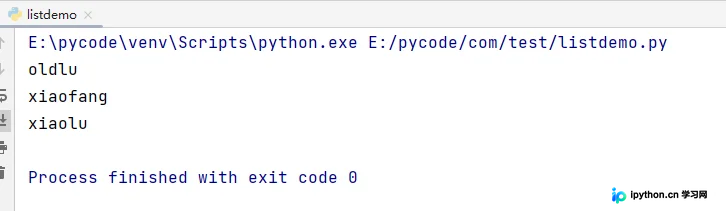
name_list = ['oldlu', 'xiaofang', 'xiaolu']
print(name_list[0])
print(name_list[1])
print(name_list[2])
具体示例如下:
- 函数方法
index():返回指定数据所在位置的下标。
语法
列表序列.index(数据, 开始位置下标, 结束位置下标)
快速体验
name_list =['oldlu', 'xiaofang', 'xiaolu']
print(name_list.index('oldlu', 0, 2))
具体示例如下:
注意:如果查找的数据不存在则报错。
count():统计指定数据在当前列表中出现的次数。
name_list = ['oldlu', 'xiaofang', 'xiaolu']
print(name_list.count('xiaofang'))
具体示例如下:
len():访问列表长度,即列表中数据的个数。
name_list = ['oldlu', 'xiaofang', 'xiaolu']
print(len(name_list)) #3
- 判断是否存在
in:判断指定数据在某个列表序列,如果在返回True,否则返回False
name_list = ['wushen', 'xiaoyuan', 'cheng']
# 结果:True
print('wushen' in name_list)
# 结果:False
print('wushens' in name_list)
具体示例如下:
not in:判断指定数据不在某个列表序列,如果不在返回True,否则返回False
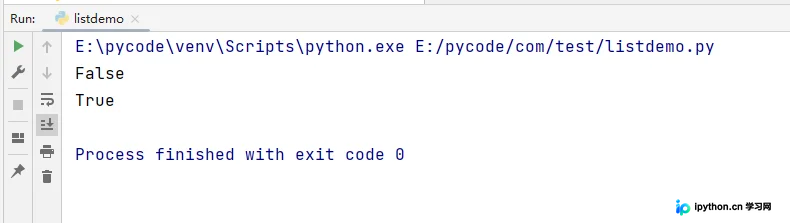
name_list = ['wushen', 'xioayuan', 'cheng']
# 结果:False
print('wushen' not in name_list)
# 结果:True
print('wushens' not in name_list)
具体示例如下:
1.2.2 增加
作用:增加指定数据到列表中。
1.语法
append():列表结尾追加数据。
列表序列.append(数据)
2. 体验
name_list = ['wushen', 'xiaoyuan', 'cheng']
name_list.append('xingdie')
# 结果:['wushen', 'xiaoyuan', 'cheng', 'xingdie']
print(name_list)
列表追加数据的时候,直接在原列表里面追加了指定数据,即修改了原列表,故列表为可变类型 数据。
3. 注意点
如果append()追加的数据是一个序列,则追加整个序列到列表
name_list = ['wushen', 'xiaoyuan', 'cheng']
name_list.append(['xingdie', 'xingdie'])
# 结果:['wushen', 'xiaoyuan', 'cheng', ['xingdie', 'xingdie']]
print(name_list)
extend():列表结尾追加数据,如果数据是一个序列,则将这个序列的数据逐一添加到列表。
1. 语法
列表序列.extend(数据)
2. 快速体验
单个数据
name_list = ['wushen', 'xiaoyuan', 'xingdie']
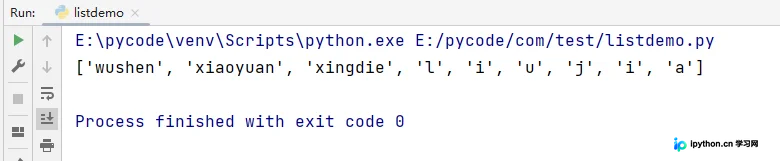
name_list.extend('liujia')
# 结果:['wushen', 'xiaoyuan', 'xingdie', 'l', 'i', 'u', 'j', 'i', 'a']
print(name_list)
具体示例如下:
序列数据
name_list = ['wushen', 'xiaoyuan', 'xingdie']
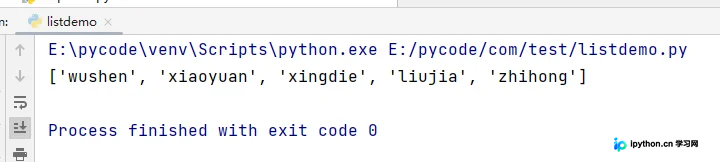
name_list.extend(['liujia', 'zhihong'])
# 结果:['wushen', 'xiaoyuan', 'xingdie', 'liujia', 'zhihong']
print(name_list)
具体示例如下:
insert():指定位置新增数据。
1. 语法
列表序列.insert(位置下标, 数据)
2. 快速体验
name_list = ['wushen', 'xiaoyuan', 'xingdie']
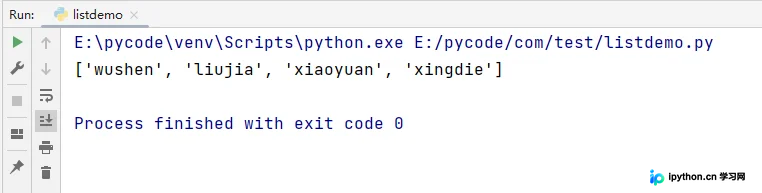
name_list.insert(1, 'liujia')
# 结果:['wushen', 'liujia', 'xiaoyuan', 'xingdie']
print(name_list)
具体示例如下:
1.2.3 删除
• del
1. 语法
del ⽬标
2. 快速体验
删除列表
name_list = ['wushen', 'xiaoyuan', 'xingdie']
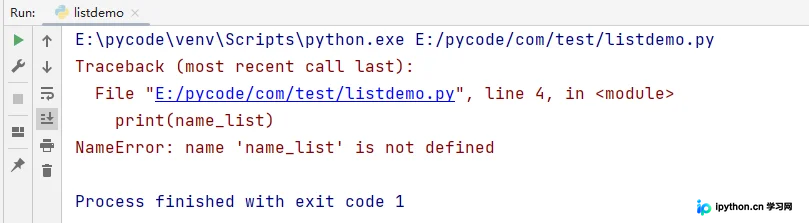
# 结果:报错提示:name 'name_list' is not defined
del name_list
print(name_list)
具体示例如下:
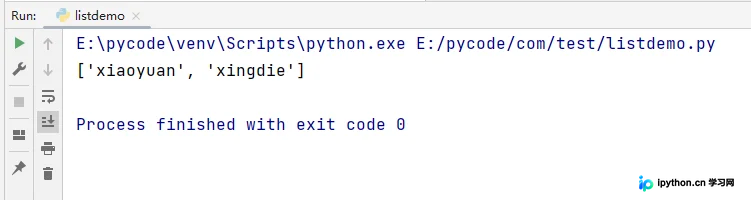
删除指定数据
name_list = ['wushen', 'xiaoyuan', 'xingdie']
del name_list[0]
# 结果:['xiaoyuan', 'xingdie']
print(name_list)
具体示例如下:
pop():删除指定下标的数据(默认为最后一个),并返回该数据。
1. 语法
列表序列.pop(下标)
2. 快速体验
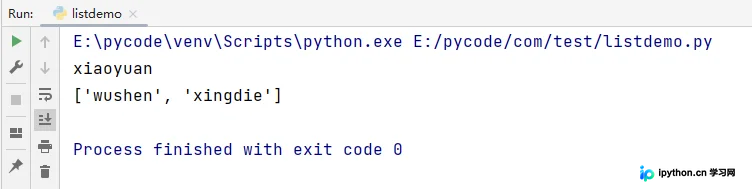
name_list = ['wushen', 'xiaoyuan', 'xingdie']
del_name = name_list.pop(1)
# 结果:xiaoyuan
print(del_name)
# 结果:['wushen', 'xingdie']
print(name_list)
具体示例如下:
remove():移除列表中某个数据的第一个匹配项。
1. 语法
1 列表序列.remove(数据)
2. 快速体验
name_list = ['wushen', 'xiaoyuan', 'xingdie']
name_list.remove('xingdie')
# 结果:['wushe', 'xiaoyuan']
print(name_list)
clear():清空列表
name_list = ['wushen', 'xiaoyuan', 'xingdie']
name_list.clear()
print(name_list) # 结果: []
具体示例如下:
1.2.4 修改
修改指定下标数据
name_list = ['wushen', 'xiaoyuan', 'xingdie']
name_list[0] = 'ccc'
# 结果:['ccc', 'xiaoyaun', 'xingdie']
print(name_list)
逆置:reverse()
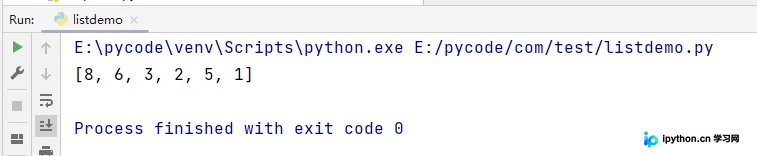
num_list = [1, 5, 2, 3, 6, 8]
num_list.reverse()
# 结果:[8, 6, 3, 2, 5, 1]
print(num_list)
具体示例如下:
排序:sort()
1. 语法
列表序列.sort( key=None, reverse=False)
注意:reverse表示排序规则,reverse = True 降序, reverse = False 升序(默认)
2. 快速体验
num_list = [1, 5, 2, 3, 6, 8]
num_list.sort()
# 结果:[1, 2, 3, 5, 6, 8]
print(num_list)
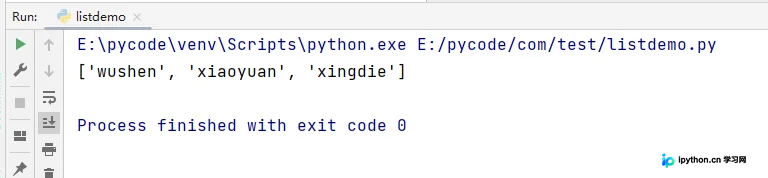
1.2.6 复制
函数:copy()
name_list = ['wushen', 'xiaoyuan', 'xingdie']
name_li2 = name_list.copy()
# 结果:['wushen', 'xiaoyuan', 'xingdie']
print(name_li2)
具体示例如下:
1.3 列表的循环遍历
1.3.1 while
•代码
name_list = ['wushen', 'xiaoyuan', 'xingdie']
i = 0
while i < len(name_list):
    print(name_list[i])
    i += 1
具体示例如下:
1.3.2 for
代码
name_list = ['wushen', 'xiaoyuan', 'xingdie']
for i in name_list:
    print(i)
具体示例如下:
1.4 列表嵌套
所谓列表嵌套指的就是一个列表里面包含了其他的子列表。
name_list = [['吴神', '⼩园', '星蝶'], ['wushen', 'xiaoyuan', 'xingxie'], ['张三', '李四',
'王五']]
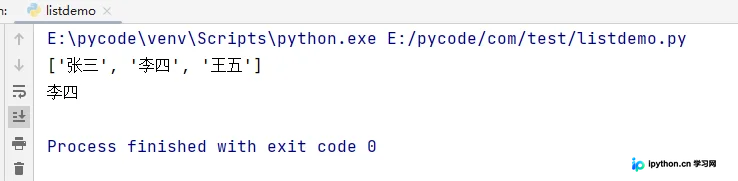
思考: 如何查找到数据"李四"?
# 第⼀步:按下标查找到李四所在的列表
print(name_list[2])
# 第⼆步:从李四所在的列表⾥⾯,再按下标找到数据李四
print(name_list[2][1])
具体示例如下:
2 元组
2.1 定义元组
思考:如果想要存储多个数据,但是这些数据是不能修改的数据,怎么做?
答:列表?列表可以一次性存储多个数据,但是列表中的数据允许更改。
一个元组可以存储多个数据,元组内的数据是不能修改的。
元组特点:定义元组使用小括号,且逗号隔开各个数据,数据可以是不同的数据类型
# 多个数据元组
t1 = (10, 20, 30)
# 单个数据元组
t2 = (10,)
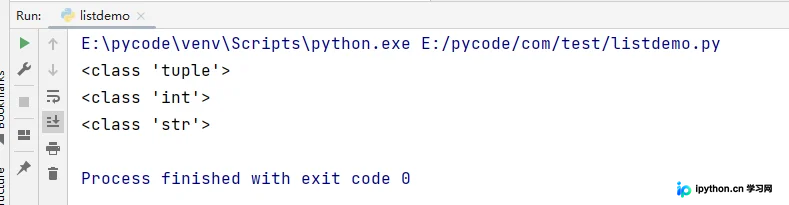
注意:如果定义的元组只有一个数据,那么这个数据后面也好添加逗号,否则数据类型为唯一的 这个数据的数据类型
t2 = (10,)
print(type(t2)) # tuple
t3 = (20)
print(type(t3)) # int
t4 = ('hello')
print(type(t4)) # str
具体示例如下:
2.2 元组的常见操作
元组数据不支持修改,只支持查找,具体如下:
- 按下标查找数据
tuple1 = ('aa', 'bb', 'cc', 'bb')
print(tuple1[0]) # aa- index():查找某个数据,如果数据存在返回对应的下标,否则报错,语法和列表、字符串的index 方法相同。
tuple1 = ('aa', 'bb', 'cc', 'bb')
print(tuple1.index('aa')) # 0- count():统计某个数据在当前元组出现的次数。
tuple1 = ('aa', 'bb', 'cc', 'bb')
print(tuple1.count('bb')) # 2- len():统计元组中数据的个数。
tuple1 = ('aa', 'bb', 'cc', 'bb')
print(len(tuple1)) # 4
注意:元组内的直接数据如果修改则立即报错
tuple1 = ('aa', 'bb', 'cc', 'bb')
tuple1[0] = 'aaa'
但是如果元组里面有列表,修改列表里面的数据则是支持的,故觉很重要。
tuple2 = (10, 20, ['aa', 'bb', 'cc'], 50, 30)
print(tuple2[2]) # 访问到列表
# 结果:(10, 20, ['aaaaa', 'bb', 'cc'], 50, 30)
tuple2[2][0] = 'aaaaa'
print(tuple2)
3 字典
3.1 创建字典的语法
字典特点:
- 符号为大括号
- 数据为键值对形式出现
- 各个键值对之间用逗号隔开
# 有数据字典
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
# 空字典
dict2 = {}
dict3 = dict()
注意:一般称冒号前面的为键(key),简称k;冒号后面的为值(value),简称v。
3.2 字典常见操作
3.2.1 增加
写法:字典序列[key] = 值
注意:如果key存在则修改这个key对应的值;如果key不存在则新增此键值对。
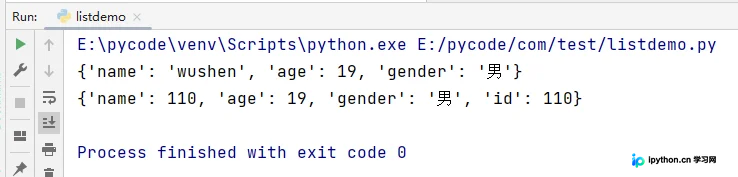
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
dict1['name'] = 'wushen'
# 结果:{'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1)
dict1['id'] = 110
dict1['name'] = 110
具体示例如下:
注意:字典为可变类型。
3.2.2 删除
del() / del:删除字典或删除字典中指定键值对
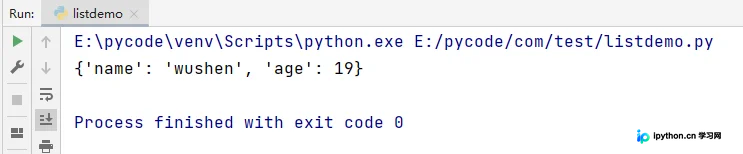
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
del dict1['gender']
# 结果:{'name': 'wushen', 'age': 19}
print(dict1)
具体示例如下:
clear():清空字典
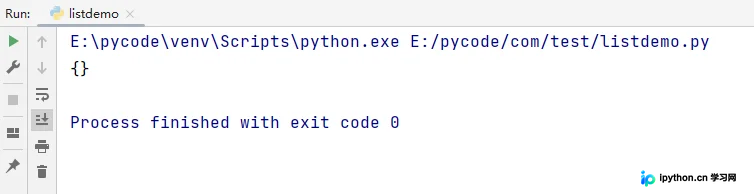
dict1 = {'name': 'wushne', 'age': 19, 'gender': '男'}
dict1.clear()
print(dict1) # {}
具体示例如下:
3.2.3 修改
写法:字典序列[key] = 值
注意:如果key存在则修改这个key对应的值 ;如果key不存在则新增此键值对。
3.2.4 查询
key值查找
dict1 ={'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1['name'])
print(dict1['id']) # 报错
具体示例如下:
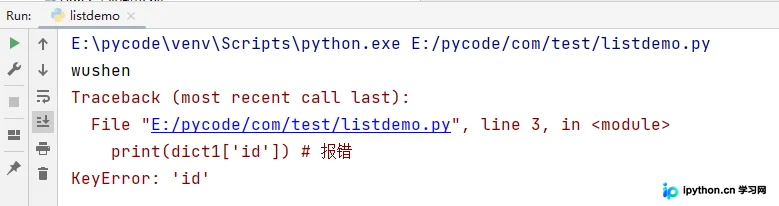
如果当前查找的key存在,则返回对应的值;否则则报错。
get()
- 语法
字典序列.get(key, 默认值)
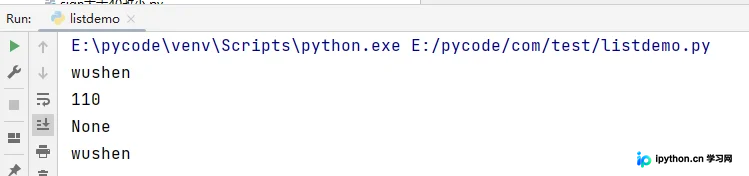
注意:如果当前查找的key不存在则返回第二个参数(默认值),如果省略第二个参数,则返回 None。
- 快速体验
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1.get('name')) # wushen
print(dict1.get('id', 110)) # 110
print(dict1.get('id')) # None
print(dict1.get('name',110)) # wushen
具体示例如下:
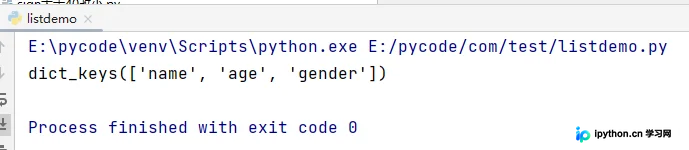
keys()获得所有的键
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1.keys()) # dict_keys(['name', 'age', 'gender'])
具体示例如下:
values()获得所有的值
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1.values()) # dict_values(['wushen', 19, '男'])
items()获得所有的键值对
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
print(dict1.items()) # dict_items([('name', 'wushen'), ('age', 19), ('gender','男')])
3.3 字典的循环遍历
3.3.1 遍历字典的key
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
for key in dict1.keys():
 print(key)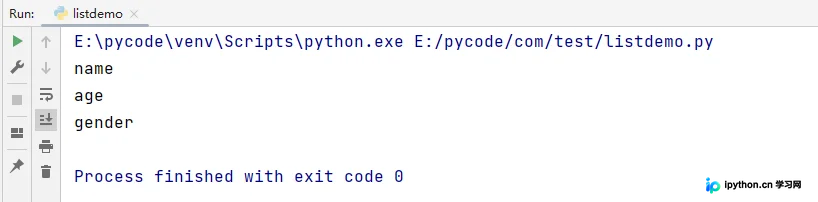
3.3.2 遍历字典的value
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
for value in dict1.values():
 print(value)
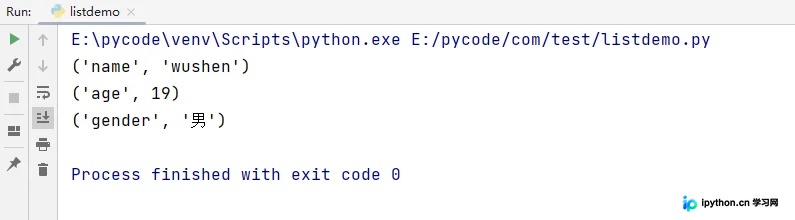
3.3.3 遍历字典的元素
dict1={'name':'wushen','age':19,'gender':'男'}
for item in dict1.items():
 print(item)
具体示例如下:
3.3.4 遍历字典的键值对
dict1 = {'name': 'wushen', 'age': 19, 'gender': '男'}
for key, value in dict1.items():
 print(f'{key} = {value}')
4 集合
4.1 创建集合
创建集合使用 {} 或 set() , 但是如果要创建空集合只能使用 set() ,因为 {} 用来创建空字典。
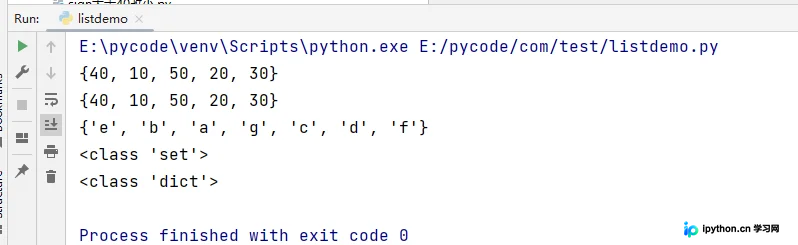
特点: 1. 集合可以去掉重复数据;2. 集合数据是无序的,故不支持下标。
s1 = {10, 20, 30, 40, 50}
print(s1)
s2 = {10, 30, 20, 10, 30, 40, 30, 50}
print(s2)
s3 = set('abcdefg')
print(s3)
s4 = set()
print(type(s4)) # set
s5 = {}
print(type(s5)) # dict
具体示例如下:
4.2 集合常见操作方法
4.2.1 增加数据
add()
s1 = {10, 20}
s1.add(100)
s1.add(10)
print(s1) # {100, 10, 20}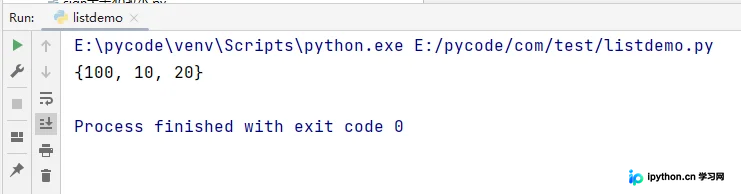
因为集合有去重功能,所以,当向集合内追加的数据是当前集合已有数据的话,则不进行任何操作。
update(),追加的数据是序列。
s1 = {10, 20}
# s1.update(100) # 报错
s1.update([100, 200])
s1.update('abc')
print(s1)
4.2.2 删除数据
remove()删除集合中的指定数据,如果数据不存在则报错。
s1 = {10, 20}
s1.remove(10)
print(s1)
s1.remove(10) # 报错
print(s1)discard()删除集合中的指定数据,如果数据不存在也不会报错。
s1 = {10, 20}
s1.discard(10)
print(s1)
s1.discard(10) # 报错
print(s1)pop()随机删除集合中的某个数据,并返回这个数据。
s1 = {10, 20, 30, 40, 50}
del_num = s1.pop()
print(del_num)
print(s1)
4.2.3 查找数据
in:判断数据在集合序列not in:判断数据不在集合序列
s1 = {10, 20, 30, 40, 50}
print(10 in s1)
print(10 not in s1)
总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









