


很多人一看到“按分类统计数量”,就会先往子查询上想,但真正决定结果是否正确的,是有没有把 COUNT() 放到明确的分组逻辑里。本文把几种常见写法拆开说明:哪些写法看似能跑、其实不适合做“每个分类数量”,为什么 LEFT JOIN + GROUP BY 往往是更稳的默认方案,以及遇到 NULL 分类和脏数据时该怎么补齐统计口径。
为什么只写 COUNT() 不够
要拿到“每个分类的记录数”,不能只写一个 COUNT(),还必须告诉数据库“按哪个字段分组”。如果没有 GROUP BY,聚合函数会把整个结果集压成一行,得到的只是总数,而不是每个分类各自的数量。
常见误用有两类。
错误一:只统计总数,没有分类维度
SELECT (SELECT COUNT(*) FROM products) FROM categories这条语句没有任何分组逻辑,内层子查询只会返回 products 的总行数。外层即使扫描了 categories,也只是重复显示同一个总数,不能回答“每个分类有多少条”。
错误二:把相关子查询当成分组统计的替代品
SELECT name, (SELECT COUNT(*) FROM products WHERE category_id = c.id) FROM categories c这条写法语法上可以成立,但它不是用子查询“完成分组”,而是让外层每扫到一条分类,内层就重新算一次数量。也就是说,它属于相关子查询,不等于更好的统计方案。
- 真正要做“每个分类数量”,优先考虑
JOIN + GROUP BY - 如果坚持用子查询,必须是和外层分类关联的相关子查询
- MySQL 8.0+、PostgreSQL 支持在
SELECT子句里直接放聚合子查询,但 SQLite 不支持
推荐写法:LEFT JOIN + GROUP BY
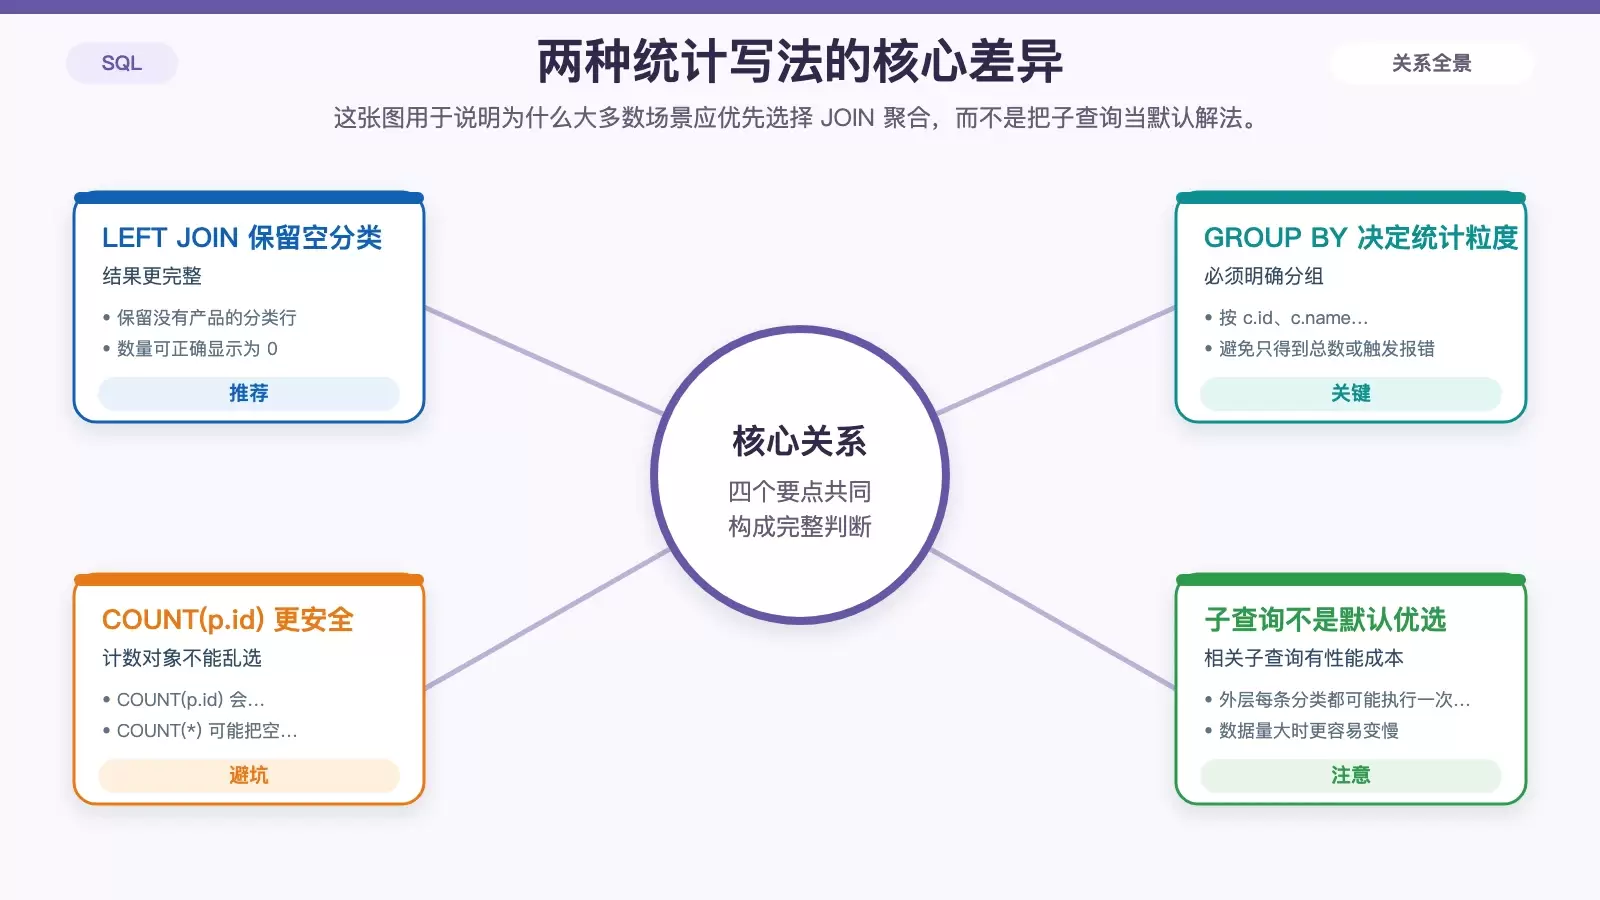
大多数业务里,LEFT JOIN 配合 GROUP BY 是更适合的默认方案。它能一次拉出所有分类,并把对应产品数量一起统计出来;即使某个分类下暂时没有产品,也会保留这一行,数量显示为 0。
SELECT c.name, COUNT(p.id) AS product_count
FROM categories c
LEFT JOIN products p ON c.id = p.category_id
GROUP BY c.id, c.name;
这条 SQL 的关键点有三个。
为什么要用 COUNT(p.id),不要用 COUNT(*)
COUNT(p.id) 只统计非 NULL 的产品 ID。对于没有匹配产品的分类,LEFT JOIN 之后 p.id 为 NULL,因此结果会正确显示为 0。
如果改成 COUNT(*),数据库会把连接出来的那一行也算进去,空分类就可能被误算成 1。
GROUP BY 为什么要带上 c.id
在这类查询里,GROUP BY 不能只写名称字段。为了保证结果稳定,也为了满足数据库的语法要求,应该把 c.id 和 c.name 一起放进分组条件。
- PostgreSQL 对这一点要求更严格,缺少必要分组列会直接报错
- MySQL 在严格模式下也会报错或拒绝执行
- 把主键和展示字段一起分组,更符合跨数据库兼容的写法
必须用子查询时,应该怎么写
有些场景确实无法回避子查询,比如某些报表工具只允许单层 SELECT 输出,或者现有查询模板不方便改成连接写法。这时可以使用相关子查询,但要明确它只是“可用方案”,不是优先方案。
SELECT c.name,
(SELECT COUNT(*) FROM products p WHERE p.category_id = c.id) AS product_count
FROM categories c;
这条语句的核心在于,子查询内部的 WHERE 条件必须关联外层分类表:
p.category_id = c.id没有这层关联,内层算出的就只会是总数,而不是当前分类的数量。
相关子查询为什么容易慢
相关子查询的问题不在语法,而在执行方式。数据库通常会对外层查询返回的每一条分类记录,都重复执行一次内层统计;分类越多、产品表越大,代价越明显。
- 确保
products.category_id上有索引,否则很容易退化成多次全表扫描 - MySQL 5.7 默认可能不走索引,实际环境里常需要额外观察执行计划
- 如果条件允许,优先升级到 MySQL 8.0,必要时再考虑显式加
FORCE INDEX
NULL 分类和脏数据怎么处理
实际库表里,最容易被漏掉的不是 SQL 语法,而是数据本身。比如 category_id IS NULL,或者分类字段被写成空字符串,这些记录往往不会自然落到你期望的分类结果里。
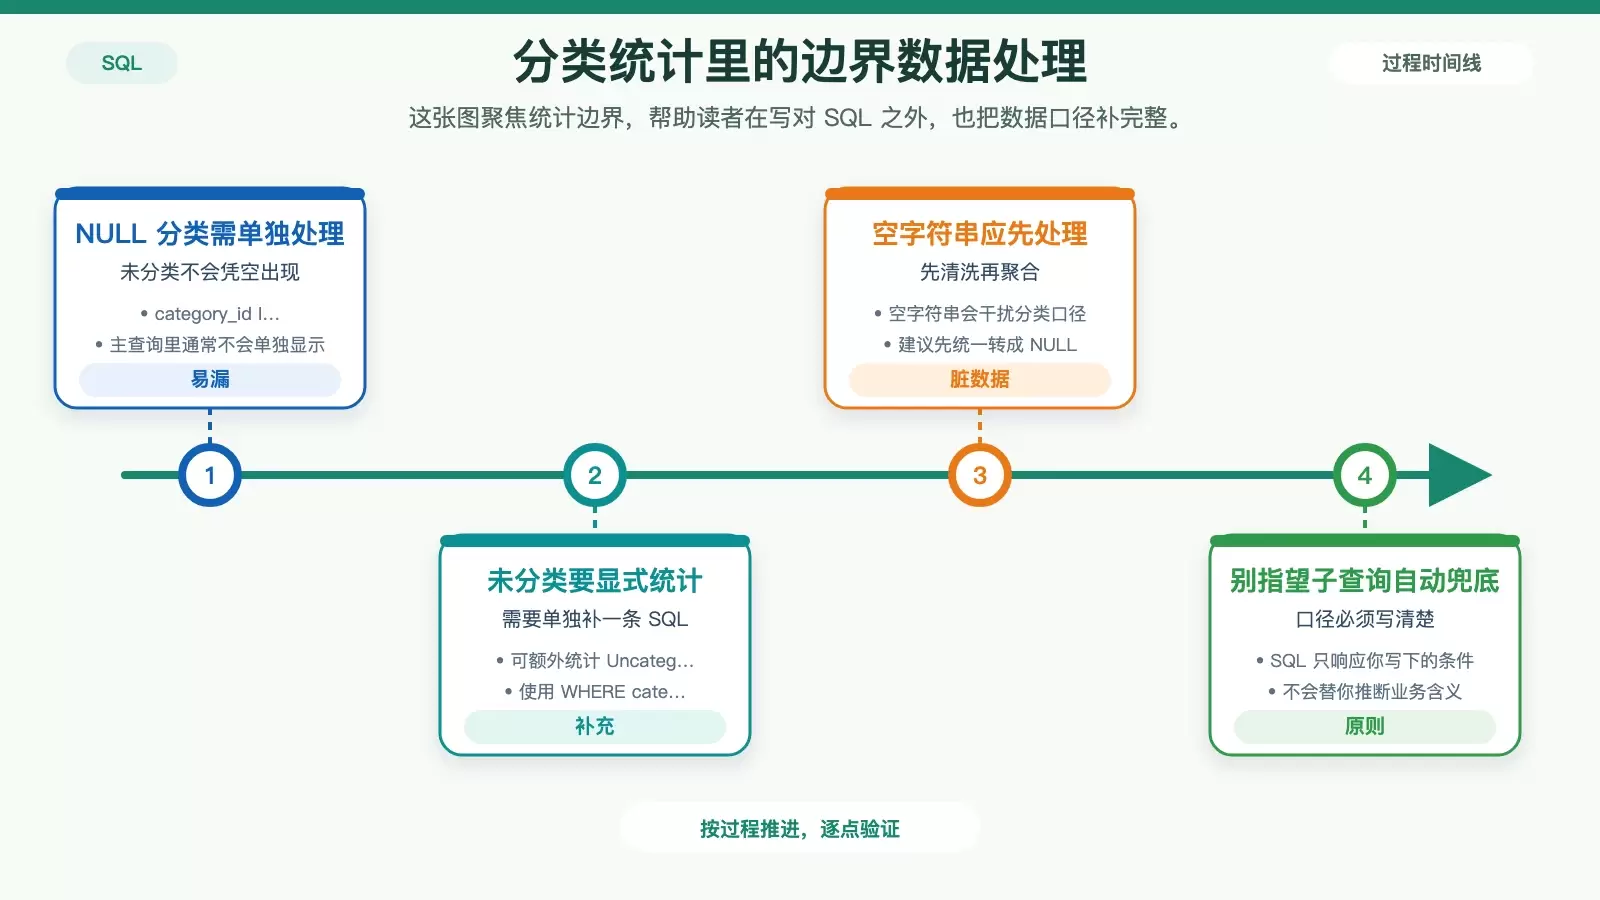
使用 JOIN 时,没有分类 ID 的记录通常不会匹配到任何分类;使用相关子查询时,它们也不会自动生成一个“未分类”分组。换句话说,SQL 只会按你写下的条件统计,不会替你补业务语义。
统计未分类记录
如果业务上需要把未分类数据单独列出来,可以额外补一条统计语句:
SELECT 'Uncategorized', COUNT(*) FROM products WHERE category_id IS NULL这样至少能把未归类产品从主统计结果中分离出来,避免被误认为“没有数据”。
空字符串分类先清洗再统计
如果历史数据里存在空字符串分类值,建议先做清洗,再执行正式统计:
UPDATE products SET category_id = NULL WHERE category_id = ''先统一脏数据口径,再做聚合,通常比在统计 SQL 里不断补条件更容易维护。
结论:默认先选 JOIN,再考虑子查询
只要目标是“统计每个分类的记录数量”,思路就应该先落在“按分类分组”上,而不是先选子查询。通用场景下,LEFT JOIN + GROUP BY 更稳,结果更完整,也更适合处理数量为 0 的分类;相关子查询适合在语法或工具受限时兜底使用,但要额外注意索引和执行成本。
实际写 SQL 时,可以把判断顺序固定下来:先确认是否需要保留空分类,再决定是否必须用子查询,最后检查 NULL 和脏数据是否要单独统计。这样写出来的结果会更接近真实业务口径。









