


很多 SQL 在功能上能跑通,但一旦嵌套层数变深,后续维护就会迅速变得吃力。CTE 的价值不在于“把所有子查询都改成 WITH”,而在于把重复逻辑、复杂聚合和多层依赖拆成可命名、可复用的步骤;看完这篇,你可以判断哪些嵌套值得替换、三层结构该怎么拆,以及在 MySQL 8.0+ 里如何避开递归与性能方面的常见坑。
哪些嵌套子查询值得改成 CTE
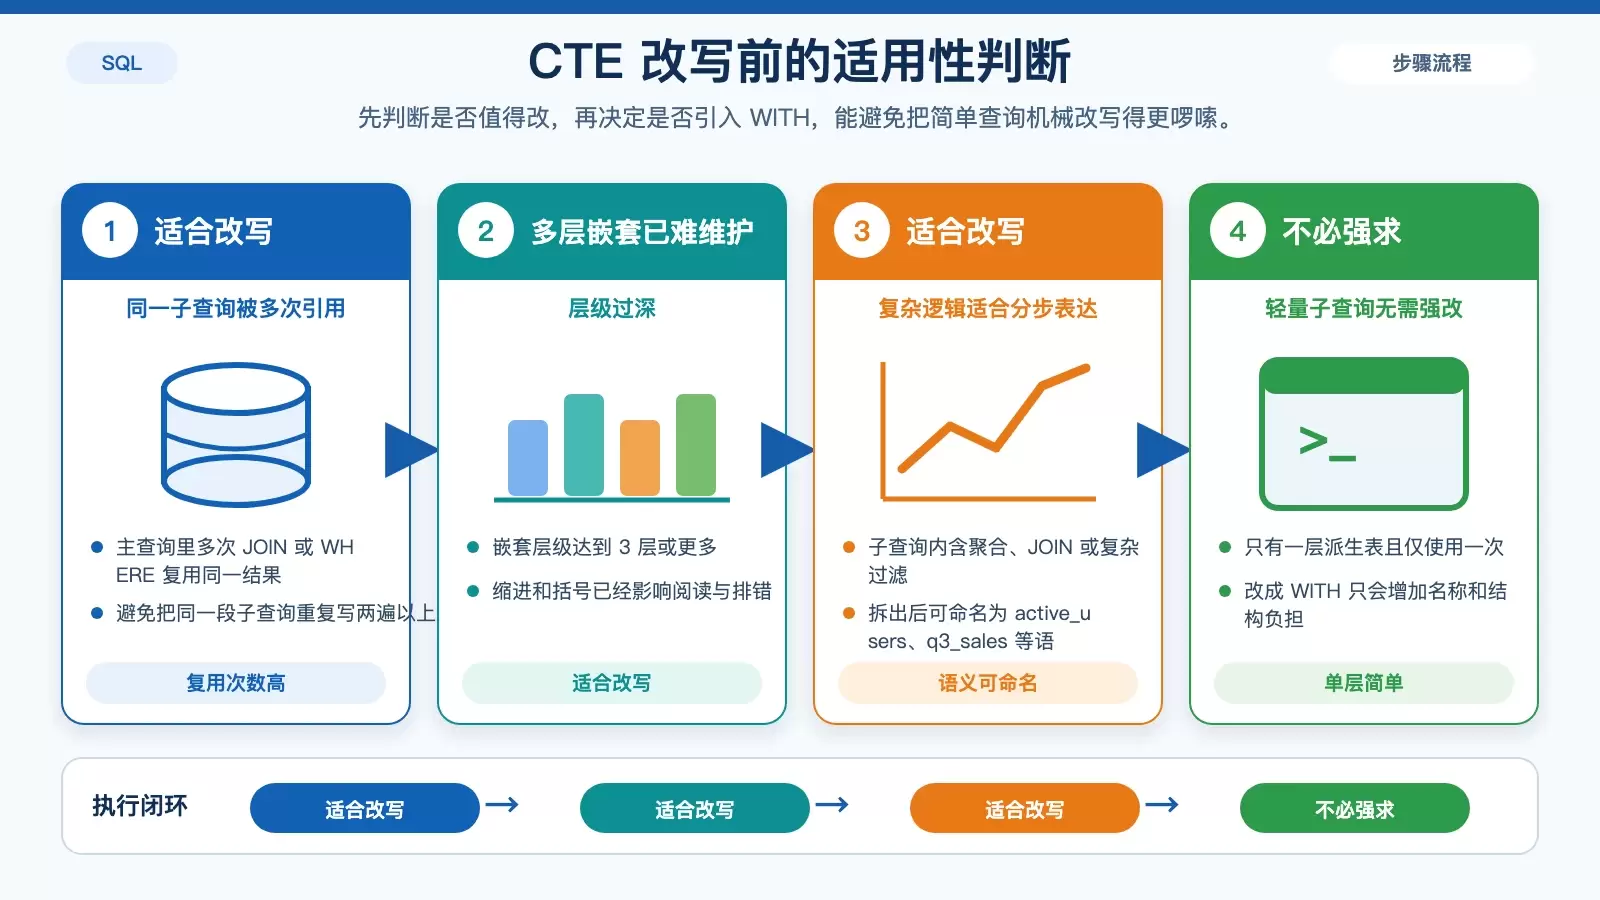
先说结论:CTE 不能直接替换所有嵌套子查询。它更适合那些需要重复引用、需要分步表达逻辑,或者已经嵌套得难以阅读的查询。
例如下面这种结构,通常就比单纯一层派生表更值得考虑改写:
SELECT * FROM (SELECT ... FROM ...) t WHERE t.col > (SELECT AVG(...) FROM ...)但如果只是单层派生表,例如 FROM (SELECT ...) t,而且逻辑本身很短、只用一次,强行改成 WITH 未必有收益,反而只是多了一层命名成本。
三个最值得替换的判断标准
- 同一子查询在主查询中出现至少 2 次,例如多次
JOIN或在WHERE中重复使用。 - 嵌套深度达到 3 层或更多,缩进已经明显影响阅读。
- 子查询里包含聚合、
JOIN、复杂过滤,拆出来后可以明确命名语义,例如active_users、q3_sales。
判断标准其实很简单:如果把子查询单独命名之后,查询意图更清楚,那通常就值得改。
三层嵌套查询怎么拆成 CTE
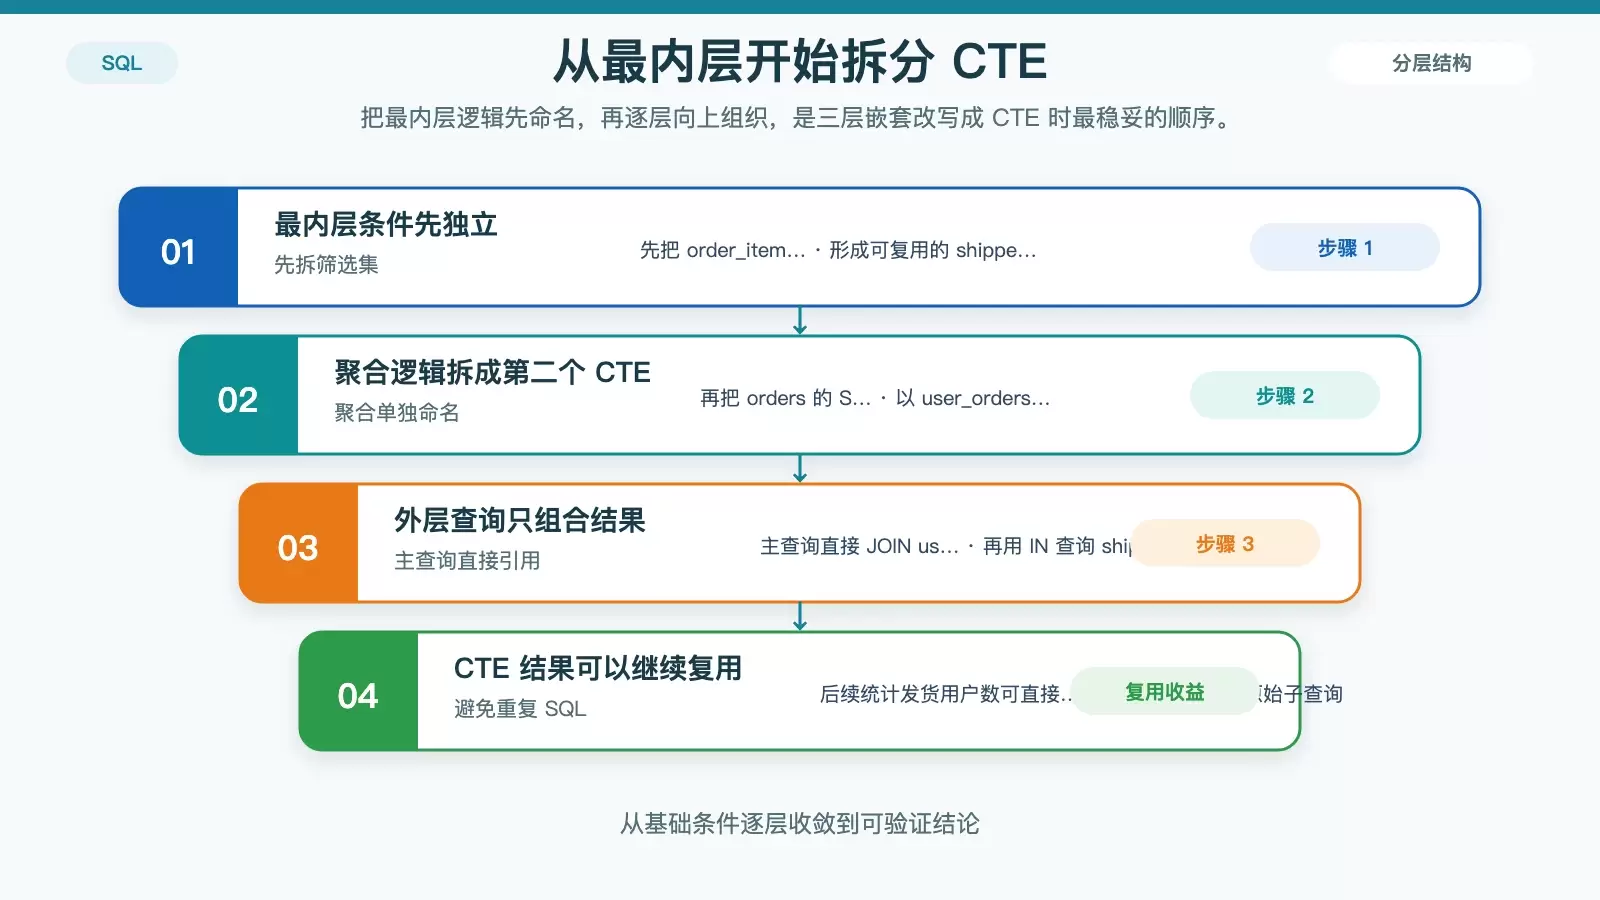
三层嵌套改写的核心不是“从外往里包”,而是从最内层开始向上拆。每一层独立成一个 CTE,CTE 之间用逗号分隔,后一个 CTE 可以直接引用前一个。
先看原始写法:
SELECT u.name, o.total
FROM users u
JOIN (
SELECT user_id, SUM(amount) AS total
FROM orders
WHERE order_date >= '2024-01-01'
GROUP BY user_id
) o ON u.id = o.user_id
WHERE u.id IN (
SELECT user_id FROM order_items WHERE status = 'shipped'
);
改成 CTE 后可以写成:
WITH shipped_users AS (
SELECT DISTINCT user_id FROM order_items WHERE status = 'shipped'
),
user_orders AS (
SELECT user_id, SUM(amount) AS total
FROM orders
WHERE order_date >= '2024-01-01'
GROUP BY user_id
)
SELECT u.name, o.total
FROM users u
JOIN user_orders o ON u.id = o.user_id
WHERE u.id IN (SELECT user_id FROM shipped_users);
改写时要抓住的几个要点
shipped_users和user_orders都是并列定义的独立 CTE,本身不再继续嵌套。- 主查询里直接使用 CTE 名称,不需要再额外加括号包一层派生表。
- 如果后续还要统计发货用户数,可以直接复用:
SELECT COUNT(*) FROM shipped_users。
这类改写最直接的收益,是把“筛出发货用户”和“汇总订单金额”变成两个可读的业务步骤,而不是都塞在主查询里临时展开。
MySQL 8.0+ 使用递归 CTE 时要注意什么
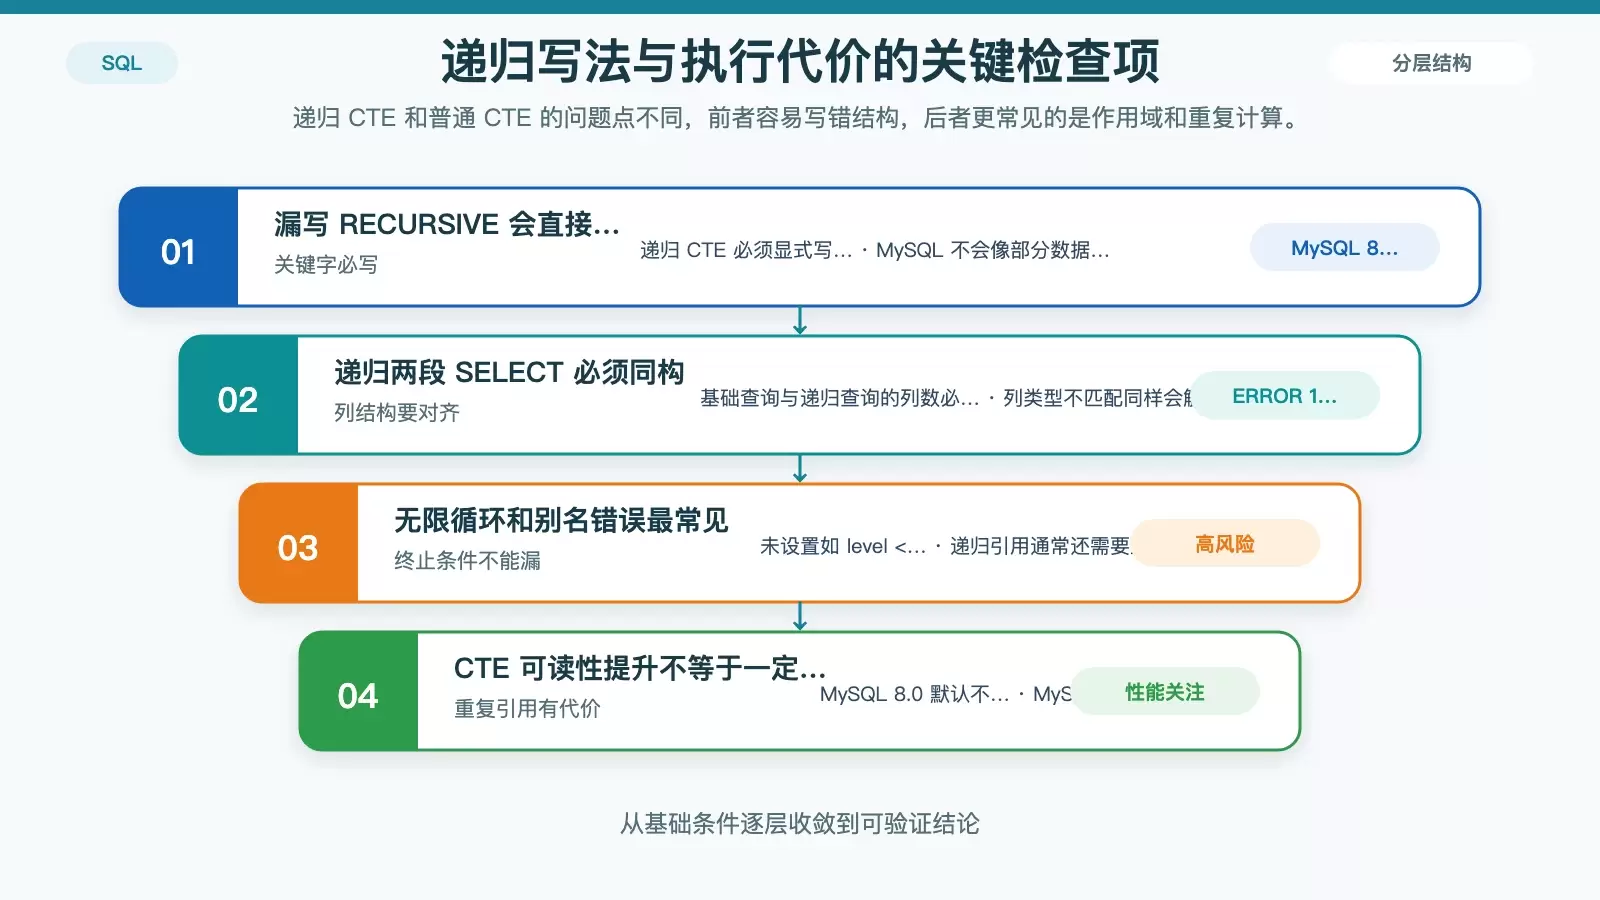
在 MySQL 8.0+ 里,递归 CTE 不是只要写出递归结构就能执行,必须显式加上 RECURSIVE 关键字。这个要求和 PostgreSQL、SQL Server 的使用习惯不同,很多报错都出在这里。
典型报错示例是:
ERROR 1222 (21000): The used SELECT statements have a different number of columns正确写法应当像下面这样:
WITH RECURSIVE org_tree AS (
SELECT id, name, manager_id, 1 AS level
FROM employees
WHERE manager_id IS NULL
UNION ALL
SELECT e.id, e.name, e.manager_id, t.level + 1
FROM employees e
JOIN org_tree t ON e.manager_id = t.id
)
SELECT * FROM org_tree;
递归 CTE 的几个常见坑
- 漏写
RECURSIVE,会直接触发语法相关错误。 - 基础查询和递归查询的列数或类型不一致,会报
ERROR 1222。 - 没有设置终止条件,例如
level < 10,可能导致无限递归或内存问题。 - 递归引用时写成
JOIN org_tree而不是JOIN org_tree t,容易因为别名缺失导致报错。
如果你在 MySQL 里调试递归 CTE,优先检查的就是这四项,通常比盲目改业务逻辑更有效。
CTE 的作用域和性能影响
CTE 不是临时表,更准确地说,它是当前查询计划中的一个命名节点。也正因为如此,它的可读性优势很明显,但性能表现不一定总是优于原始嵌套写法。
一个容易被忽略的事实是:CTE 在执行时仍然可能被重复计算,是否物化取决于数据库优化器策略。
- 在一条语句里写
SELECT * FROM cte1; SELECT * FROM cte1;这种理解并不准确;CTE 的作用域仅限于它所在的那一条语句。 - 如果同一个
cte1在查询中被JOIN两次,而且数据量较大,MySQL 可能重复扫描源表。 - MySQL 8.0 默认不物化,PostgreSQL 12+ 默认物化,这会直接影响重复引用时的执行代价。
- MySQL 8.0.25+ 如果希望强制物化,可在 CTE 定义前使用提示:
/*+ MATERIALIZE */。
生命周期上还要记住两条规则
- CTE 名称不能与真实表名冲突,否则可能报
Table 'xxx' is ambiguous。 WITH的作用域严格限制在当前语句,语句结束后 CTE 立即失效,不能跨多个INSERT、UPDATE或其他 DML 复用。
所以,CTE 更适合解决“单条复杂 SQL 的组织问题”,而不是拿来充当跨语句共享结果的替代方案。
实际使用时怎么做判断
如果你的 SQL 只是轻量的一层子查询,继续保留原写法通常更直接;但一旦出现重复引用、三层以上嵌套,或者子查询本身已经带有明显业务语义,把它拆成 CTE 往往更利于维护。
实操上可以按这个顺序判断:
- 先看子查询是不是会复用。
- 再看嵌套是否已经影响阅读和排错。
- 最后评估数据库对 CTE 的执行策略,避免可读性提升但代价是重复扫描。
把 CTE 当成“结构化表达复杂查询”的工具,而不是统一替换模板,通常才是更稳妥的用法。









