


学完字符串和列表之后,很多人会在后续练习里遇到一个问题:明明数据都能存下来,但一到“按名称取值”“保证数据不被改动”或“快速去重”这类场景,就容易写得别扭。字典、元组和集合,正好分别对应这三类需求。
这篇文章按“什么时候该用它、怎么创建、有哪些高频操作、最容易踩什么坑”的顺序来梳理三种数据结构。看完之后,你不仅能把代码写对,也能判断在实际数据处理里该优先选哪一种。
字典为什么适合按键查值
字典(dict)本质上是键值对(key-value)映射结构,用大括号 {} 表示,键和值之间用冒号 : 分隔,多个键值对之间用逗号 , 分隔。它最核心的特点是:通过键直接找到值。
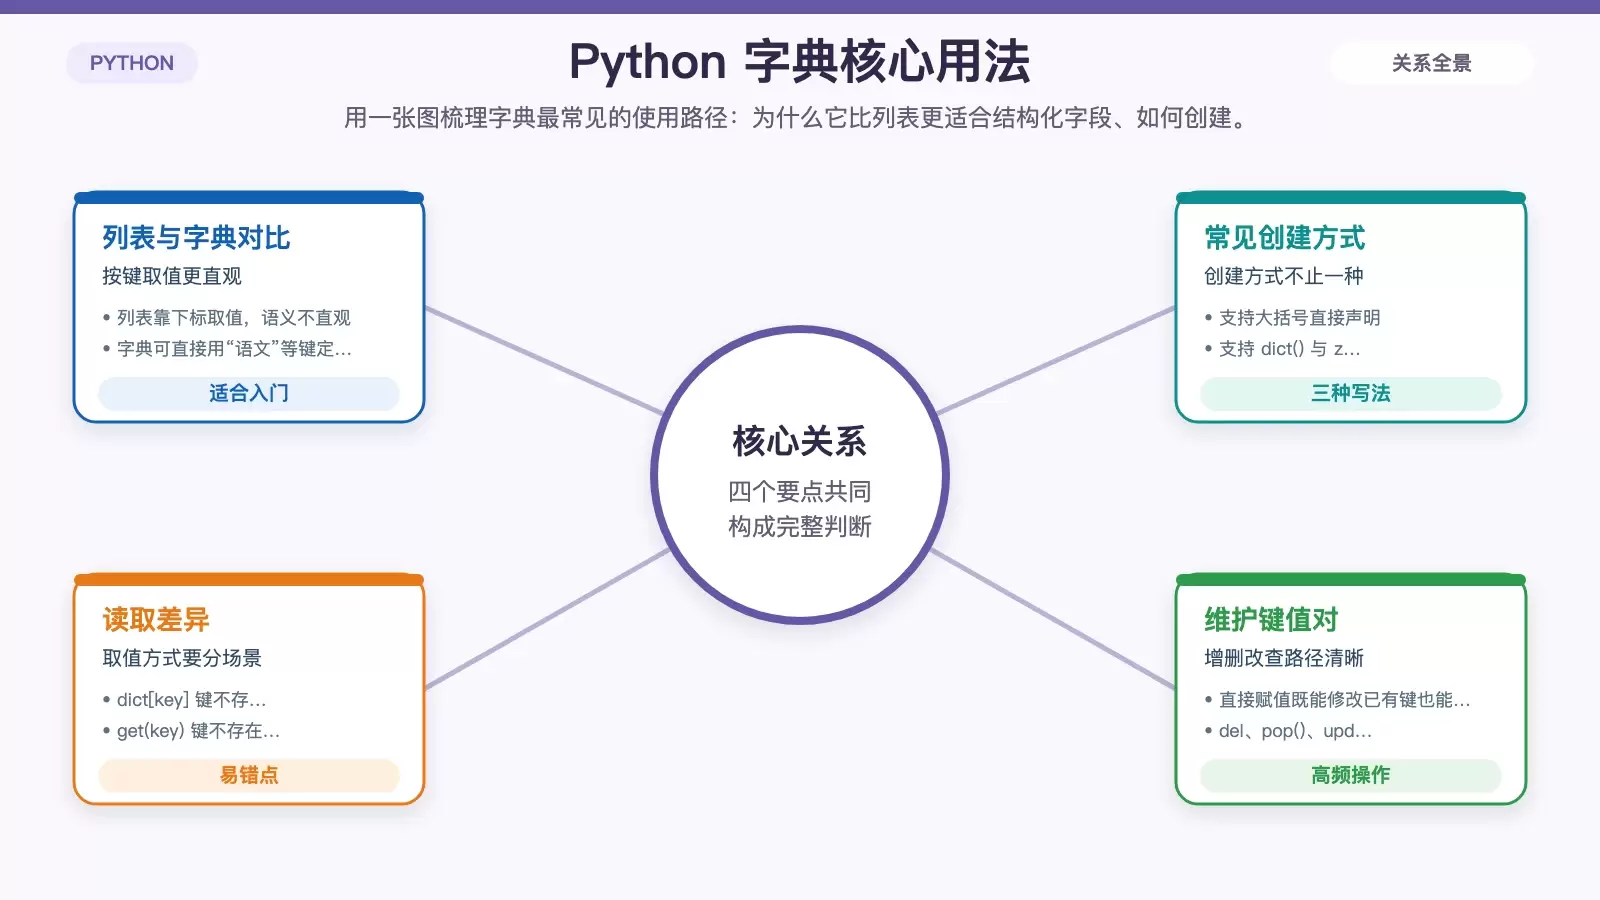
字典里的键必须唯一且不可变,通常会使用字符串、数字这类类型;值则可以是任意类型,灵活性很高。
为什么很多场景里字典比列表更直观
如果只是按位置存值,列表当然能完成任务;但当数据本身带有明确含义时,字典的可读性会明显更好。
# 列表方式(无法直接看出 98 是什么成绩)
list1 = ["语文", 98, "数学", 96, "英语", 100]
print(list1[1])   # 98

# 字典方式(一目了然)
dict1 = {"语文": 98, "数学": 96, "英语": 100}
print(dict1["语文"])   # 98
两段代码都能取到 98,但字典写法更容易看懂,也更适合后期维护。
字典的创建方式
字典最常见的创建方式有三种,分别适合直接声明、参数构造和批量拼装。
# 方式1:大括号直接创建
person = {'name': 'Alice', 'age': 25, 'city': 'New York'}

# 方式2:使用 dict() 构造函数
person2 = dict(name='Bob', age=30)

# 方式3:两个列表拼成字典(使用 zip)
keys = ['name', 'age', 'city']
values = ['charlie', 35, 'chicago']
dict3 = dict(zip(keys, values))
print(dict3)   # {'name': 'charlie', 'age': 35, 'city': 'chicago'}
其中 dict(zip(keys, values)) 在处理表头和数据列时很常见,尤其适合批量组装结构化数据。
获取、修改、添加与删除元素
字典的日常操作基本都围绕“查值”和“维护键值对”展开。这里最需要注意的是:dict[key] 取值直接但严格,键不存在就会抛出 KeyError;而 get() 更适合需要兜底的场景。
print(person['name'])        # Alice(如果键不存在会报错 KeyError)
print(person.get('age'))     # 25(键不存在返回 None,不报错)
# 修改已存在的键
person['age'] = 26

# 添加新键值对(直接赋值不存在的键)
person['email'] = 'alice@example.com'
print(person)   # {'name': 'Alice', 'age': 26, 'city': 'New York', 'email': 'alice@example.com'}
# del 语句
del person['city']

# pop() 方法:删除并返回对应的值
email = person.pop('email')
print(email)   # alice@example.com
简单理解就是:
[]适合确定键一定存在的场景;get()适合不确定键是否存在时安全读取;- 直接赋值既能修改已有键,也能新增键;
del和pop()都能删除,区别在于pop()还能拿到被删除的值。
这些字典方法最常用
| 方法 | 作用 |
keys() | 返回所有键(可遍历) |
values() | 返回所有值 |
items() | 返回所有键值对(元组形式) |
get(key) | 安全获取值,不存在返回 None |
pop(key) | 删除指定键并返回值 |
update(other) | 用另一个字典更新当前字典 |
copy() | 浅拷贝 |
如果你经常要遍历整份数据,items() 会比单独取键再查值更顺手;如果需要批量更新,update() 通常比逐个赋值更省事。
字典综合练习:个人信息管理
下面这段代码把创建、读取、修改、删除和批量更新串到了一起,适合用来理解字典的完整使用流程。
# 1. 创建字典
person = {'name': 'Da vid', 'age': 40, '职业': '工程师'}

# 2. 获取名字
print("Name:", person['name'])

# 3. 修改年龄
person['age'] = 41
print("Updated Age:", person['age'])

# 4. 添加邮箱
person['email'] = 'da vid@example.com'
print("Email:", person['email'])

# 5. 删除职业
del person['职业']
print("删除后的个人信息:", person)

# 6. 批量更新
person.update({'name': 'Da vid Smith', '城市': '旧金山'})
print("更新后的信息:", person)
元组适合哪些“不能改”的数据
元组(tuple)是不可变序列,用圆括号 () 表示。它和列表很像,也支持下标访问、切片和长度计算,但关键区别在于:一旦创建,元素本身不能再改。
因此,元组常用于坐标、日期、配置项这类“内容固定、语义稳定”的数据。
创建元组时最容易忽略的细节
元组本身不复杂,但单元素元组是非常高频的考点和坑点。
# 包含多个元素
tuple1 = (1, 2, 3)

# 空元组
tuple2 = ()

# 单个元素的元组(注意逗号!)
tuple3 = (4,)   # 如果不加逗号,会被当作整数 4
print(type(tuple3))   # <class 'tuple'>
(4) 只是带括号的整数,(4,) 才是真正的单元素元组,这一点必须记住。
元组同样支持访问与切片
tuple5 = (12, 13, 14, 15, 16)
print(tuple5[1])      # 13
print(tuple5[1:4])    # (13, 14, 15)
print(len(tuple5))    # 5
也就是说,元组不是“不能动就什么都干不了”,它只是不能原地改值,读取和切片能力与列表很接近。
不可变到底意味着什么
所谓不可变,主要指不能通过下标重新赋值,也不能像列表那样随意增删元素。
tuple7 = (20, 21, 22)
# tuple7[0] = 23   # 会引发 TypeError: 'tuple' object does not support item assignment
如果你的数据天然应该保持稳定,元组会比列表更合适;如果后续还要频繁修改,还是优先用列表。
列表和元组之间如何转换
实际开发里,经常会先把一组可迭代数据转成元组,用来表达“这里的数据结构已经固定”。
# 将列表转换为元组
list_to_tuple = tuple([6, 7, 8, 9])
print(list_to_tuple)   # (6, 7, 8, 9)
集合为什么是去重和运算利器
集合(set)是无序且元素唯一的数据结构。它同样使用大括号 {} 表示,但这里有个关键区别:空的 {} 不是集合,而是字典,空集合必须写成 set()。
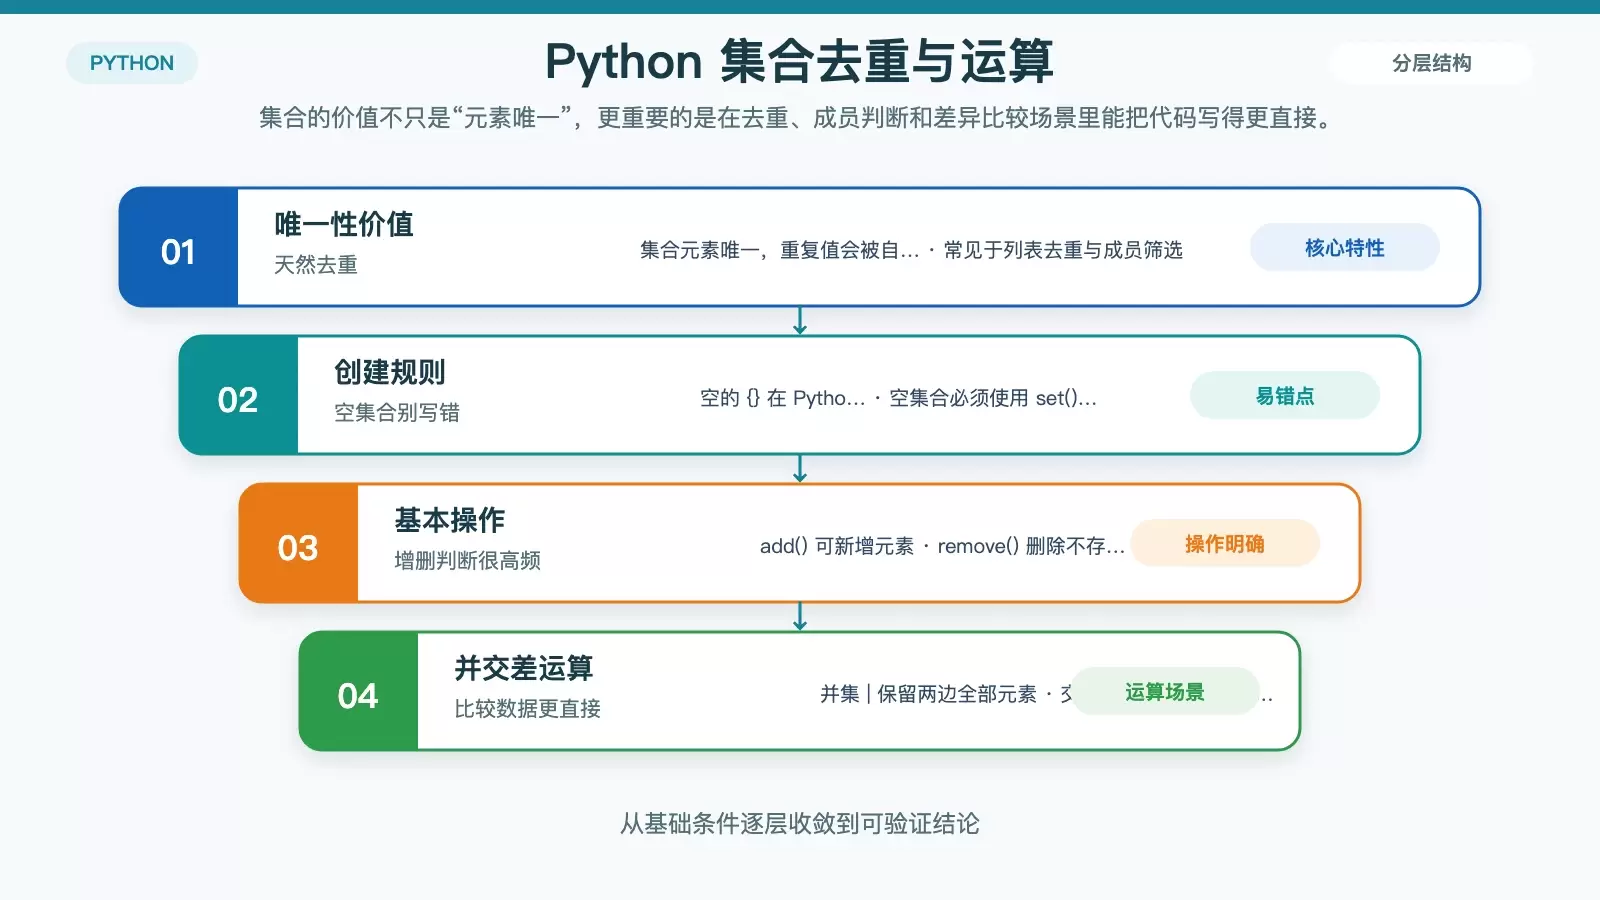
集合最典型的两个用途,就是去重和数学集合运算。
创建集合时要先分清空集合写法
# 使用大括号
set1 = {1, 2, 3, 4, 5}

# 使用 set() 函数(可去重)
set2 = set([1, 2, 2, 3, 4, 4, 5])   # {1, 2, 3, 4, 5}

# 空集合(必须用 set(),不能用 {})
empty_set = set()
set([1, 2, 2, 3, 4, 4, 5]) 这类写法很常见,因为它能顺手把重复元素去掉。
集合的基本操作与删除差异
集合支持新增、删除、清空和成员判断,但由于它是无序结构,使用方式和列表并不一样。
# 添加元素
set1.add(6)

# 删除元素(如果元素不存在会报错 KeyError)
set1.remove(3)

# 清空集合
set1.clear()

# 判断元素是否存在
print(4 in set2)   # True
这里要重点记住:remove() 删除不存在的元素会报 KeyError。后面的方法表里提到的 discard(),则适合“删不掉也没关系”的场景。
并集、交集、差集怎么理解
集合真正体现优势的地方,是这些简洁直接的数学运算符。写法短,语义也很清楚。
setA = {1, 2, 3, 4}
setB = {3, 4, 5, 6}

# 并集(所有元素)
print(setA | setB)   # {1, 2, 3, 4, 5, 6}

# 交集(共同元素)
print(setA & setB)   # {3, 4}

# 差集(在A但不在B)
print(setA - setB)   # {1, 2}
当你需要找“重复项”“共同项”或“两份数据的差异”时,集合通常比手写循环更直接。
常用集合方法
| 方法 | 作用 |
add(element) | 添加元素 |
remove(element) | 删除元素(不存在则报错) |
discard(element) | 删除元素(不存在不报错) |
pop() | 随机移除并返回一个元素 |
clear() | 清空集合 |
集合综合练习
setA = {1, 2, 3, 4}
setB = {3, 4, 5, 6}

setA.add(7)
print("添加之后:", setA)   # {1, 2, 3, 4, 7}

setA.remove(2)
print("删除之后:", setA)   # {1, 3, 4, 7}

print("并集:", setA | setB)   # {1, 3, 4, 5, 6, 7}
print("交集:", setA & setB)   # {3, 4}
print("差集:", setA - setB)   # {1, 7}
练习题里最容易错的知识点
原文练习虽然覆盖了列表、字典、元组等基础内容,但如果把它当成复盘材料来看,最值得记住的其实是下面几个判断点:
- 字典不是按下标访问,而是按键访问,所以
print(d[0])这类写法会出错。 - 字典键重复时,后面的值会覆盖前面的值,因此
{'a':1, 'b':2, 'a':3}最终d['a']是3。 - 元组支持下标和切片,但不支持像列表那样修改元素。
- 单元素元组必须写成
(10,),否则只是普通整数。 - 列表删除重复元素时,常见做法是配合
while 8 in l:循环调用remove()。
编程题答案代码
1. 列表操作
l = [5, 8, 2, 9, 1, 8]

# a. 删除所有 8(使用循环,注意删除时倒序或用 while)
while 8 in l:
    l.remove(8)

# b. 末尾添加 10
l.append(10)

# c. 修改索引 2 的元素为 7
l[2] = 7

# d. 打印
print(l)   # [5, 2, 7, 1, 10]
2. 字典操作
student = {'name': '张三', 'score': 85, 'gender': '男'}

# a. 新增 age
student['age'] = 18

# b. 修改分数
student['score'] = 90

# c. 删除 gender
del student['gender']

# d. 打印所有键和所有值
print("键:", student.keys())
print("值:", student.values())
3. 嵌套列表取值(选做题)
l = ['python', ['ja va', ['c++', 'ja vascript'], 'php'], 'ruby']
# ja vascript 在 l[1][1][1]
print(l[1][1][1])   # ja vascript
这三种数据结构该怎么选
最后可以用一句话概括三者的定位:
- 字典:适合“给定键,快速拿值”的结构化数据。
- 元组:适合“创建后不希望被修改”的固定数据。
- 集合:适合“去重、成员判断、找交并差”的数据处理任务。
如果你在写 Python 时总觉得“能跑,但结构不顺手”,通常不是语法问题,而是数据结构没选对。把这三种类型的边界和场景分清楚,后面的代码会顺很多。









