


很多质数判断代码的问题,不在算法本身,而在“默认输入总是合法”这个前提。一旦用户输入了非整数、超范围数字,或者业务上根本不该参与判断的值,程序就容易出现误判、报错甚至运行时异常。
这篇文章把流程拆成三步:先做输入验证,再选择合适的质数检测方法,最后补上错误处理和日志记录。读完之后,你可以更清楚地判断哪些校验必须放在前面、不同算法适合什么场景,以及一套完整的 C++ 实现该如何组织。
为什么要先做输入验证
在执行质数检查前,先把输入挡在入口处,是保证程序可靠性的第一步。输入验证的目标很明确:只让符合预期的数据进入后续逻辑。
这样做主要有几个直接收益:
- 防止无效数据进入系统。
- 增强程序安全性。
- 提高整体软件可靠性。
- 减少潜在的运行时错误。
对于质数判断这类逻辑,至少要先确认两件事:输入是不是整数,以及它是否落在允许范围内。只有这两步通过,后面的算法结果才有意义。
先检查输入是不是有效整数
类型检查负责排除掉非数字、空字符串或超出整数表示范围的内容。原文给出的做法是通过 std::stoi 配合 try-catch 完成解析:
bool isValidInteger(const std::string& input) {
    try {
        std::stoi(input);
        return true;
    } catch (const std::invalid_argument& e) {
        return false;
    } catch (const std::out_of_range& e) {
        return false;
    }
}
这段代码的作用很直接:能成功转换成整数就返回 true,遇到非法文本或数值越界则返回 false。
再限制数值范围
即便输入可以转成整数,也不代表它适合直接拿去做质数判断。比如小于 2 的数本身就不满足质数定义,过大的输入也可能带来不必要的性能开销。
原文中的范围校验函数如下:
bool isWithinRange(int value, int min, int max) {
    return (value >= min && value <= max);
}
如果业务约定只处理 2 - 1000000 之间的整数,那么范围判断就应该在质数检测之前完成,而不是等算法跑起来后再补救。
输入验证的基本流程
把入口逻辑串起来,流程其实很清楚:先接收输入,验证格式和范围,失败就反馈错误,成功才进入处理阶段。
graph TD
    A[用户输入] --> B{验证输入}
    B -->|有效| C[处理输入]
    B -->|无效| D[显示错误消息]
    D --> E[请求正确输入]
常见验证策略可以归纳为三类:
| 策略 | 描述 | 示例 |
|---|---|---|
| 类型检查 | 验证输入类型 | 确保输入为数字 |
| 范围验证 | 检查输入边界 | 1 - 100的范围 |
| 格式验证 | 匹配特定模式 | 电子邮件格式 |
这类逻辑的实践重点也很明确:
- 始终验证用户输入。
- 使用try-catch块。
- 提供清晰的错误消息。
- 实现多层验证。
如何把质数输入校验写成可复用函数
把整数解析和范围判断合并在一个函数里,是比较实用的组织方式。这样做的好处是:所有入口都复用同一套规则,后续调用质数算法前也不需要反复写重复判断。
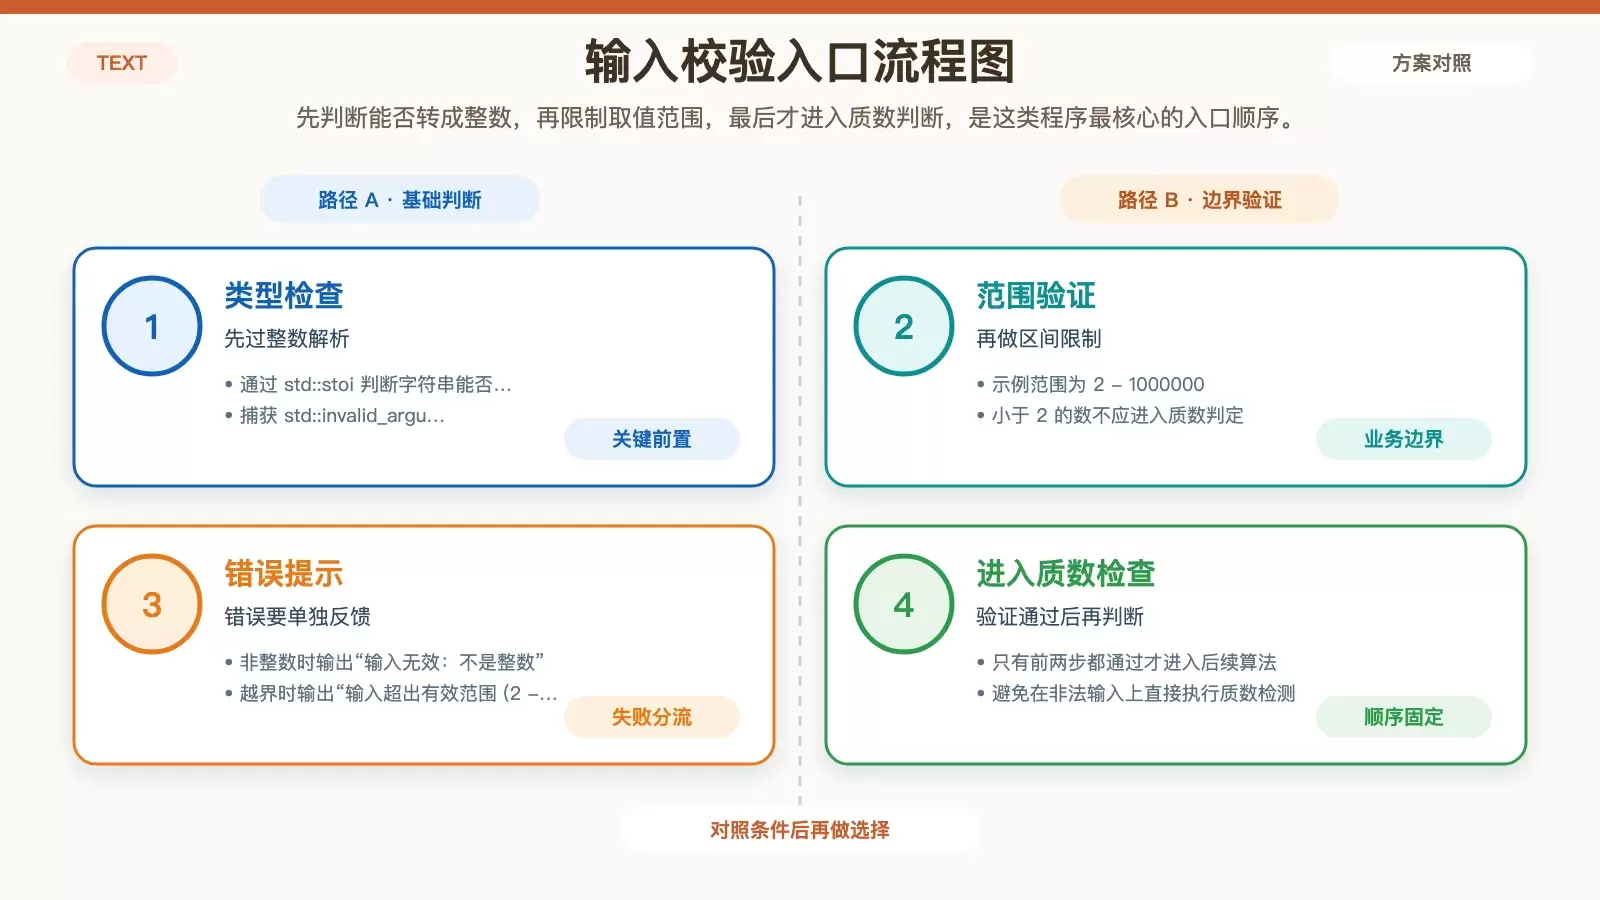
原文给出的完整示例如下:
bool validatePrimeInput(const std::string& input) {
    // 检查输入是否为有效的整数
    if (!isValidInteger(input)) {
        std::cerr << "输入无效:不是整数" << std::endl;
        return false;
    }

    int number = std::stoi(input);

    // 检查范围
    if (!isWithinRange(number, 2, 1000000)) {
        std::cerr << "输入超出有效范围 (2 - 1000000)" << std::endl;
        return false;
    }

    return true;
}
这段代码体现了一个很重要的顺序:先判断能不能转成整数,再去做范围校验。否则在输入本身非法时,后续的 std::stoi 会直接抛出异常。
输入通过后,质数判断该怎么选
输入验证解决的是“能不能处理”,质数算法解决的是“怎么判断”。两者不是替代关系,而是前后衔接的两层逻辑。
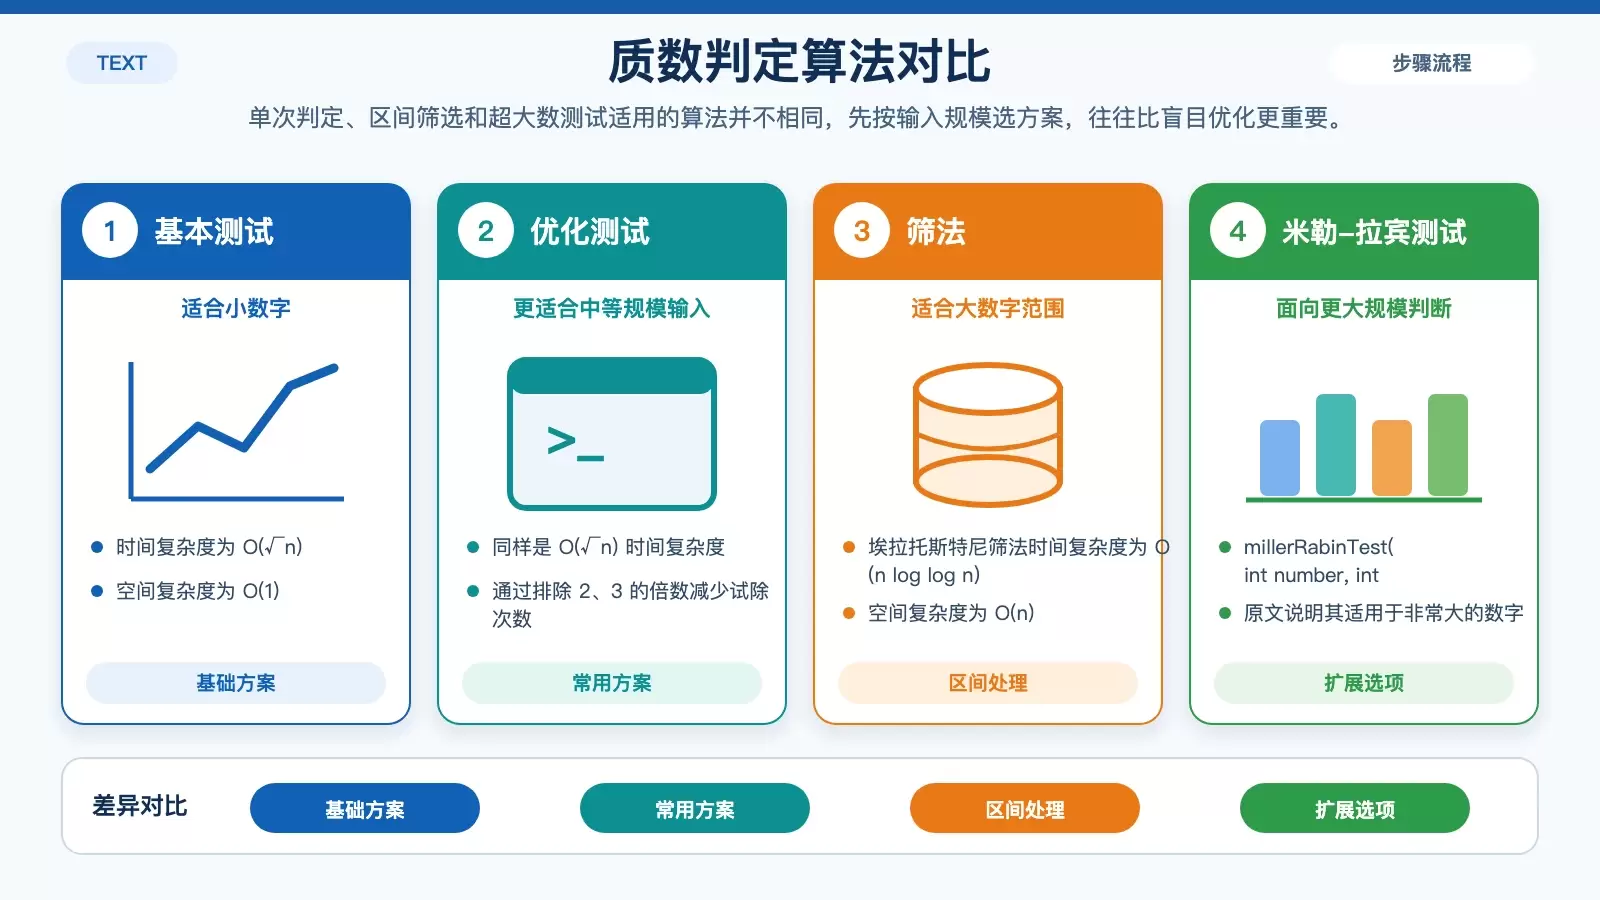
先回到定义:质数是大于 1 的自然数,且只能被 1 和它自身整除。也正因为如此,像 0、1 和负数,应该在输入阶段就被排除掉。
基础质数测试
最常见的写法是从 2 开始遍历到 i * i <= number,只要发现一个因子就可以提前返回:
bool isPrime(int number) {
    if (number <= 1) return false;

    for (int i = 2; i * i <= number; ++i) {
        if (number % i == 0) {
            return false;
        }
    }
    return true;
}
这个版本容易理解,适合演示原理和处理较小数字。
优化后的质数测试
如果希望减少无意义的试除次数,可以先排除 2、3 的倍数,再以 6k ± 1 的形式继续检查:
bool isPrimeOptimized(int number) {
    if (number <= 1) return false;
    if (number <= 3) return true;

    if (number % 2 == 0 || number % 3 == 0) return false;

    for (int i = 5; i * i <= number; i += 6) {
        if (number % i == 0 || number % (i + 2) == 0) {
            return false;
        }
    }
    return true;
}
这类优化不改变核心时间复杂度,但能在中等规模输入下减少循环次数,通常比基础版本更适合实际使用。
不同算法适用什么场景
原文还给出了几种常见方案的对比:
| 算法 | 时间复杂度 | 空间复杂度 | 适用范围 |
|---|---|---|---|
| 基本测试 | O(√n) | O(1) | 小数字 |
| 优化测试 | O(√n) | O(1) | 中等大小数字 |
| 埃拉托斯特尼筛法 | O(n log log n) | O(n) | 大数字范围 |
如果只是对单个输入做判断,通常基础测试或优化测试就够用;如果需要处理一整段数字区间,筛法会更合适。原文也提到概率性质数测试:
bool millerRabinTest(int number, int k = 5) {
    if (number <= 1 || number == 4) return false;
    if (number <= 3) return true;

    // 实现米勒 - 拉宾概率性质数测试
    // 更复杂的实现以进行可靠的质数检查
    // 适用于非常大的数字
}
这说明当输入规模继续增大时,算法选择本身也会成为设计重点。
一套完整的“验证后再判断”实现
把输入验证和质数检测串起来,才能形成真正可用的业务流程。原文的综合示例如下:
bool validateAndCheckPrime(const std::string& input) {
    // 输入验证
    if (!isValidInteger(input)) {
        std::cerr << "输入无效:不是整数" << std::endl;
        return false;
    }

    int number = std::stoi(input);

    // 范围验证
    if (number < 2 || number > 1000000) {
        std::cerr << "输入超出有效范围 (2 - 1000000)" << std::endl;
        return false;
    }

    // 质数检查
    if (isPrimeOptimized(number)) {
        std::cout << number << " 是一个质数" << std::endl;
        return true;
    } else {
        std::cout << number << " 不是一个质数" << std::endl;
        return false;
    }
}
对应流程也可以用图表示为:
graph TD
    A[输入数字] --> B{验证输入}
    B -->|有效| C{是质数吗?}
    C -->|是| D[质数]
    C -->|否| E[不是质数]
    B -->|无效| F[错误处理]
这里有一个值得注意的设计点:函数返回 bool 时,既要表示“输入是否合法”,又要表示“该数是不是质数”,语义会混在一起。示例适合入门,但到了真实项目中,通常需要更明确的结果类型来区分这两类状态。
实际使用时,可以重点考虑这几件事:
- 根据输入大小选择合适的算法。
- 考虑性能影响。
- 实现健壮的错误处理。
- 使用高效的验证技术。
错误处理怎么补齐,程序才算稳妥
当输入验证和质数判断接入真实程序后,错误处理就不只是“输出一句提示”这么简单了。你需要区分错误类型、决定反馈方式,并在必要时记录日志,方便排查问题。
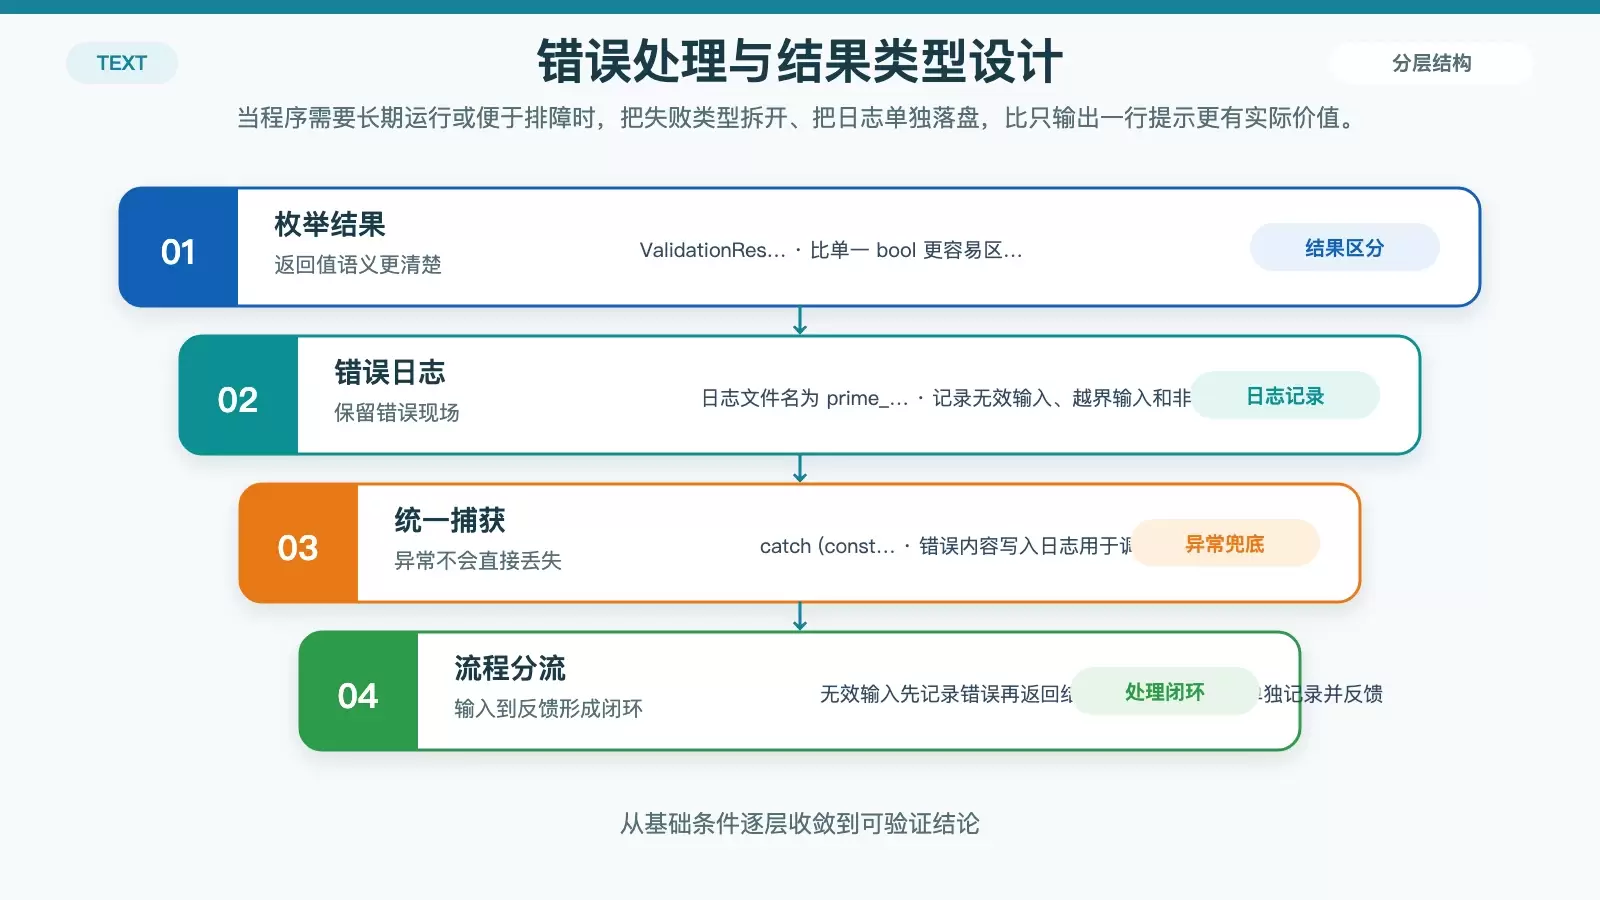
原文先把错误来源概括成三类:
graph TD
    A[错误类型] --> B[语法错误]
    A --> C[逻辑错误]
    A --> D[运行时错误]
用异常表达明确的验证失败
如果你希望把验证失败当成清晰的错误事件处理,可以定义自定义异常:
class PrimeValidationException : public std::exception {
private:
    std::string errorMessage;

public:
    PrimeValidationException(const std::string& message)
        : errorMessage(message) {}

    const char* what() const noexcept override {
        return errorMessage.c_str();
    }
};

void validatePrimeInput(int number) {
    try {
        if (number < 2) {
            throw PrimeValidationException("输入必须大于1");
        }

        if (!isPrime(number)) {
            throw PrimeValidationException("数字不是质数");
        }
    }
    catch (const PrimeValidationException& e) {
        std::cerr << "验证错误:" << e.what() << std::endl;
    }
}
这种方式的好处是错误信息更具体,调用方也更容易区分不同失败原因;代价则是异常本身会带来一定性能开销。
异常、错误码和错误标志怎么取舍
原文对几种常见策略做了对比:
| 策略 | 描述 | 优点 | 缺点 |
|---|---|---|---|
| 异常处理 | 抛出并捕获错误 | 详细的错误信息 | 性能开销 |
| 错误码 | 返回整数值错误码 | 轻量级 | 描述性较差 |
| 错误标志 | 设置布尔型错误标志 | 实现简单 | 错误细节有限 |
如果程序只是命令行小工具,错误码和布尔标志已经够用;如果系统需要持续运行、排障和监控,自定义异常加日志通常更有价值。
日志记录与结果类型设计
为了保留错误现场,原文还加入了一个简单日志器:
class ErrorLogger {
public:
static void log(const std::string& errorMessage) {
std::ofstream logFile("prime_validation_errors.log", std::ios::app);
if (logFile.is_open()) {
logFile << "[" << getCurrentTimestamp() << "] "
<< errorMessage << std::endl;
logFile.close();
}
}
private:
static std::string getCurrentTimestamp() {
auto now = std::chrono::system_clock::now();
std::time_t currentTime = std::chrono::system_clock::to_time_t(now);
return std::ctime(¤tTime);
}
};
在此基础上,再用枚举结果区分“有效”“输入非法”“不是质数”,就比单一的 bool 更适合真实场景:
class PrimeValidator {
public:
    enum class ValidationResult {
        Valid,
        InvalidInput,
        NotPrime
    };

    ValidationResult validate(const std::string& input) {
        try {
            // 输入验证
            if (!isValidInteger(input)) {
                ErrorLogger::log("无效的整数输入:" + input);
                return ValidationResult::InvalidInput;
            }

            int number = std::stoi(input);

            // 范围验证
            if (number < 2 || number > 1000000) {
                ErrorLogger::log("输入超出有效范围:" + std::to_string(number));
                return ValidationResult::InvalidInput;
            }

            // 质数检查
            if (!isPrimeOptimized(number)) {
                ErrorLogger::log("不是质数:" + std::to_string(number));
                return ValidationResult::NotPrime;
            }

            return ValidationResult::Valid;
        }
        catch (const std::exception& e) {
            ErrorLogger::log("意外错误:" + std::string(e.what()));
            return ValidationResult::InvalidInput;
        }
    }
};
对应的处理流程如下:
graph TD
    A[接收到输入] --> B{验证输入}
    B -->|有效| C{是质数吗?}
    B -->|无效| D[记录错误]
    C -->|质数| E[处理数字]
    C -->|不是质数| F[记录非质数]
    D --> G[返回错误]
    F --> G
这类写法的价值在于,输入错误、非质数结果、运行时异常被分开处理,业务逻辑更清晰,日志也更容易追踪。
实战中该优先落实哪些点
如果你只是想快速把这套思路落地,优先级可以这样排:
- 先做整数校验,避免直接对非法字符串调用
std::stoi。 - 明确范围限制,例如
2 - 1000000,把无意义输入挡在前面。 - 单次判断优先使用
isPrimeOptimized这类 O(√n) 方法。 - 不要只返回一个模糊的
bool,尽量区分非法输入和“不是质数”。 - 需要排障时,加上异常信息和日志记录。
归根结底,可靠的质数检查并不只是写出一个判定函数,而是把输入验证、算法选择和错误处理连成一条完整链路。这样程序面对真实输入时,结果才既正确,也足够稳妥。









