

多数据库获取每组第一条记录的方法(MySQL、SQL Server、Oracle)

在实际开发中,提取日志表、操作流水等数据时,往往需要获取每个分组(如用户ID、设备编号)下的最新一条或特定排序的第一条记录。不同数据库系统对此有不同的实现方式:MySQL 依赖 LIMIT,SQL Server 可借助自连接与 TOP,而 Oracle 推荐使用高效的 ROW_NUMBER() 窗口函数。本文梳理了各平台的核心语法与应用场景。
结果与目标:精准提取分组首条数据
面对结构化的分组数据,目标是基于某一排序规则(通常是时间倒序或主键顺序),在每个分区内筛选出排第一的那一行完整数据。这不仅涉及查询语法的正确性,更关乎处理效率。
准备条件:理解核心概念
在进行具体操作前,需明确两个关键概念:
- 排序优先级:确定何为“第一条”。通常为创建时间最近的记录或 ID 最大的记录。
- 窗口函数支持度:现代数据库普遍支持窗口函数,但在处理超大数据集时比传统
GROUP BY更为灵活且性能通常更优。
真实操作顺序
第1步:使用窗口函数(适用于 Oracle/MySQL 8.0+/PostgreSQL 等)
这是目前业界处理此类问题最标准、最高效的方法。利用 OVER (PARTITION BY ... ORDER BY ...) 语法为每一行打上序号,随后在外层筛选序号为 1 的记录。
以 Oracle 为例,将数据按 type 字段分组,并按 code 升序取最小值(即第一条):
SELECT * FROM (
    SELECT z.type,
           z.code,
           ROW_NUMBER() OVER (PARTITION BY z.type ORDER BY z.code) AS code_id
    FROM group_info z
)
WHERE code_id = 1;
说明: PARTITION BY 的作用类似于聚合中的 GROUP BY,用于划分数据块;ORDER BY 决定了块内的排序方向。此方法能保留该行的所有字段信息,优于直接使用聚合函数只返回部分列的做法。
第2步:使用自连接查询(适用于 SQL Server 等)
在 SQL Server 中,可以通过自连接结合 TOP 1 来实现类似效果。适用于老旧版本的数据库或不支持窗口函数的场景。
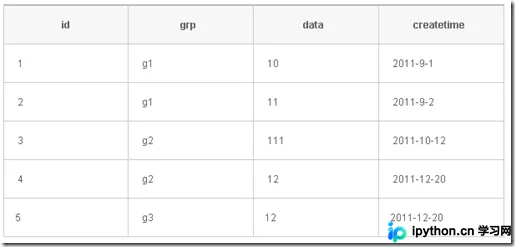
例如从表 t1 中提取每条 grp 下按时间倒序排列的第一条有效数据:
SELECT *
FROM t1 t
WHERE id = (SELECT TOP 1 id FROM t1 WHERE grp = t.grp ORDER BY createtime DESC)
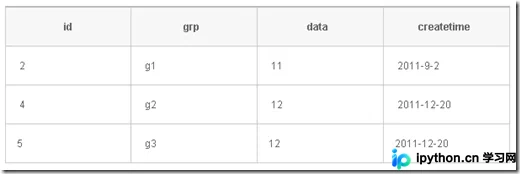
结果分析: 上述语句执行后,会过滤出仅包含各组最新状态的数据行。
第3步:使用 LIMIT 限制数量(适用于 MySQL 简单场景)
如果目标仅仅是获取全局或者某个大集合中的前几条记录,而非“严格意义上的每个分组”,可以使用 LIMIT。需注意它必须在 ORDER BY 之后执行。
获取某表任意的前 10 条记录的通用语法:
SELECT * FROM 表名 LIMIT 0, 10;
参数说明: LIMIT 接受一个或两个整数参数。第一个指定起始偏移量(初始值为 0,非 1),第二个指定最大返回行数。
实战示例:获取消耗次数最多的单一设备记录:
SELECT count(1), tpc_equipment_code
FROM tb_parts_consume
GROUP BY tpc_equipment_code
ORDER BY count(1) DESC
LIMIT 1;
完成判断
当执行上述任一查询后,若返回的行数等于预期的分组数(如设备总数),且每行数据均符合排序逻辑(如时间最近或ID最大),即判定为成功获取第一条记录。建议先在测试环境中验证 WINDOW 函数与旧版兼容写法的结果一致性。
原文有依据的排错
- 语法校验:在使用传统的
GROUP BY配合聚合函数时,SELECT后的非聚合列必须出现在GROUP BY子句中,否则会导致 SQL 语法报错。窗口函数法天然规避了此限制。 - 偏移起点:在 MySQL
LIMIT m, n中,偏移量默认从 0 开始计算,请勿误写成 1。
简要总结
综上,针对各类关系型数据库提取分组首条记录的方案各有侧重。首选 ROW_NUMBER() 窗口函数,兼顾性能与完整性;受限环境可退求其次使用自连接加 TOP 或 LIMIT 截断技巧。以上就是获取每组第一条记录方法的详细内容,更多关于数据库优化技术的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









