

C#装箱和拆箱原理解析:值类型与引用类型的转换机制

发布时间:2026-10-13| 4人浏览过
C#中的装箱和拆箱是值类型与引用类型相互转换的关键机制。装箱将值类型复制到托管堆并包装为引用类型,而拆箱则提取已装箱的值。了解这一原理有助于识别潜在的运行时性能瓶颈,特别是在处理集合类或方法参数泛型化时。
核心概念:对象基类与类型系统
在.NET框架中,System.Object是所有类型的最终基类。无论是值类型(如 int, struct)还是引用类型(如 class),都隐式继承自 object。这意味着任何类型的值都可以被赋值给 object 类型的变量。然而,这种通用性背后隐藏着内存布局的根本差异:
- 值类型:通常存储在栈(Stack)中,直接包含数据。
- 引用类型:实例存储在托管堆(Heap)上,栈中仅保存指向堆内存的引用指针。
第一步:理解装箱(Boxing)机制
装箱是一个隐式过程,它将值类型转换为 object 类型或该值类型所实现的接口类型。当发生装箱时,CLR会在托管堆上分配一个新的对象实例,并将值类型的字段拷贝到该新对象中。
1.1 装箱的操作入口与动作
当代码中将值类型赋值给 object 变量时,自动触发装箱。
int age = 24; // 1. 在栈中创建整数值 24
object refAge = age; // 2. 触发装箱:
                     // - CLR 在托管堆分配内存
                     // - 将 24 复制到堆上的新对象中
                     // - 返回堆中对象的引用给 refAge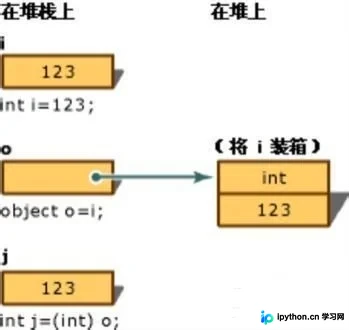
关键点:
- 装箱创建了值的一个全新副本。
- 原始值类型变量(
age)保持不变。 - 这是一个涉及内存分配和数据拷贝的昂贵操作。
第二步:掌握拆箱(Unboxing)过程
拆箱是显式过程,它从对象中提取值类型。拆箱不复制数据,而是计算堆中已装箱数据的地址,并将其作为值类型返回。
2.1 拆箱的操作入口与参数要求
拆箱必须使用强制类型转换,且目标类型必须严格匹配最初装箱的类型。
// 正确的拆箱
int newAge = (int)refAge;

// 错误的拆箱(运行时异常)
// string s = (string)refAge; // InvalidCastExpception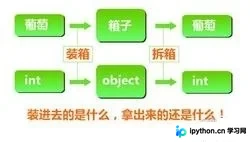
注意事项:
- 类型一致性:如果试图将一个装箱后的
int拆箱为long、float或string,程序将在运行时抛出InvalidCastException。 - 性能开销:虽然拆箱本身比装箱快,但频繁的拆箱同样暗示着不当的类型使用模式。
第三步:评估性能影响与最佳实践
虽然单次装箱/拆箱在现代CPU上可能只需纳秒级时间,但在高循环或大数据量场景下,其累积开销不可忽视:
- 内存压力:每次装箱都在堆上创建新对象,增加了GC(垃圾回收)的压力。
- 缓存失效:访问堆内存通常比访问栈内存慢,因为堆数据可能不在CPU缓存中。
3.1 避免不必要的装箱
在使用泛型集合(如 List<T>)而非非泛型集合(如 ArrayList)时,编译器可以在编译期确定类型,从而消除装箱需求。
// 推荐:使用泛型,无装箱
List<int> list = new List<int>();
list.Add(24);

// 不推荐:ArrayList会导致装箱
ArrayList arrayList = new ArrayList();
arrayList.Add(24); // 触发装箱
int i = (int)arrayList[0]; // 触发拆箱
总结
装箱和拆箱是C#类型系统的基石,实现了值类型与引用类型的互通。核心原则是:装箱=值到堆的拷贝(隐式),拆箱=堆到值的提取(显式)。开发者应优先使用泛型和强类型编程,以减少隐式装箱带来的性能损耗和内存碎片。以上就是关于C#装箱和拆箱原理的详细解析,更多关于C#底层机制的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









