

MySQL ORDER BY 实现原理:利用索引排序与文件排序优化

在处理 MySQL 数据排序时,理解 ORDER BY 的执行机制是性能优化的关键。主要存在两种路径:一是利用已建立的有序索引直接返回结果,无需额外排序;二是当缺乏合适索引时,通过文件排序算法在内存中完成排序。掌握这两种方式的判断条件及参数调优,能显著降低系统负载并提升响应速度。
结果或目标
明确 MySQL 在执行 ORDER BY 语句时的内部运作方式,识别何时可以免费利用索引顺序,何时必须触发文件排序,并通过调整系统参数优化排序过程,避免不必要的磁盘 IO 和性能瓶颈。
准备条件
为了直观展示两种排序实现方式及其图解,我们基于以下两个 MyISAM 引擎表结构进行分析:
- 表 A:
CREATE TABLE `A` (

  `c1` int(11) NOT NULL default '0',

  `c2` char(2) default NULL,

  `c3` varchar(16) default NULL,

  `c4` datetime default NULL,

  PRIMARY KEY (`c1`)

) ENGINE=MyISAM DEFAULT CHARSET=utf8 - 表 B:
CREATE TABLE `B` (

  `c1` int(11) NOT NULL default '0',

  `c2` char(2) default NULL,

  `c3` varchar(16) default NULL,

  PRIMARY KEY (`c1`),

  KEY `B_c2_ind` (`c2`)

) ENGINE=MyISAM DEFAULT CHARSET=utf8
真实操作顺序
第1步:利用有序索引进行排序(最优场景)
目的:利用索引的天然有序性,避免任何额外的排序开销。
入口:查询条件中的排序字段与索引键完全一致。
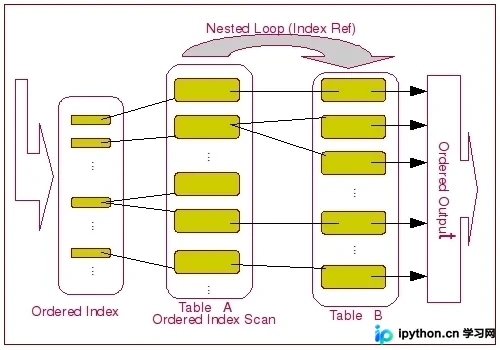
动作:当 ORDER BY 的条件与查询所利用的索引键(或前几个索引键)完全匹配,且索引访问方式为 range、ref 或 index 时,MySQL 可以直接按索引顺序读取数据。
示例:对表 A 和 B 执行如下查询,并按主键 A.c1 排序:
EXPLAIN SELECT A.* FROM A, B

WHERE A.c1 > 2 AND A.c2 < 5 AND A.c2 = B.c2

ORDER BY A.c1;可观察的完成状态:执行计划显示 Table A 使用了 PRIMARY 索引(type: range),Table B 使用了 B_c2_ind(type: ref)。Extra 列仅显示 “Using where”,没有 “Using filesort”。这表明 MySQL 无需进行实际排序操作,直接从索引中获取已排好序的数据。
其执行流程示意如下:
第2步:通过文件排序算法在内存中排序(Fallback 场景)
目的:在没有可用有序索引时,通过算法在内存缓冲区完成数据排序。
入口:执行计划中出现 “Using filesort”。
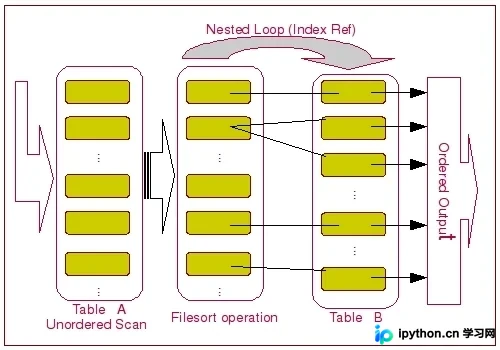
动作:当无法利用索引获得有序数据时,MySQL 会将满足条件的数据取出并在内存区域(由 sort_buffer_size 设定)进行排序。该缓冲区是每个线程独享的,并发高时可能占用较多内存。MySQL 4.1 引入了两种排序算法:
- 传统算法:先取出排序字段和行指针,在
sort_buffer中排序,再回表获取完整数据。需要两次 IO。 - 改进算法:一次性取出所有需要的字段,直接在
sort_buffer中排序并返回。只需一次 IO,但消耗更多内存。
重要参数:max_length_for_sort_data。MySQL 比较此值与查询字段的总长度来决定算法:
- 若 max_length_for_sort_data 更大,使用改进算法(更高效,减少 IO);
- 反之,使用传统算法。
示例对比:将上述查询改为按非索引字段 A.c2 排序:
EXPLAIN SELECT A.* FROM A, B

WHERE A.c1 > 2 AND A.c2 < 5 AND A.c2 = B.c2

ORDER BY A.c2;可观察的完成状态:执行计划中 Table A 的 Extra 列出现 “Using where; Using filesort”。MySQL 从表 A 取出数据后,发现不符合有序索引要求,因此触发文件排序。
其执行流程示意如下:
完成判断与排错
多表 Join 的特殊限制
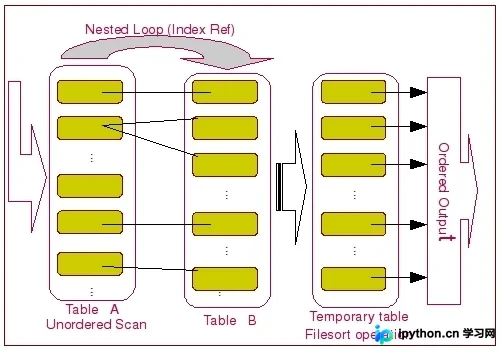
如果排序字段涉及多个表的 Join 结果,MySQL 的文件排序有一个限制:数据源必须来自单个表。在这种情况下,MySQL 会先创建一个临时表(Temporary Table)来存储 Join 后的中间结果,然后再对临时表进行排序。
示例:尝试按表 B 的非索引字段 B.c3 排序:
EXPLAIN SELECT A.* FROM A, B

WHERE A.c1 > 2 AND A.c2 < 5 AND A.c2 = B.c2

ORDER BY B.c3;可观察的完成状态:执行计划中 Table A 的 Extra 列显示 “Using temporary; Using filesort”。这是因为排序依据 B.c3 跨表,MySQL 必须先构建包含必要字段的临时表,再对其进行排序。
其实际执行逻辑示意如下:
简要总结
优化 MySQL 排序性能的核心在于引导查询走“利用有序索引”的路径。若不可避免需要使用文件排序,应重点监控和调整 max_length_for_sort_data 参数,确保系统倾向于使用更高效的改进算法(一次 IO 策略),从而缓解因大量排序等待导致的系统高负载问题。以上就是 MySQL ORDER BY 实现分析的详细内容,更多关于 SQL 优化与 MySQL 性能调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









