

R语言 aggregate 函数详解:数据分组聚合实战

在R语言的数据清洗与分析流程中,aggregate 函数是进行数据分组聚合(Group By)的首选工具之一。它能够将数据集按照特定的因子变量划分为不同组,并对各组内的数值型数据应用指定的统计函数(如均值、求和、最大值等)。本文将从创建示例数据出发,详细拆解 aggregate 函数的参数结构与实际调用方式。
了解 aggregate 函数功能
aggregate 函数的核心作用是“分组+聚合”。它可以接收一个包含多列的数据框(data frame),指定哪些列需要被聚合(通常是数值型列),以及依据哪些分类变量进行拆分。完成后,返回的结果是一个新的数据框,包含分组变量及其对应的聚合统计值。
如需查阅官方文档,可在R控制台中运行 help("aggregate") 获取详细说明。其基本语法结构通常涉及三个关键部分:待聚合的数据对象、定义分组的列表(by)、以及执行计算的函数(FUN)。
第1步:准备测试数据框
为了清晰展示函数行为,我们首先构建一个包含学生ID、班级、性别及两门学科成绩的模拟数据框。这一步的目的是生成具有明确分组特征的基础数据集。
操作入口:R控制台或脚本编辑器
具体动作:使用向量组合并转换为 data.frame。
studentID <- seq(1, 20)
gender <- rep(c("M", "M", "F", "F", "F"), 4)
math <- rep(c(92, 86, 85, 74, 82), 4)
english <- rep(c(76, 69, 82, 71, 80), 4)
class <- rep(c(paste0(c(1, 2, 2, 1),"班")), 5)
score <- data.frame(studentID, class, gender, math, english)
dim(score)
head(score)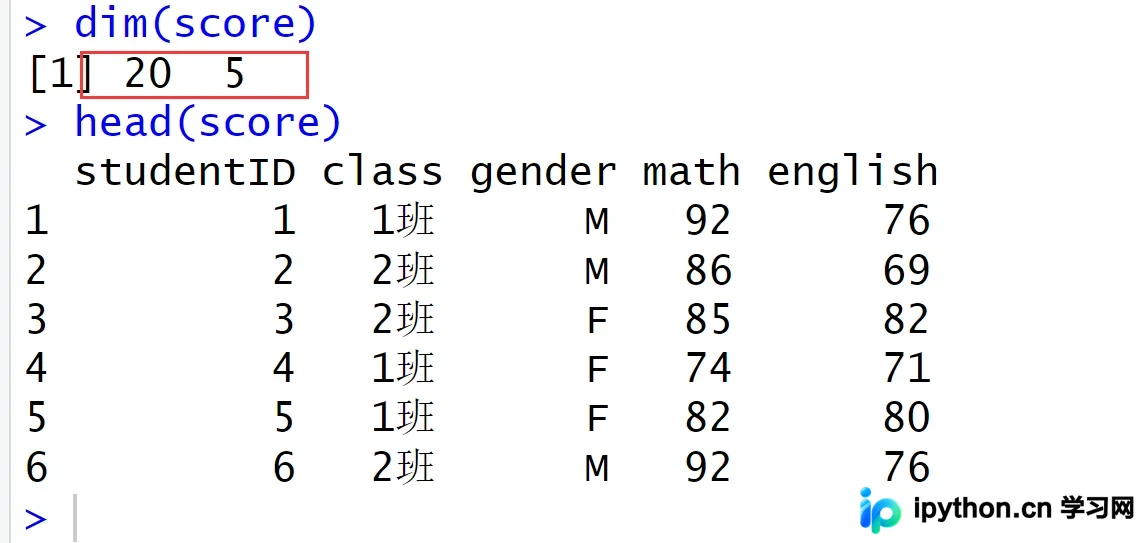
执行后,可以看到生成的 score 数据框包含20行数据,涵盖了不同的班级分布与性别比例,为后续的分组计算提供了充足样本。
第2步:调用 aggregate 进行多维度聚合
在数据就绪后,我们可以根据不同的分析需求,调整 by 列表的组件数量以及 FUN 函数的类型。以下是几种常见的应用场景。
单一维度分组:按性别统计英语平均分
当仅需依据单一变量(如性别)进行分类时,可将对应列直接放入列表中。以下代码针对 score 数据框的第5列(即english成绩)计算各性别的平均值。
aggregate(score[,5], by=list(score$gender), mean)多维度分组:按性别与班级统计总分
若需更细致的交叉分析,可以在 by 参数中添加多个向量。例如,同时考虑性别和班级两个因素,计算每组的总成绩。注意此处将统计函数由 mean 替换为 sum。
aggregate(score[,5], by=list(score$gender, score$class), sum)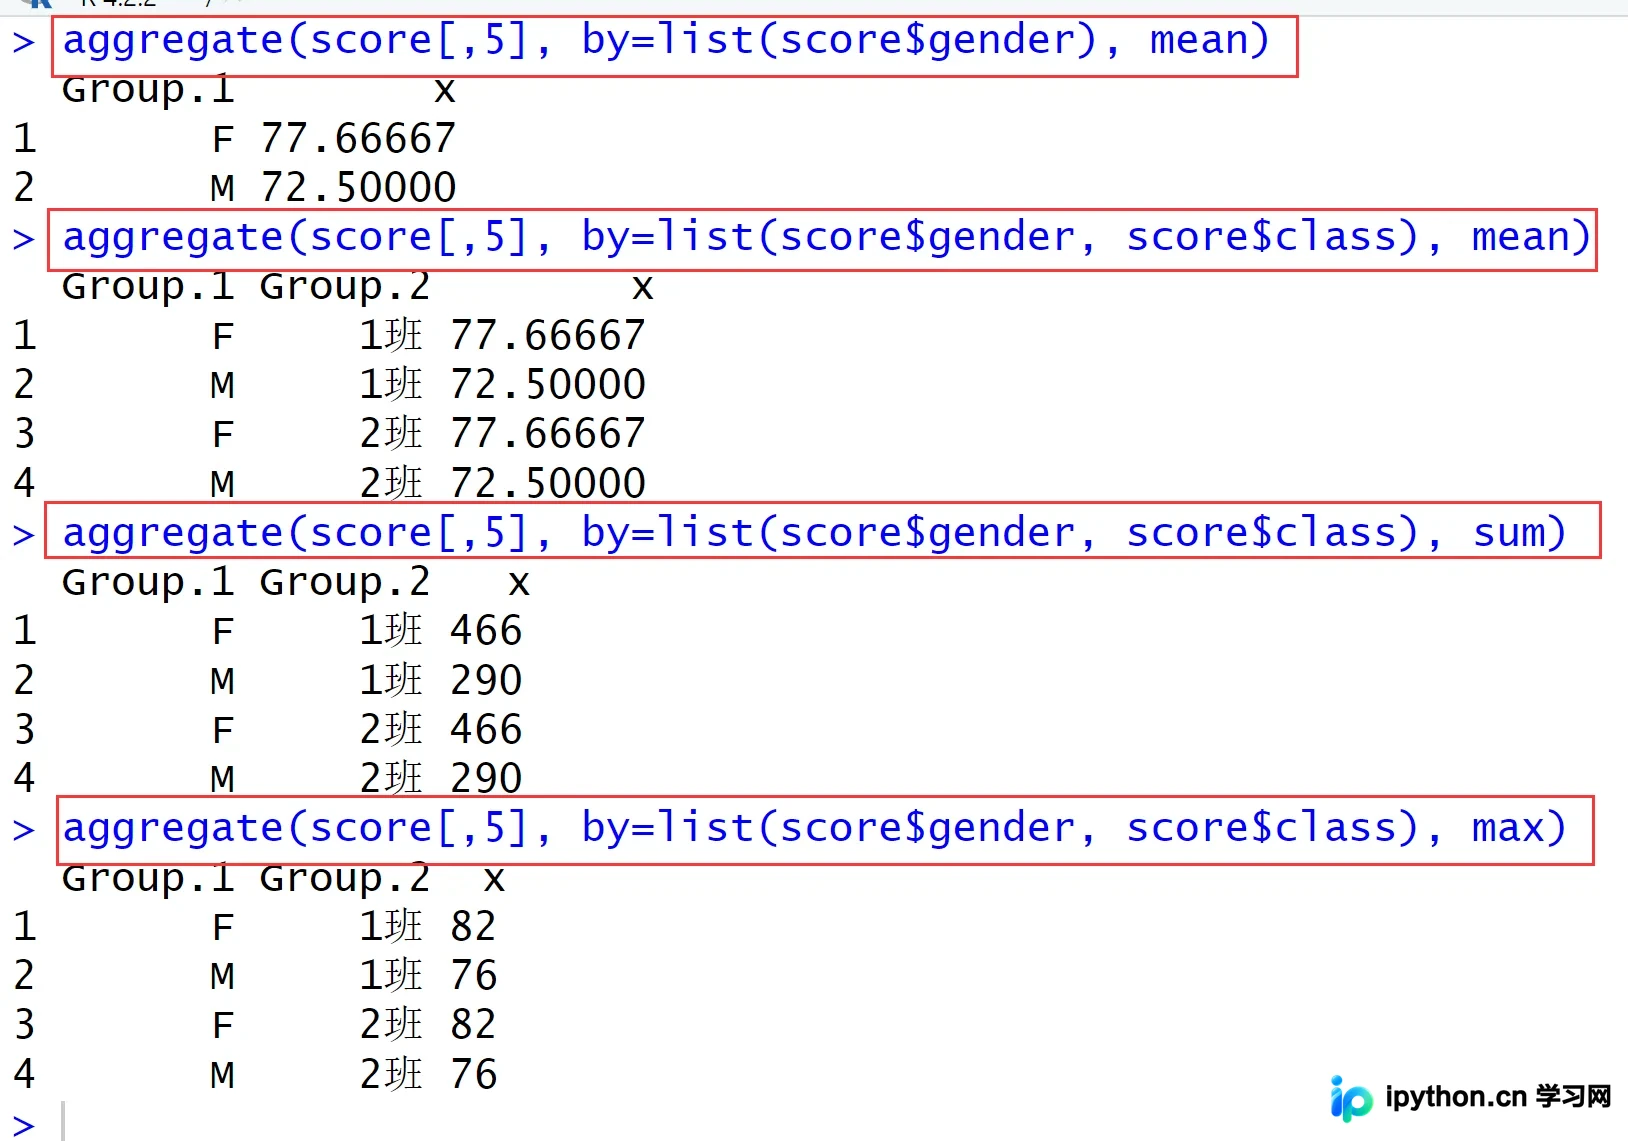
其他常用聚合操作
除了求均值和总和,aggregate 同样支持寻找极值。例如,获取每个小组的最高分:
aggregate(score[,5], by=list(score$gender, score$class), max)by 中以避免错误。
总结
aggregate 函数是R语言数据分析入门的必备技能。通过合理设置 by 列表实现灵活分组,并利用内置的统计函数完成均值、方差或极值的计算,能够高效解决大部分基础数据的归类汇总问题。熟练运用此函数,可显著提升数据预处理环节的工作效率。
以上就是R语言中aggregate函数详解的详细内容,更多关于R语言aggregate函数用法资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









