

R语言merge函数详解:数据框合并的6种核心场景与参数指南

R语言的merge函数是处理表格型数据的核心工具,常用于将两个数据框(data.frame)按照特定键(Key)进行关联。本文将通过具体的代码示例,详细说明如何进行基本匹配、全连接以及保留未匹配行的各种连接方式。
准备测试数据
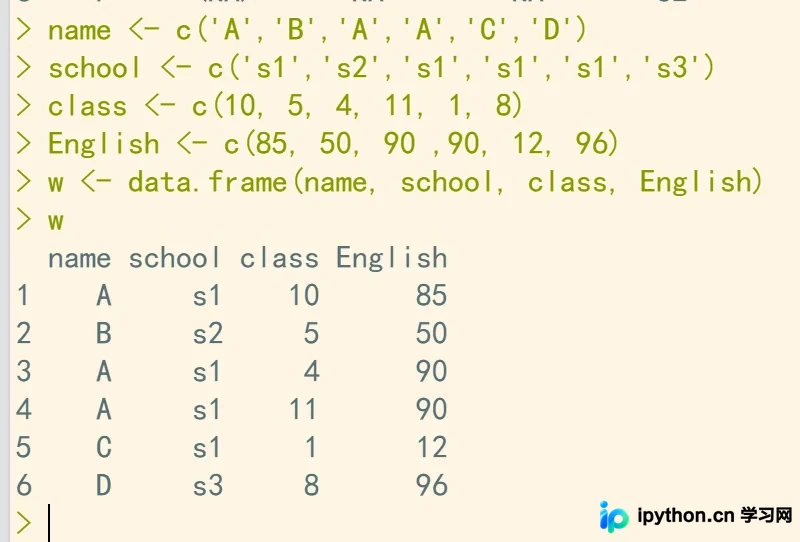
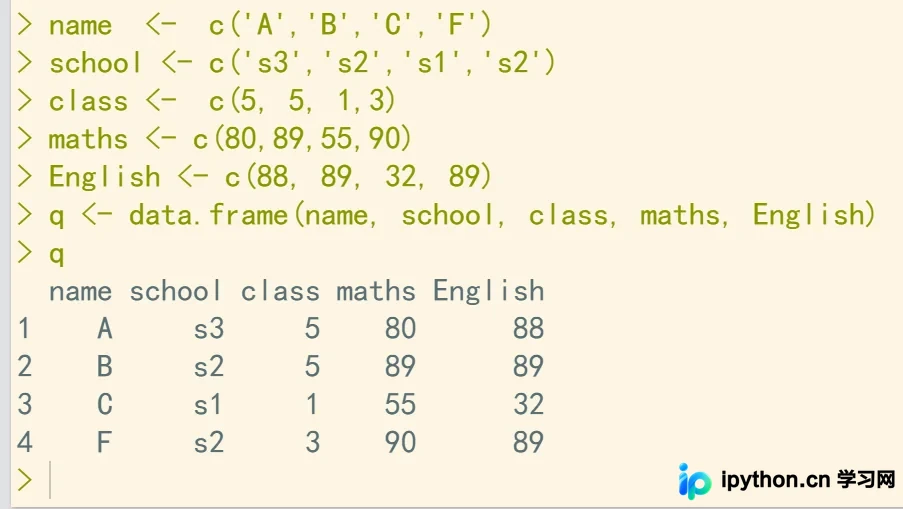
为了直观展示合并效果,首先创建两个包含学生信息的数据框。数据框 w 包含姓名、班级、年级和英语成绩;数据框 q 包含部分相同姓名但不同的班级信息以及数学成绩。注意:在真实的数据分析场景中,建议先检查两个数据集的结构,确保数据类型一致,特别是日期或因子类型,以免因格式不匹配导致合并失败。
name <- c('A','B','A','A','C','D')
school <- c('s1','s2','s1','s1','s1','s3')
class <- c(10, 5, 4, 11, 1, 8)
English <- c(85, 50, 90 ,90, 12, 96)
w <- data.frame(name, school, class, English)
w
name  <-  c('A','B','C','F')
school <- c('s3','s2','s1','s2')
class <-  c(5, 5, 1,3)
maths <- c(80,89,55,90)
English <- c(88, 89, 32, 89)
q <- data.frame(name, school, class, maths, English)
q
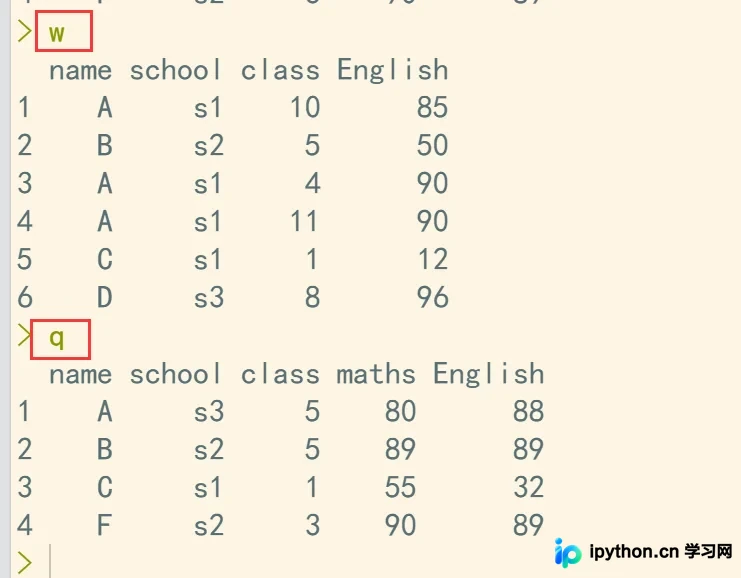
查看当前两个数据框的基础内容:
w
q
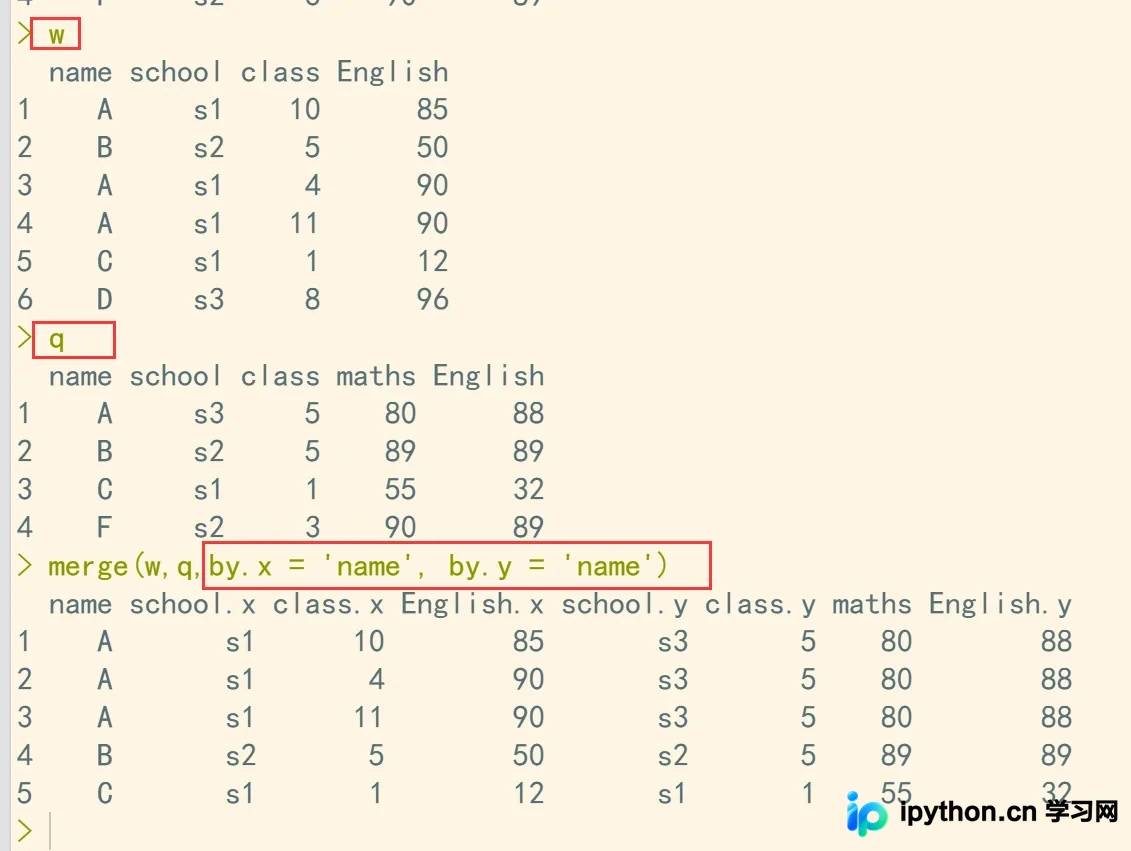
第1步:按相同列名进行默认合并(内连接)
目的:仅返回两个数据框中都存在的公共记录。这是merge函数的基础行为,默认取交集。
操作:如果两列名称完全相同(例如都是name),可以直接使用merge(w, q),或者显式指定by = 'name'。
merge(w,q,by.x = 'name', by.y = 'name')
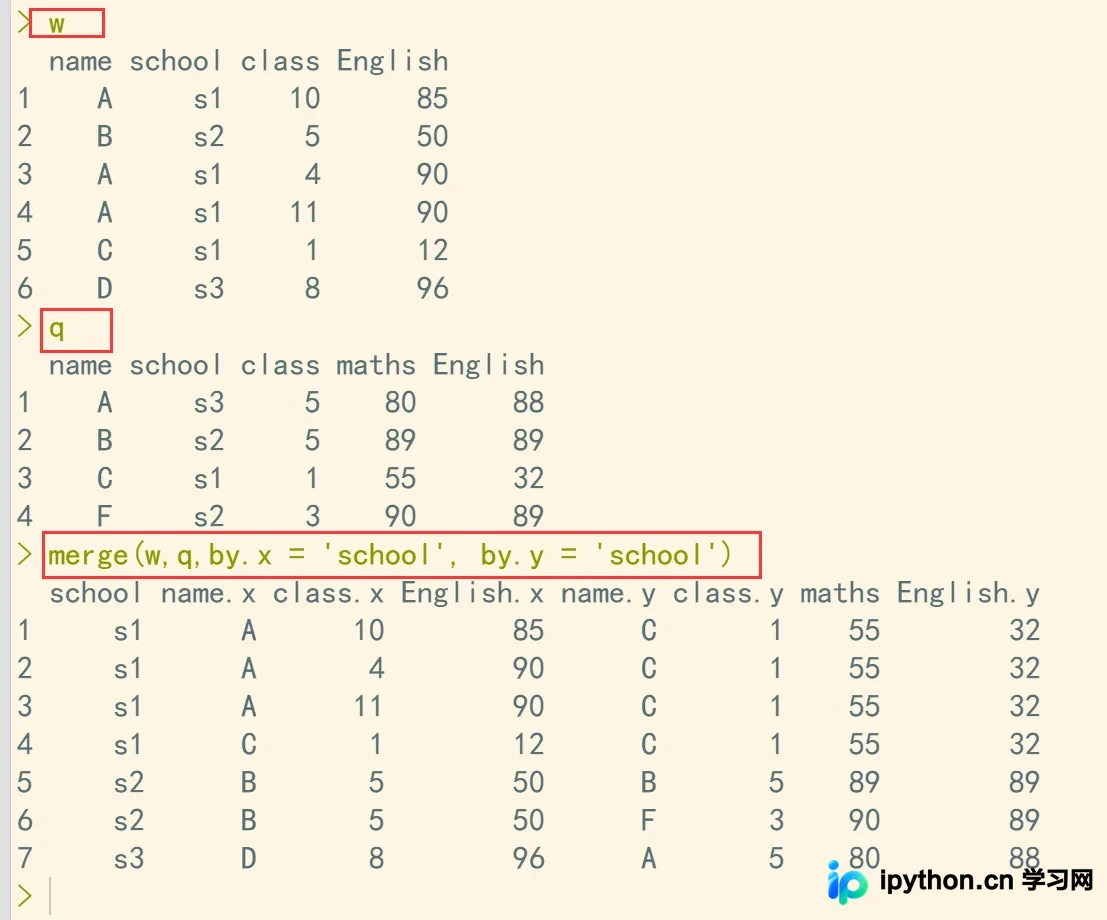
也可以通过其他共同的列(如school)来执行相同的逻辑:
w
q
merge(w,q,by.x = 'school', by.y = 'school')
第2步:使用 all=TRUE 实现全外连接
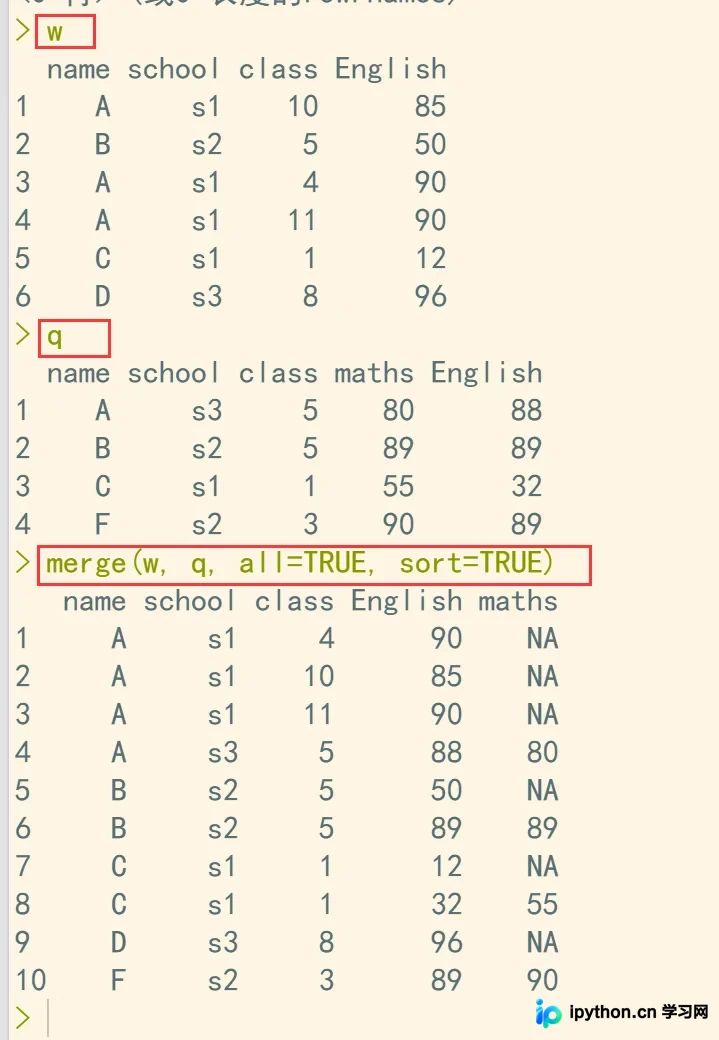
目的:保留两个数据框中的所有行。如果某一行在另一个数据框中没有匹配的键值,系统会自动将对应的字段填充为 NA(缺失值)。
操作:设置参数all = TRUE并启用排序以便观察结果。
w
q
merge(w, q, all=TRUE, sort=TRUE)
第3步:使用 all.x=TRUE 实现左连接
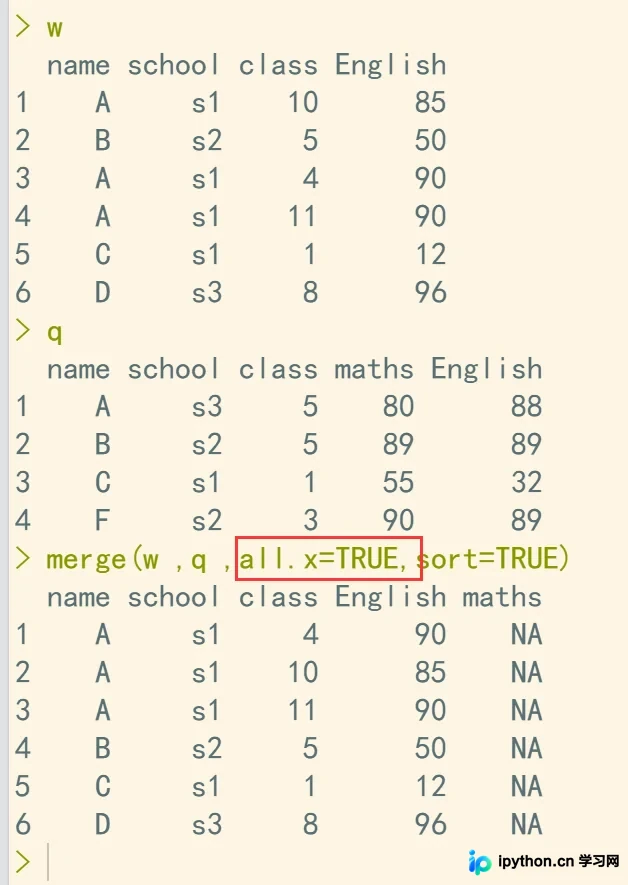
目的:以左侧数据框 w 为准,保留其所有记录。右侧数据框 q 中未能匹配的记录将被丢弃,而 w 中有但 q 中没有的数据则填充 NA。
入口:在函数调用中加入 all.x = TRUE。
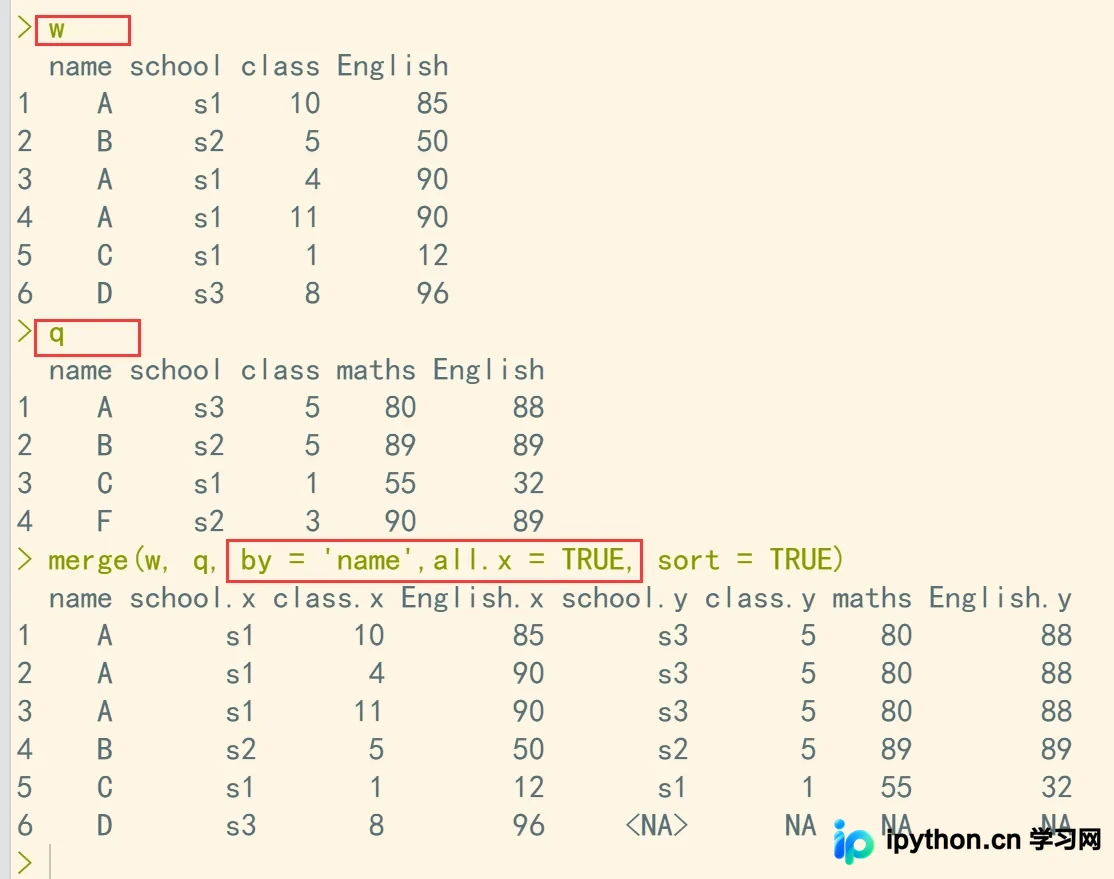
重要参数:by = 'name' 确保按指定的主键进行匹配,而不是默认的所有同名列。
w
q
merge(w ,q ,all.x=TRUE,sort=TRUE)
显式指定匹配列后的完整写法:
w
q
merge(w, q, by = 'name',all.x = TRUE, sort = TRUE)
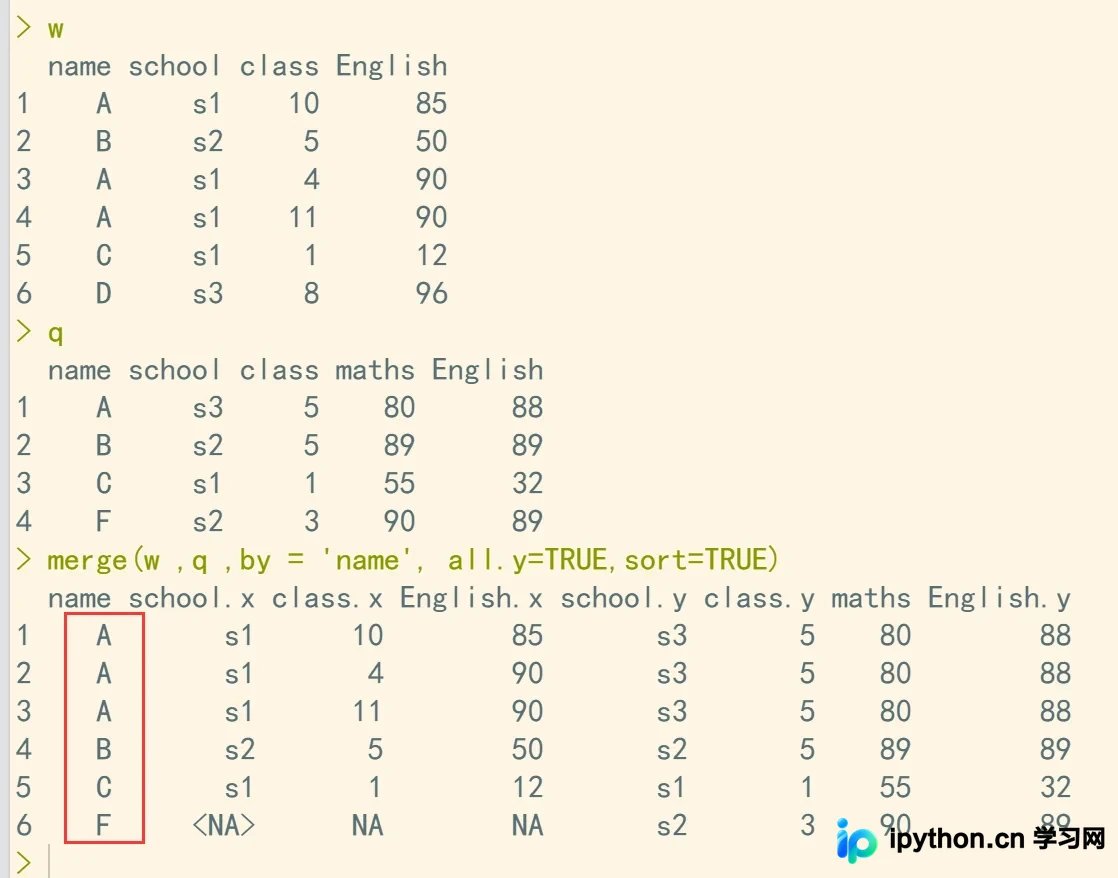
第4步:使用 all.y=TRUE 实现右连接
目的:以右侧数据框 q 为准,保留其所有记录。左侧数据框 w 中未能匹配的记录将被丢弃。
操作:设置参数all.y = TRUE。
w
q
merge(w ,q ,by = 'name', all.y=TRUE,sort=TRUE)
完成判断与注意事项
通过以上步骤,已经掌握了 merge 函数的四种主要连接模式:内连接(默认)、全连接(all=TRUE)、左连接(all.x=TRUE)和右连接(all.y=TRUE)。在实际操作中,如果遇到合并后行数异常减少的情况,通常是因为使用了默认的“内连接”策略,此时请考虑是否需要调整为左连接或全连接。此外,合并前的数据清洗(如去除首尾空格、统一大小写)对于保证匹配成功率至关重要。
以上就是R语言merge函数在数据框合并中的详细内容,更多关于R数据分析技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









