

Python对比文件相似度:模糊哈希与difflib性能实测

发布时间:2026-10-12| 3人浏览过
本文通过Python实测对比文件相似度,涵盖difflib、ssdeep、mmdt及tlsh四种方法。针对大文件(如81MB)场景,模糊哈希通过预计算哈希值显著优化时间与资源消耗。测试表明,mmdt在二进制文件对比中表现更稳定,而tlsh在小文件处理上存在局限。文章提供Ubuntu环境下Python 3.8.10的完整测试代码与性能数据,为高并发或大文件比对提供选型参考。
在Python中对比两个文件的相似度,通常可以使用difflib.SequenceMatcher、ssdeep、python_mmdt或tlsh等库。当面临大量文件对比且文件体积较大时,为了追求更高的处理效率,建议采用模糊哈希(fuzzy hash)技术,例如ssdeep或python_mmdt。
在测试过程中发现以下现象:
- 使用difflib方法时,读取文件内容后即可直接输出匹配度结果。
- ssdeep、mmdt和tlsh等方法则支持预先计算文件的模糊哈希值。在后续验证阶段,只需读取一次文件即可完成对比,从而有效优化了对比耗时以及内存和CPU的资源消耗。
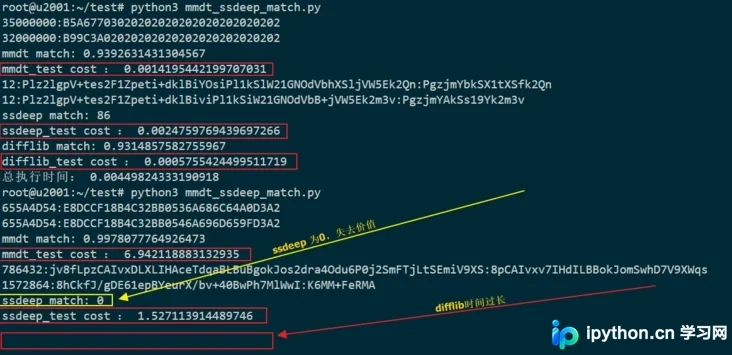
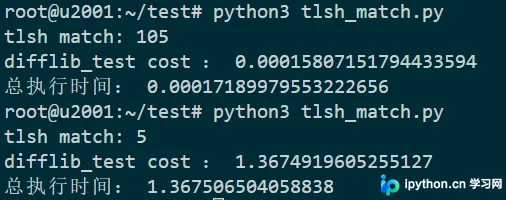
- 在tlsh的测试中发现,其返回值越小代表相似度越高;然而,在处理小文件时,该方法的对比效果并不理想。
- 当对比小文件时,上述三种模糊哈希方法的差异不大;但在对比大文件(如案例中的81MB文件)时,difflib方法的执行速度慢到难以接受。
- 在实际生产环境中,建议优先使用mmdt方法。因为ssdeep在二进制文件对比中往往存在较大差异,导致结果失去参考价值。至于具体还有哪些其他文件类型存在此类问题,仍有待进一步考量。
测试环境配置如下:
操作系统:ubuntu20.04
Python版本:3.8.10
py-tlsh版本:4.7.2
python-mmdt版本:0.3.1
ssdeep版本:3.4
# -*- coding: utf-8 -*-

import ssdeep
import time
from python_mmdt.mmdt.mmdt import MMDT
from difflib import SequenceMatcher

def difflib_test(file1,file2):
    start_time = time.time()
    with open(file1,'rb') as f:
        s1 = f.read()
    with open(file2,'rb') as f:
        s2 = f.read()
    match_obj =  SequenceMatcher(None,s1,s2)
    print("difflib match:",match_obj.ratio())
    end_time = time.time()
    print('difflib_test cost :',end_time-start_time)

def mmdt_test(file1,file2):
    start_time = time.time()
    mmdt=MMDT()
    r1 = mmdt.mmdt_hash(file1)
    print(r1)
    r2 = mmdt.mmdt_hash_streaming(file2)
    print(r2)
    # sim1 = mmdt.mmdt_compare(file1, file2)
    # print("mmdt match:",sim1)
    sim2 = mmdt.mmdt_compare_hash(r1, r2)
    print("mmdt match:",sim2)
    end_time = time.time()
    print('mmdt_test cost :',end_time-start_time)

def ssdeep_test(file1,file2):
    start_time = time.time()
    sig1=ssdeep.hash_from_file(file1)
    sig2=ssdeep.hash_from_file(file2)
    print(sig1)
    print(sig2)
    print("ssdeep match:",ssdeep.compare(sig1,sig2))
    end_time = time.time()
    print('ssdeep_test cost :',end_time-start_time)

if __name__ == '__main__':
    start_time = time.time()
    file1='/root/test/fstab'
    file2='/root/test/fstab2'
    # file1 = '/root/test/initrd.img-5.4.0-125-generic'
    # file2 = '/root/test/initrd.img-5.4.0-135-generic'
    mmdt_test(file1,file2)
    ssdeep_test(file1,file2)
    difflib_test(file1,file2)
    end_time = time.time()
    print('总执行时间:',end_time-start_time)
接下来展示对比小文件与大文件的具体效果:
tlsh测试代码示例
import tlsh
import time

def tlsh_test(file1,file2):
    start_time = time.time()
    with open(file1,'rb') as f:
        s1 = tlsh.hash(f.read())
    with open(file2,'rb') as f:
        s2 = tlsh.hash(f.read())
    match_obj =  tlsh.diff(s1,s2)
    print("tlsh match:",match_obj)
    end_time = time.time()
    print('difflib_test cost :',end_time-start_time)


if __name__ == '__main__':
    start_time = time.time()
    # file1='/root/test/fstab'
    # file2='/root/test/fstab2'
    file1 = '/root/test/initrd.img-5.4.0-125-generic'
    file2 = '/root/test/initrd.img-5.4.0-135-generic'
    tlsh_test(file1,file2)
    end_time = time.time()
    print('总执行时间:',end_time-start_time)
小文件与大文件的对比结果
至此,关于Python利用模糊哈希实现文件相似度对比的介绍已结束。如需了解更多Python对比文件相似度的相关内容,欢迎搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









