

Python层次聚类详解:从原理到代码实现

本文深入解析Python中的层次聚类算法,涵盖最短距离、Ward法等核心原理。通过Mall Customers数据集演示完整流程:数据预处理、利用树状图确定最佳聚类数(如5类),并使用scikit-learn实现模型训练与可视化,最后探讨其时间空间复杂度局限。
前言
层次聚类是一种广泛应用的无监督学习算法。其核心目标在于识别数据集中具有相似属性的元素,并将它们归并到同一个簇中。最终,算法会生成一个单一的宏观簇,该簇由原始数据点或其他子簇层层聚合而成。
一、聚类流程与基本原理
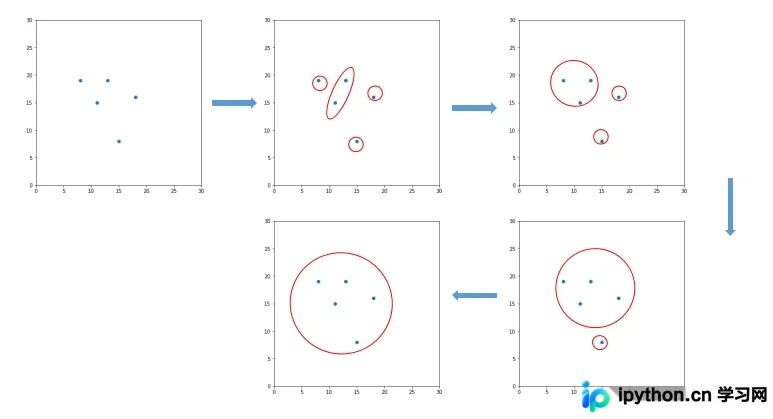
系统聚类法(hierarchical clustering method),亦称分层聚类法,是当前最为常用的聚类分析手段之一。其基本操作流程如下:假设样本集中包含n个样品,初始时将这n个样品各自视为一个独立的类(即每个样品自成一类)。随后,找出性质最接近的两个类进行合并,形成一个新的类,此时类的数量变为n-1。接着,在剩余的类中再次寻找最接近的两个类进行合并,使类的数量变为n-2。重复此合并过程,直至所有样品最终归并为一个大类。将这一合并过程绘制成的图形称为聚类图(或树状图),通过观察该图可以决定最终的分类数量。具体示意如下:
样点之间的相似度主要通过距离来衡量,常见的计算方法包括最短距离法、最长距离法、重心法、类平均法以及Ward法(离差平方和法)。
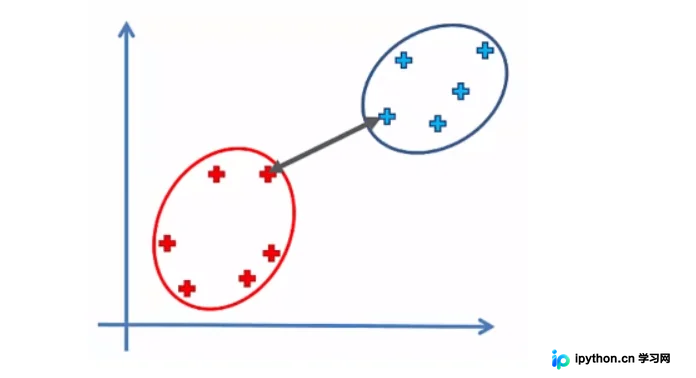
最短距离法:该方法从两个类中选取距离最短的两个样品点作为类间距离。具体示意如下:
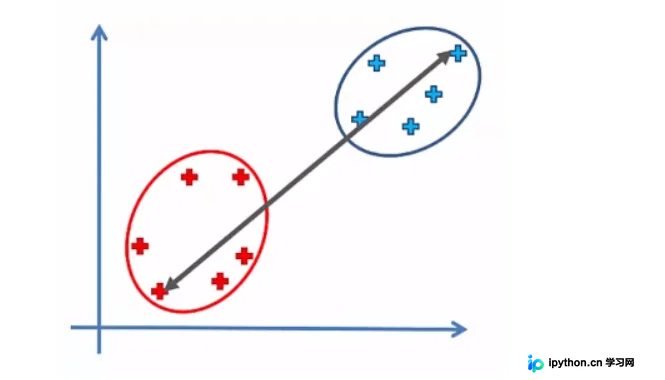
最长距离法:原理同上,具体示意如下:
类平均法:计算两个类之间所有点对距离的平均值作为类间距离。
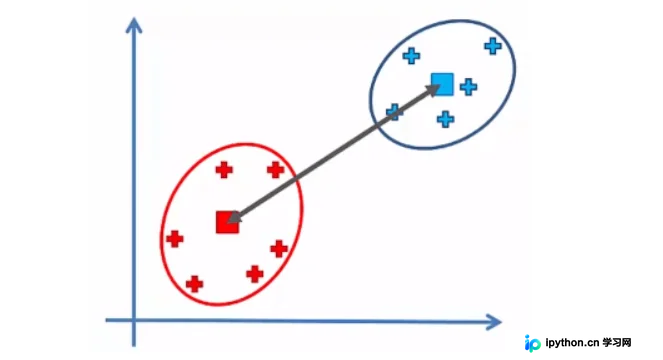
重心法:顾名思义,基于类的重心(均值向量)之间的距离进行计算,具体示意如下:
离差平方和法(Ward法):该方法旨在最小化聚合过程中的偏差。具体而言,若将两个簇合并为一个新簇,需估计新簇的质心,并计算新质心下所有点的平方偏差之和。对于不同的合并方案,这一偏差值会有所不同。因此,算法选择使合并后距离(偏差)最小的方案进行合并。
二、实现层次聚类
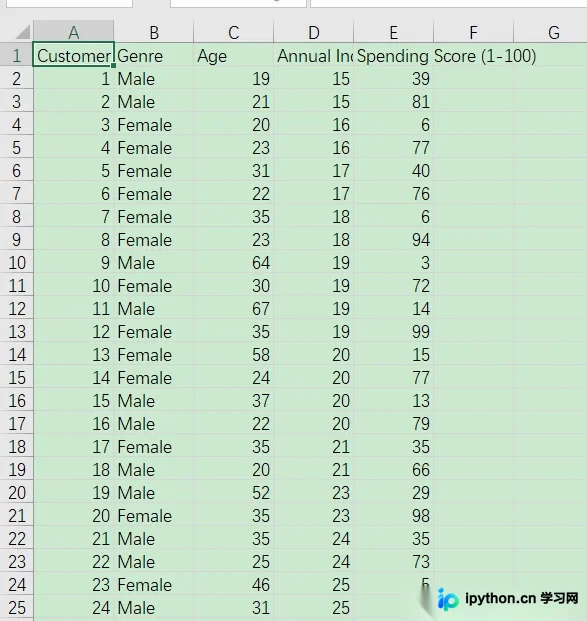
数据下载:点击这里下载
具体数据示例如下:
2.1 导入相关库
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
2.2 读取数据
ourData = pd.read_csv('Mall_Customers.csv')
ourData.head()
具体代码实现如下:
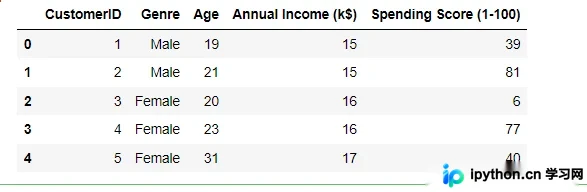
我们将利用该数据集,在“Annual Income (k$)”(年收入)和“Spending Score (1-100)”(消费得分)这两列特征上实现层次聚类模型。因此,需要从数据集中提取这两个关键特征:
newData = ourData.iloc[:, [3, 4]].values
newData
具体代码实现如下:
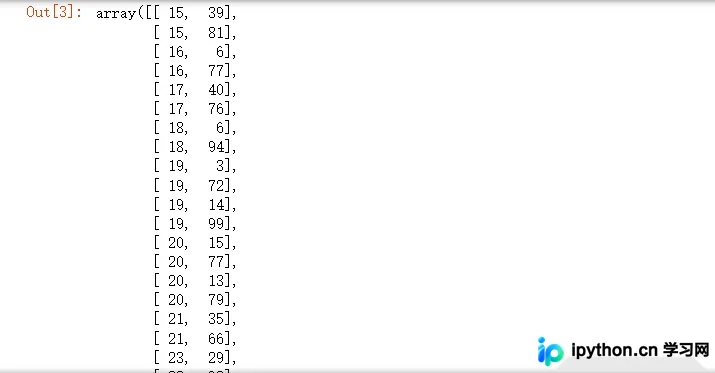
从输出结果可见,数据存在量纲不一致的问题。我们必须对数据进行缩放处理,以确保各特征具有可比性;否则,最终得到的模型质量将较差。原因在于,层次聚类(如同机器学习中的许多其他算法)是基于距离计算的(通常使用欧几里得距离)。
2.3 确定最佳集群数
在对数据进行聚类之前,我们需要预先确定数据最适合被划分为多少个簇。为此,我们首先基于数据集构建一个树状图(Dendrogram)来确定最佳聚类数:
import scipy.cluster.hierarchy as sch # 导入层次聚类算法
dendrogram = sch.dendrogram(sch.linkage(newData , method = 'ward')) # 使用树状图找到最佳聚类数
plt.title('Dendrogram') # 标题
plt.xlabel('Customers') # 横标签
plt.ylabel('Euclidean distances') # 纵标签
plt.show()
生成的树状图如下所示:
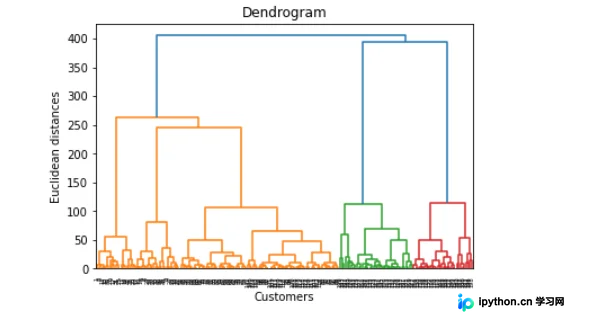
通过观察上述树状图,可以确定最佳聚类数。具体方法是:在图中假设绘制多条水平线,然后找到不与这些假设线相交的最长垂直线。
在这条最长垂直线处建立一条分界线。能够被最佳聚类的簇数,等于该分界线所跨越的欧几里得距离(即垂直线段)的数量。
在刚刚生成的树状图中,不与延伸水平线相交的最长垂直线位于绿色区域。第三条水平线对应的欧几里得距离范围在110至250之间。我们将阈值设定为150,从而得出最佳聚类数为5。明确了数据应聚集的最佳数量后,我们现在可以训练聚类模型以实现这一目标。
2.4 层次聚类模型训练
from sklearn.cluster import AgglomerativeClustering
# n_clusters为集群数,affinity指定用于计算距离的度量,linkage参数中的ward为离差平方和法
Agg_hc = AgglomerativeClustering(n_clusters = 5, affinity = 'euclidean', linkage = 'ward')
y_hc = Agg_hc.fit_predict(newData) # 训练数据
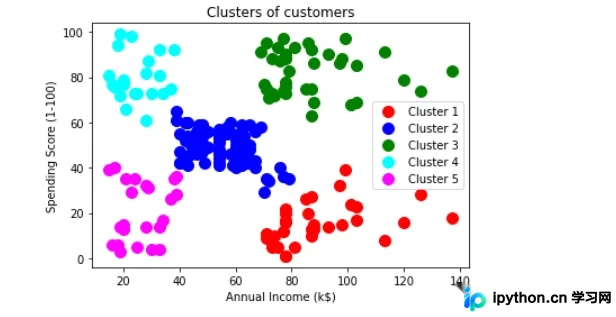
上述代码完成了模型的训练,接下来我们可以继续可视化数据的聚类结果:
plt.scatter(newData[y_hc == 0, 0], newData[y_hc == 0, 1], s = 100, c = 'red', label = 'Cluster 1') # cluster 1
plt.scatter(newData[y_hc == 1, 0], newData[y_hc == 1, 1], s = 100, c = 'blue', label = 'Cluster 2') # cluster 2
plt.scatter(newData[y_hc == 2, 0], newData[y_hc == 2, 1], s = 100, c = 'green', label = 'Cluster 3') # cluster 3
plt.scatter(newData[y_hc == 3, 0], newData[y_hc == 3, 1], s = 100, c = 'cyan', label = 'Cluster 4')  #  cluster 4
plt.scatter(newData[y_hc == 4, 0], newData[y_hc == 4, 1], s = 100, c = 'magenta', label = 'Cluster 5') #  cluster 5

plt.title('Clusters of customers')
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score (1-100)')
plt.legend()
plt.show()
具体可视化结果如下:
关于层次聚类,我们需要了解的最后一个关键细节是:其时间和空间复杂度相对较高,因此它并非解决大规模数据集聚类问题的理想方案。
三、总结
至此,关于Python中层次聚类的介绍便告一段落。如需了解更多Python层次聚类相关内容,请搜索本站历史文章或继续浏览后续相关文章。希望大家今后能多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









