

C语言互斥锁、自旋锁与原子操作对比及实现

发布时间:2026-10-15| 4人浏览过
在多线程开发中,正确管理临界区资源至关重要。互斥锁通过阻塞换时间,自旋锁通过占用CPU忙碌等待,而原子操作则在硬件层面保障不可分割性。本文将剖析这三者的底层逻辑,并通过实际代码对比它们在简单累加与复杂计算场景下的性能表现,为高性能并行程序设计提供参考。
核心概念与应用场景
线程同步机制的选择主要取决于“持有锁的时间”与“线程切换代价”之间的权衡:
- 互斥锁 (Mutex):当另一个线程正在占用临界资源时,后续线程会被操作系统挂起(进入睡眠状态)。如果临界区的代码执行较长,线程上下文切换的开销通常小于线程等待的时间成本。它非常适合保护包含大量业务逻辑(如数据库写入、复杂算法计算)的临界区。
- 自旋锁 (Spinlock):请求资源的线程不会放弃CPU控制权,而是原地循环检查(While循环),直到获取到锁为止。若临界区极短(例如几个简单的寄存器赋值指令),且高并发下频繁触发调度会导致巨大的性能损耗,此时自旋锁更优。
- 原子操作 (Atomic Operations):由CPU指令直接保证操作的不可分割性,无需构建复杂的锁结构。它是轻量级竞争场景(如计数器增减)的最佳实践。
代码实操与性能测试
为了验证不同锁机制的效果,我们需要解决两个层面的问题:首先是确保多线程数据一致性(逻辑正确性),其次是评估各自的时间开销(性能)。以下以10个线程并发修改全局变量为例进行演示。
第1步:基础线程安全验证代码
该段代码展示了如何在同一份结构中切换三种模式,通过宏开关控制使用互斥锁、自旋锁或自定义的原子加法函数。初始计数器清零后启动指定数量的线程,各线程独立执行增量循环。
#include#include #include #define PTHREAD_NUM 10 #define INFO printf pthread_mutex_t mutex; pthread_spinlock_t spin; // x86架构原子加法汇编实现示例 int inc(int *v,int add) { int old; __asm__ volatile( "lock;xaddl %2, %1;" :"=a" (old) :"m"(*v),"a"(add) :"cc","memory" ); return old; } void * thread_callback(void *arg) { int *count = (int *)arg; int i = 100000; while(i--) { #if 0 // 1. 互斥锁方式 pthread_mutex_lock(&mutex); (*count)++; pthread_mutex_unlock(&mutex); #elif 0 // 2. 自旋锁方式 pthread_spin_lock(&spin); (*count)++; pthread_spin_unlock(&spin); #else // 3. 原子操作方式 inc(count,1); #endif usleep(1); // 模拟轻微处理延迟 } } int main() { pthread_t thread[PTHREAD_NUM] = {0}; pthread_mutex_init(&mutex,NULL); pthread_spin_init(&spin,0); int count = 0; // 创建线程组 for(int i = 0;i
第2步:标准化性能基准测试代码
上述逻辑已证明三种方式均能保证数据一致,但我们要量化其效率。下面的测试脚本将循环次数扩大至一亿次,分别测量 Mutex、Spinlock 以及 Atomic 的耗时差异。为了消除极端影响,测试使用了时钟周期作为计时单位。
#include#include #include #include #define MAX_PTHREAD 2 // 测试并发度可调整 #define LOOP_LEN 100000000 #define LOOP_ADD 10000 int count = 0; pthread_mutex_t mutex; pthread_spinlock_t spin; typedef void *(*functhread)(void *arg); // 模拟非纯计算任务 void do_add(int num){ int sum = 0; for(int i = 0;i
第3步:测试结果分析
经过多轮自动化压力测试,我们得到直观的耗时对比图:
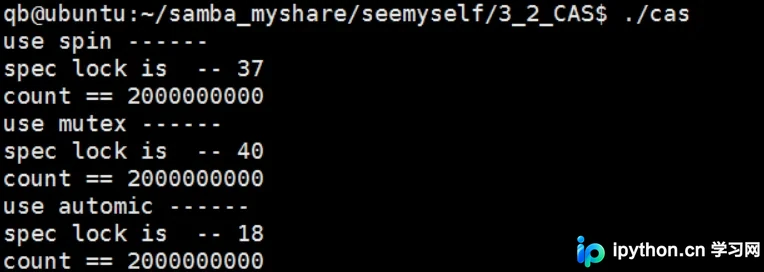
从测试结果图表可以看出:
- 数据一致性方面:三种手段均成功将最终数据累加至预期值,未出现脏读或丢失更新情况。
- 性能耗时方面:
- 在该基准测试用例中,由于每次增量的操作极为单一,自旋锁忙等带来的CPU空转消耗被掩盖,使得 Mutex 与 Spinlock 的总耗时差距不大。
- 原子操作优势显著:相比于需要进入内核态切换或原地死循环检测的锁机制,基于CPU硬件指令集的原子加法不仅没有上下文切换开销,也规避了自旋造成的总线锁定,因此在高频短任务场景下速度最快。
结论总结
综上所述,在进行系统级并发设计时:
- 涉及磁盘I/O、网络通信等长时间阻塞的操作,请务必使用互斥锁。
- 处于极小代码块且对延迟极度敏感的环境下,考虑自旋锁或原子操作。
- 对于通用的整数增减、标志位切换,优先选择标准库提供的原子接口(如 GCC `__sync_val_compare_and_swap` 或 C11 `
以上就是C语言中互斥锁、自旋锁与原子操作对比及实现的详细内容,更多关于C语言并发编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









