

MySQL复合查询与内外连接实战详解

在MySQL开发中,数据往往分散在多张表中,如何高效获取组合信息是核心难点。本文系统讲解复合查询的三大支柱:多表连接基础、复杂子查询模式以及结果集合并;同时剖析内、左外、右外连接在数据对齐与空值处理上的差异,提供可直接运行的SQL示例。
一、复合查询:多表协作与嵌套逻辑
第1步:掌握多表查询与字段限定
当数据源来自不同表时,需执行多表查询。SQL引擎会先对参与表做笛卡尔积运算,再根据条件筛选有效行。为避免多表存在同名字段时的歧义,务必使用表名.字段名的格式进行引用。
以下示例展示了如何从 emp 和 dept 表中,通过部门编号关联查询员工姓名、工资及部门名称:
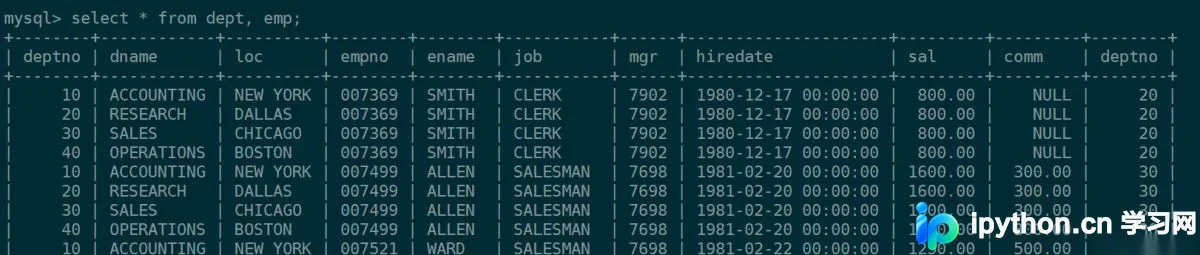
mysql> select dept.dname, emp.ename, emp.sal
from emp, dept
where dept.deptno = emp.deptno;
运行后可见返回了多个部门的详细人员薪资结构,验证了多表关联的有效性。
第2步:应用自连接处理层级关系
当需要查询同一张表内具有父子或上下级关系的数据(如查某员工的直接领导)时,可将对同一张表的多次引用视为不同的“虚拟表”,这称为自连接。此时必须为表指定别名。
场景:查询员工FORD的直接上级编号和姓名。
方法一:使用子查询定位领导ID。
mysql> select empno, ename from emp
where empno = (select mgr from emp where ename = 'FORD');
方法二:使用自连接。将主表别名为 worker,副表别名为 leader,通过 worker.mgr = leader.empno 建立关联:
mysql> select leader.empno, leader.ename
from emp as worker, emp leader
where worker.mgr = leader.empno and worker.ename='FORD';
两种写法均可正确锁定JONES作为FORD的领导。
第3步:灵活运用各类子查询
子查询是指嵌入在主 SELECT 语句中的 SELECT 语句,可根据返回行数分为以下几类:
1.3.1 单行子查询
用于返回单一值的比较场景。例如查找与SMITH同部门的所有同事:
mysql> select deptno, ename from emp
where deptno = (select deptno from emp where ename = 'SMITH');
1.3.2 多行子查询(IN / ALL / ANY)
In 关键字:判断主查询值是否在子查询结果的集合中。查询与10号部门相同岗位的员工(排除10号部门自身):
mysql> select ename, job, sal, deptno from emp
where job in (select distinct job from emp where deptno = 10)
and deptno <> 10;
All 关键字:与子查询返回的所有值比较都成立才返回。找出比30部门所有员工工资都高的员工:
mysql> select ename, sal, deptno from emp
where sal > all(select sal from emp where deptno = 30);
Any 关键字:只要大于子查询中的任意一个值即可。效果常等同于大于最小值:
mysql> select ename, sal, deptno from emp
where sal > any (select sal from emp where deptno=30);
1.3.3 多列子查询
当需要同时匹配多个维度(如部门+岗位完全一致)时,可在 WHERE 后跟元组形式的子查询。注意排除本人记录:
mysql> select ename, deptno, job from emp
where (job, deptno) = (select job, deptno from emp where ename = 'SMITH')
and ename <> 'SMITH';
1.3.4 From 子句中的子查询
可将子查询的结果集当作一张临时表进行多表联结。此法常用于处理聚合统计(如求部门平均薪):
-- 计算各部门高于平均工资的人员名单
mysql> select emp.ename, emp.deptno, emp.sal, format(dept_avg,2)
from emp , (select deptno , avg(sal) dept_avg from emp group by deptno) tmp
where tmp.deptno = emp.deptno and emp.sal > dept_avg;
若涉及跨表聚合(如含部门信息的统计),需注意SQL_MODE下的分组限制,将所有非聚合列加入 GROUP BY 或使用上述临时表技巧。
第4步:使用集合操作符合并结果集
将两个 SELECT 结果拼接,可使用 UNION 系列指令:
- Union:取并集且自动去重。适合查询工资超2500或职位为MANAGER且不希望出现重复记录的场景。
- Union All:取并集但保留所有重复项。若需要查看全量原始命中情况则选此项。
-- Union 自动过滤重复的Jones/BBlake等记录
select ename, sal, job from emp where sal>2500 union
select ename, sal, job from emp where job='MANAGER';
二、内外连接:明确数据对齐规则
第5步:使用标准的内连接(Inner Join)
传统逗号分隔的多表方式本质上就是内连接。现代SQL推荐使用显式 INNER JOIN ... ON ... 语法,可读性更强。连接条件是两张表共同匹配的行才会被保留:
-- 标准内连接写法
select ename, dname
from emp inner join dept
on emp.deptno=dept.deptno
and ename='SMITH';
第6步:实施外连接处理缺失匹配项
当一张表中的数据在另一张表中找不到对应项时,内连接会将该行直接丢弃。若要保留主表全部信息,需使用外连接:
6.1 左外连接(Left Outer Join)
原则:以左表为基准,即使右侧没有匹配数据,左表记录也完整显示,右侧填 NULL。
测试案例:学生表(stu)有4人,考试成绩表(exam)仅2人有分数。
-- stu为左表,kity和nono的成绩将被补Null
select * from stu left join exam on exam.id = stu.id;
反之,若以考试表为主左表,无成绩的考生将消失,只保留有考试的学生的对应记录。
6.2 右外连接(Right Outer Join)
原则:对称于左连接,以右表为基准,左表若无匹配项填 NULL。
select * from exam right join stu on exam.id = stu.id;第7步:外连接的实际业务应用
典型需求:“列出所有部门及其员工,没人的部门也要显示”。此时必须以部门表为基数表:
mysql> select dept.deptno, dept.dname, emp.ename, emp.job
from dept left join emp
on emp.deptno = dept.deptno;
由于 dept 表包含一个 40 号部门(OPERATIONS)但在 emp 表中无相关记录,该行的 ename 和 job 会自动填充为 NULL,成功实现了全覆盖统计。
以上就是MySQL复合查询和内外连接的详细内容,更多关于MySQL高级查询技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









