

MySQL事务隔离级别与Spring配置及性能优化实战

了解MySQL事务隔离级别(未提交读、已提交读、可重复读、序列化读)的原理与差异是优化数据库并发性能的关键。本文结合Spring事务配置实战,分析readonly参数对隔离级别的自动提升作用,并通过实验验证调整隔离级别对特定业务场景的性能影响。
结果或目标:明确问题与分析方向
在处理MySQL数据库时,若未进行特殊配置,事务通常处于 autocommit 模式,即每次操作执行完毕后自动提交。然而,在复杂的业务逻辑中往往需要将多个数据库操作绑定在一个事务中,这就涉及到了事务的传播行为与隔离级别的选择。本文将解决以下核心问题:
- 如何正确理解MySQL的四种事务隔离级别及其产生的并发问题(脏读、不可重复读、幻读)。
- 如何在Spring框架中高效配置声明式事务,避免常见的配置失效陷阱。
- 调整数据库隔离级别对系统性能有何具体影响,以及如何权衡一致性与性能。
准备条件:Spring事务配置基础
Spring提供了灵活的事务策略配置方式,通常基于URL匹配或方法名匹配来定义传播行为。以下是常用的XML配置示例:
<property name="transactionAttributes">
  <props>
    <prop key="save*">PROPAGATION_REQUIRED</prop>
    <prop key="update*">PROPAGATION_REQUIRED</prop>
    <prop key="delete*">PROPAGATION_REQUIRED</prop>
    <prop key="get*">PROPAGATION_REQUIRED,readOnly</prop>
    <prop key="find*">PROPAGATION_REQUIRED,readOnly</prop>
  </props>
</property>
关键注意事项:
- 命名规范约束:上述配置依赖于方法名前缀(如
save*,get*)。只有符合命名规则的方法才会应用对应的事务策略。例如,若Service层方法名为taskSave(),它无法匹配save*,导致事务配置失效。建议在实现类调用时确保方法名符合规则,或使用更通用的*=PROPAGATION_REQUIRED,readOnly进行全量覆盖测试(生产环境需谨慎)。 readOnly参数的隐藏特性:当为查询方法设置readOnly属性时,Spring不仅标记事务为只读,还可能触发数据库层面的优化。在某些驱动和配置下,它会促使连接使用更高的隔离级别(如从 READ COMMITTED 提升至 REPEATABLE READ),以保证多次读取的一致性,避免中间被其他事务修改。
真实操作顺序:深入理解隔离级别与锁的关系
第1步:掌握四种标准隔离级别
MySQL默认隔离级别为 REPEATABLE_READ(可重复读),而Oracle等主流数据库默认为 READ_COMMITTED(已提交读)。各级别特性如下:
- ISOLATION_READ_UNCOMMITTED(未提交读):最低级别,允许读取未提交的数据。会产生脏读,极少在生产环境使用。
- ISOLATION_READ_COMMITTED(已提交读):保证只能读取已提交的数据。避免了脏读,但可能出现不可重复读(同一事务中两次读取结果不一致)。
- ISOLATION_REPEATABLE_READ(可重复读):MySQL默认级别。防止了脏读和不可重复读。InnoDB引擎通过MVCC(多版本并发控制)和间隙锁(Gap Lock)在一定程度上也解决了幻读问题,但在某些特定场景(如锁定范围扫描)仍可能遇到。
- ISOLATION_SERIALIZABLE(串行化):最高级别,强制事务串行执行。彻底解决所有并发问题,但性能代价极高,几乎不用于通用Web应用。
第2步:理解共享锁与排他锁的作用机制
隔离级别的实现底层依赖于锁机制:
- 共享锁(S锁):由读操作添加。持有共享锁的会话可以读取,其他会话也可以获取共享锁但不能获取排他锁。简单说,即“可并行读”。
- 排他锁(X锁):由写操作添加。持有排他锁的会话独占资源,其他任何锁都无法获取。即“写完才能读/写”。
注意:MySQL InnoDB默认的REPEATABLE_READ主要依靠MVCC实现非阻塞读,而非严格的行级共享锁,这有助于提升并发性能。
第3步:调整隔离级别进行性能调优
在实际项目中,如果业务逻辑不涉及同一事务内对同一数据集的多次复杂校验,可以考虑降低隔离级别以提升吞吐量。
实验场景设定:
- 环境:本地MySQL数据库。
- 变量:对比
REPEATABLE_READ与READ_COMMITTED两种隔离级别。 - 流程:用户A在一个事务中进行两次相同条件的查询;在两次查询之间,用户B修改并提交了该记录的数据。
实验结果分析:
- REPEATABLE_READ:用户A第二次查询得到的结果与第一次相同。因为InnoDB在第一次读取时已经快照化了数据,后续读取复用快照,不受用户B已提交更改的影响。
- READ_COMMITTED:用户A第二次查询得到的结果与第一次不同。因为每次读取都尝试获取最新已提交的数据快照。
// 伪代码演示:在READ_COMMITTED下,同一次事务内的二次读取可能返回不同值
BEGIN TRANSACTION; SELECT * FROM users WHERE id = 1; // Result: Version A -- 此时另一事务修改了 id=1 并提交 -- SELECT * FROM users WHERE id = 1; // Result: Version B (可能与上次不同) COMMIT;
性能影响结论:
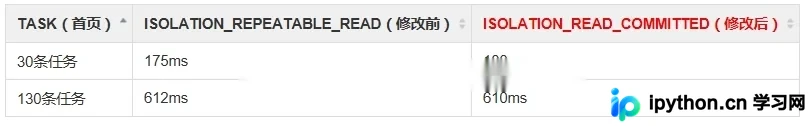
通过针对Task模块首页的高并发测试发现,将隔离级别从 REPEATABLE_READ 降至 READ_COMMITTED:
- 性能提升:在部分特定逻辑上,由于减少了维持多版本快照所需的额外内存开销和行锁竞争检测,响应速度有所提升。
- 适用范围:如果业务中不存在“事务内多次读取同一数据且期望保持一致性”的需求(如简单的列表展示、统计汇总),降低隔离级别带来的加锁时间消耗减少是可以忽略不计甚至有益的。
- 潜在风险:必须确保业务逻辑能容忍“不可重复读”。对于金融交易、库存强一致性扣减等场景,严禁随意降级至READ_COMMITTED,应保留默认的可重复读或更高。
完成判断与简要总结
判断配置是否成功的标准:
- 开启事务后,写入操作在未Commit前对其他事务不可见(取决于隔离级别)。
- 设置 readOnly=true 的查询方法,数据库连接池反馈的连接确实具有只读优化标志。
核心要点回顾:
- MySQL默认
REPEATABLE_READ兼顾了一致性与性能,是大多数场景的安全选择。 - Spring
readOnly配置不仅是元数据标记,可能在底层改变读取行为以获得更好的并发表现。 - 只有在明确知晓“不可重复读”不影响业务语义的前提下,才考虑调整为
READ_COMMITTED以换取极致的读取性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









