

R语言中set.seed()函数的作用详解

在使用R语言进行数据分析或建模时,随机性往往导致每次运行的结果不一致。本文详细讲解如何利用set.seed()函数固定随机种子,从而保证多次执行相同的随机数生成代码(如rnorm)时得到完全相同的结果,这对于实验复现和调试至关重要。
理解R语言的随机性与不可复现问题
R语言中的随机函数(如生成正态分布随机数的rnorm)实际上是基于算法生成的“伪随机数”。如果不进行任何干预,这些数字的序列在每次程序启动时都是不同的。这在进行统计模拟或机器学习时可能会导致问题:我们可能无法确认模型性能的波动是源于数据变化还是算法本身的随机抖动。
第一步:观察未设置随机种子的情况
首先,我们编写一段基础代码,生成10个服从标准正态分布(平均值0,标准差1)的随机数,并将其可视化。请注意,这段代码中没有包含任何控制随机性的参数。
x=rnorm(10)     ## 生成10个平均值为0, 标准差1的符合正太分布的随机数
x
plot(x)
运行上述代码,系统会输出一个数值向量并绘制散点图:
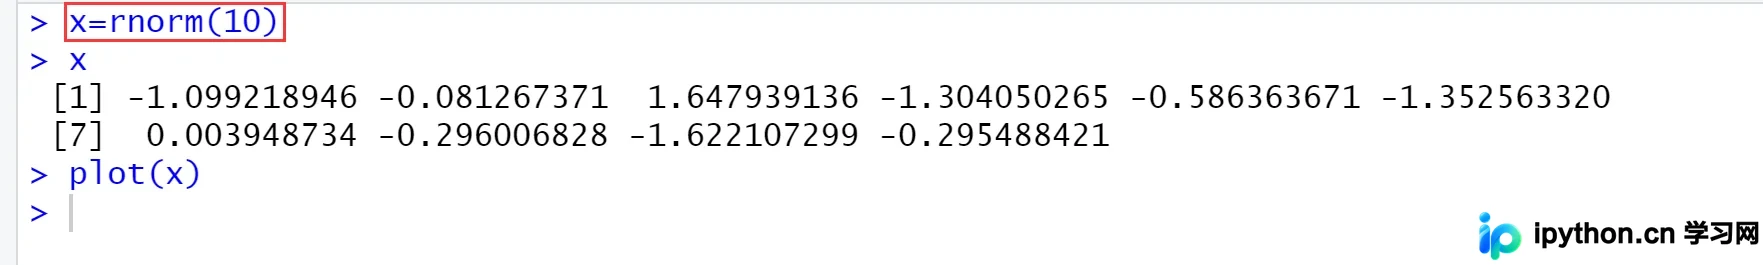
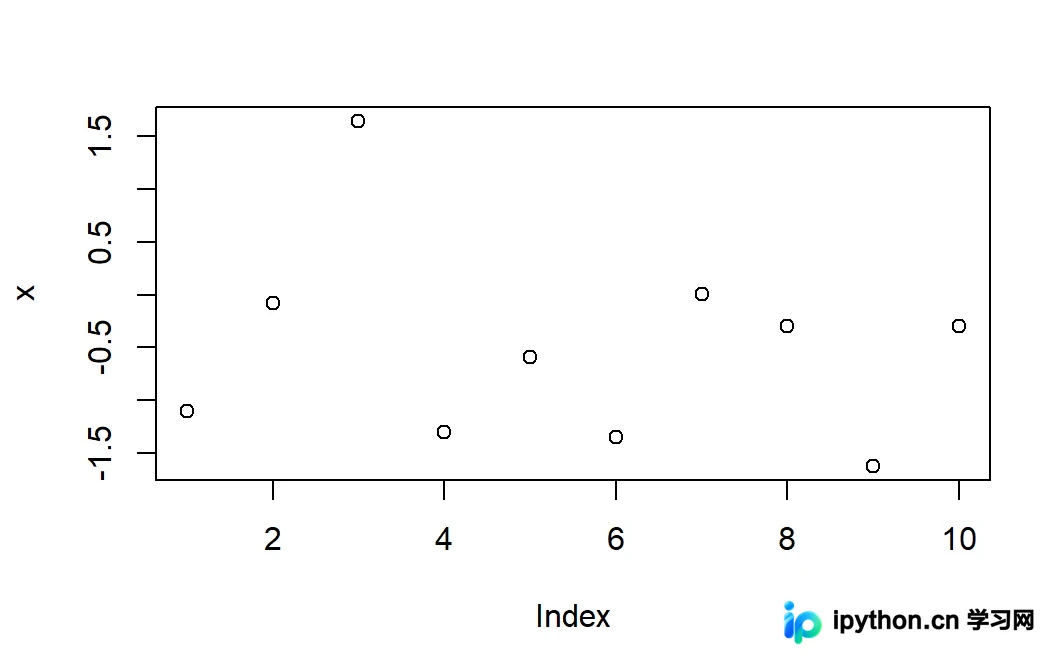
接下来,我们再次在同一个会话中运行完全相同的代码块:
x=rnorm(10)
x
plot(x)此时可以发现,输出的x值发生了改变,且绘图结果也与第一次不同:
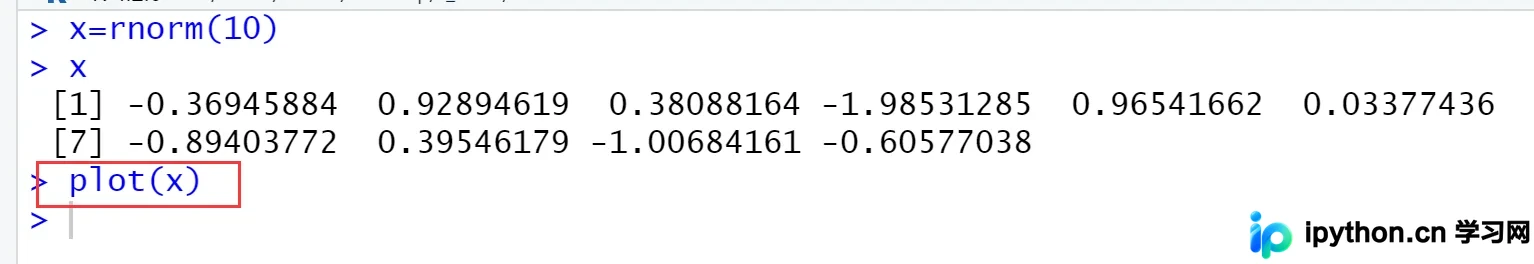
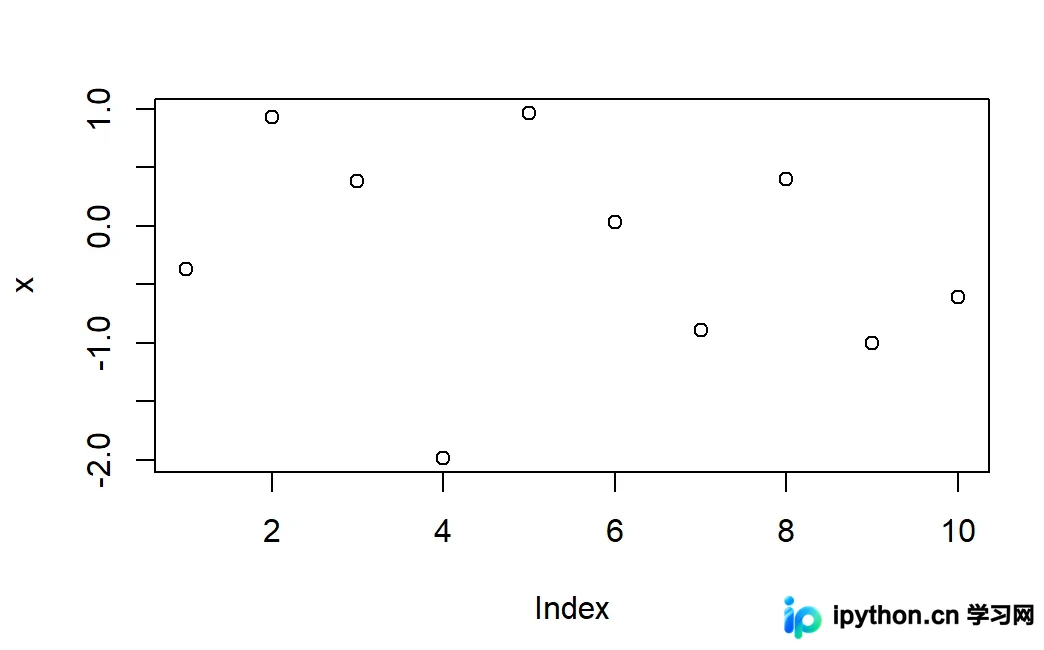
结论:在没有指定初始条件的情况下,每次运行都会产生新的随机序列,结果不具备一致性。
第二步:使用set.seed固定随机结果
为了实现结果的确定性,我们需要引入set.seed()函数。这个函数告诉R语言使用特定的“种子”来初始化随机数生成器。只要种子相同,生成的伪随机序列就必然相同。
我们在代码最前部加入set.seed(1),然后再次生成随机数:
set.seed(1)       ## 设置种子为1
x=rnorm(10)
x
plot(x)
这次运行产生的数值和图形如下:
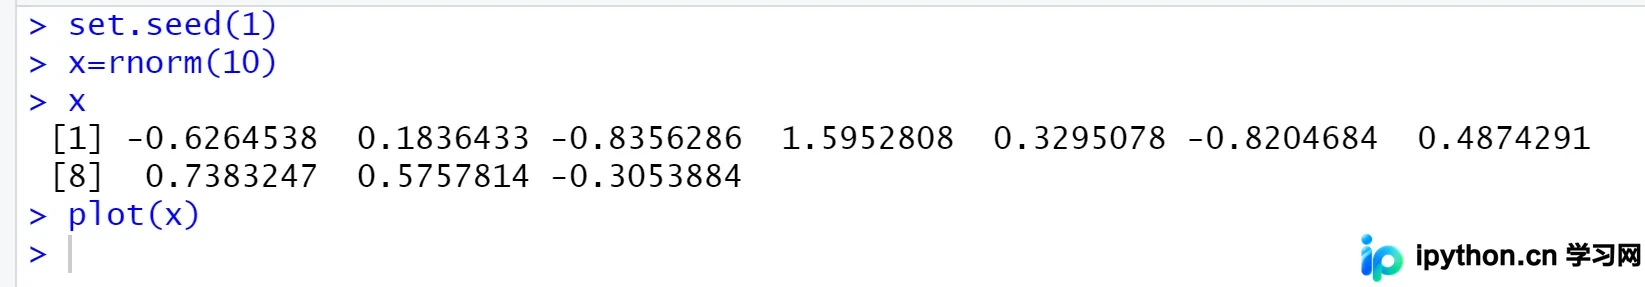
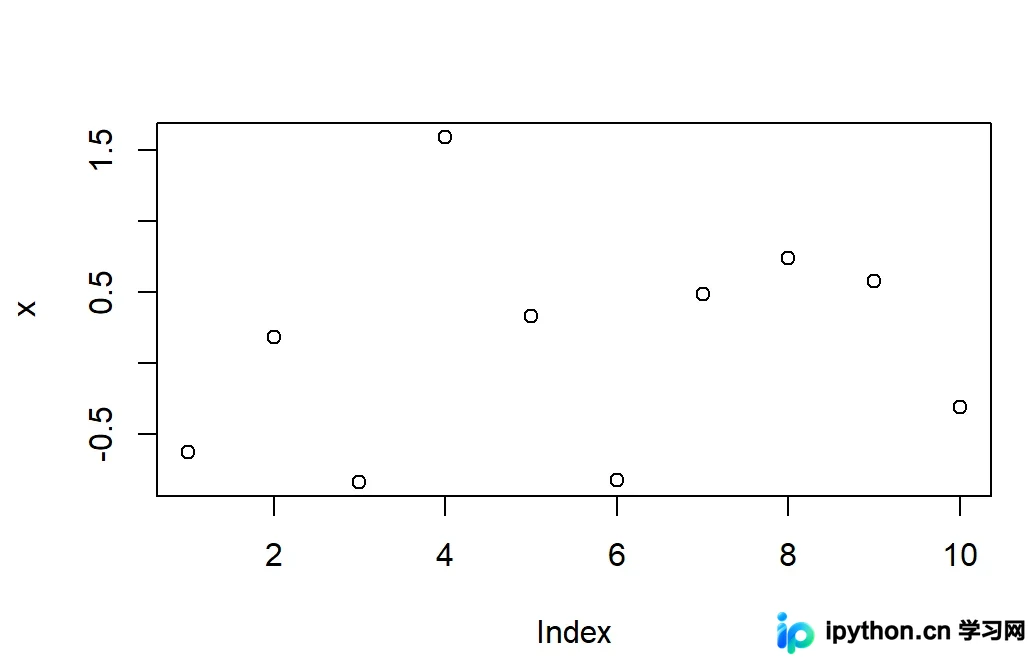
为了验证其稳定性,我们**保留**set.seed(1)这一行,再次完整运行一遍代码:
set.seed(1)          ## 设置种子为序号为1
x=rnorm(10)
x
plot(x)你会发现,生成的x值与原图完全一致:
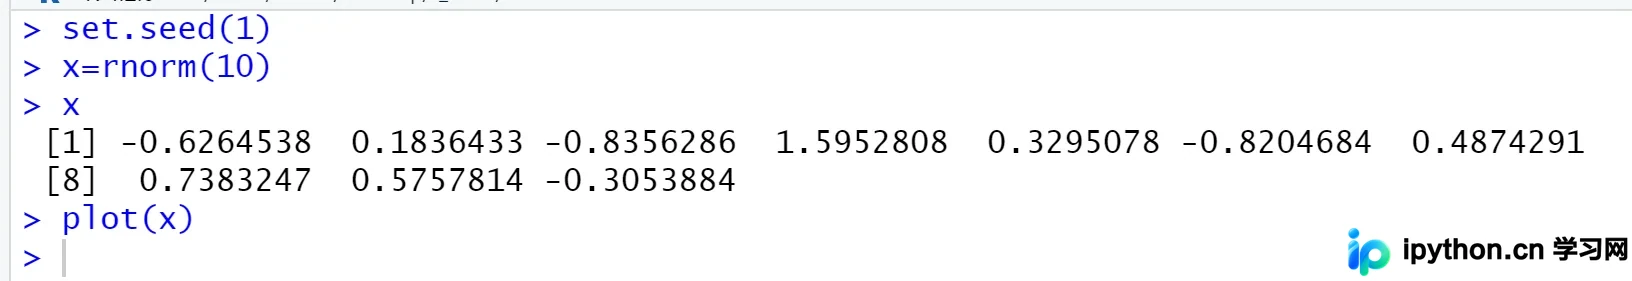
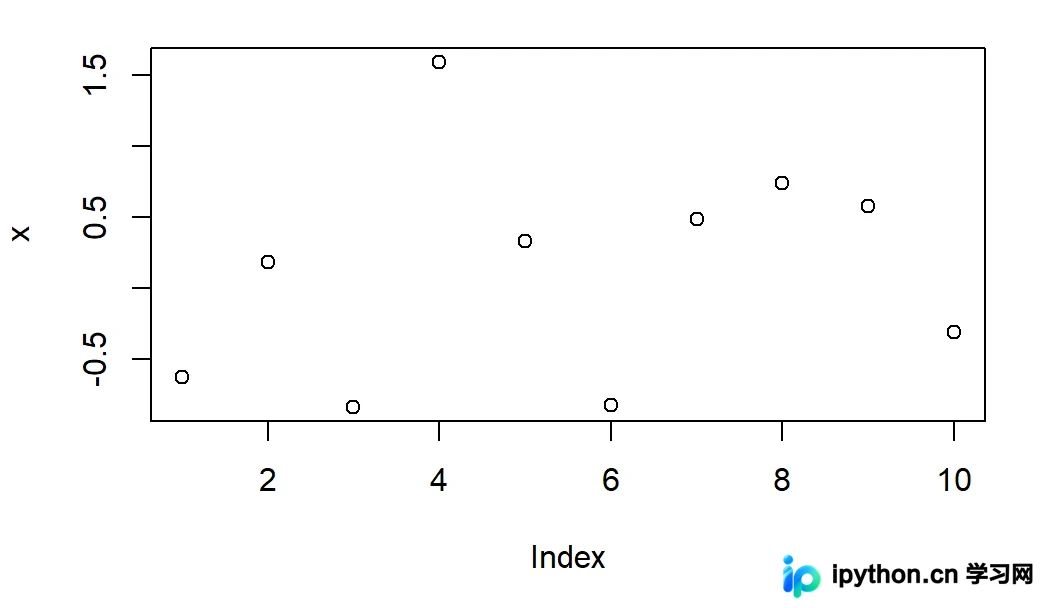
第三步:更换种子以获取不同序列
set.seed()括号内的参数(如1)仅仅代表你选择的第几号种子标记,它不参与后续的数学运算,仅作为算法初始化的依据。如果我们想获得另一组完全不同的随机数据,只需将种子改为其他整数即可。
修改之前的代码,将种子设为2:
set.seed(2)      ## 设置种子序号为2
x=rnorm(10)
x
plot(x)
运行后,输出的数值和图像均发生了显著变化:
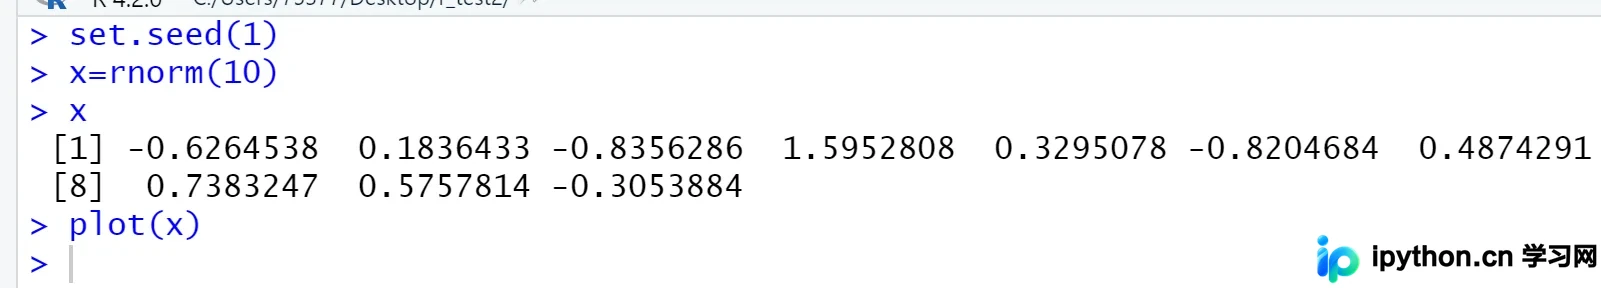
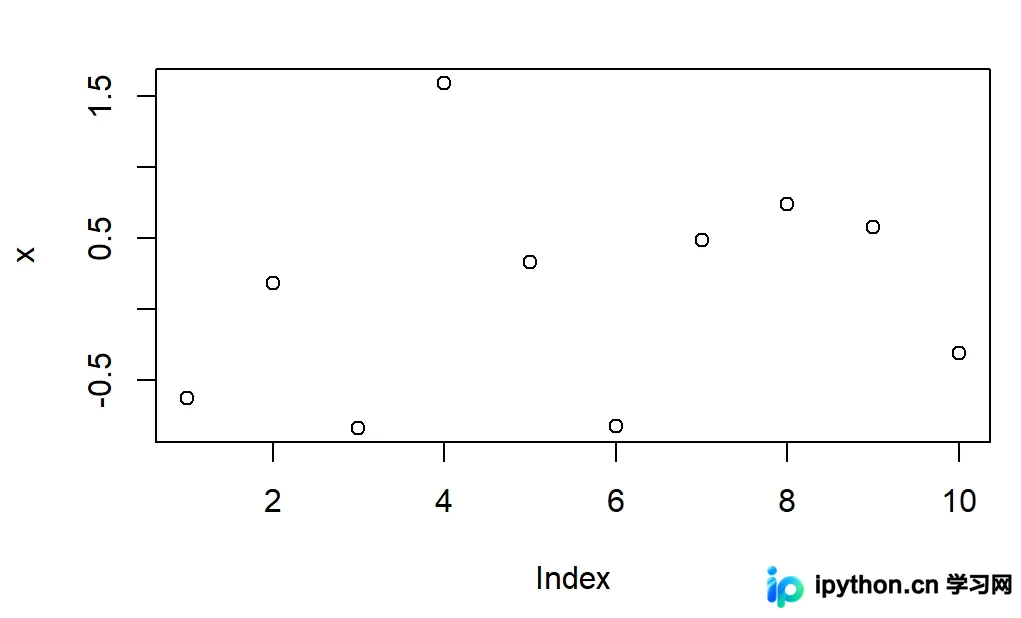
对比两组结果,可以看到:
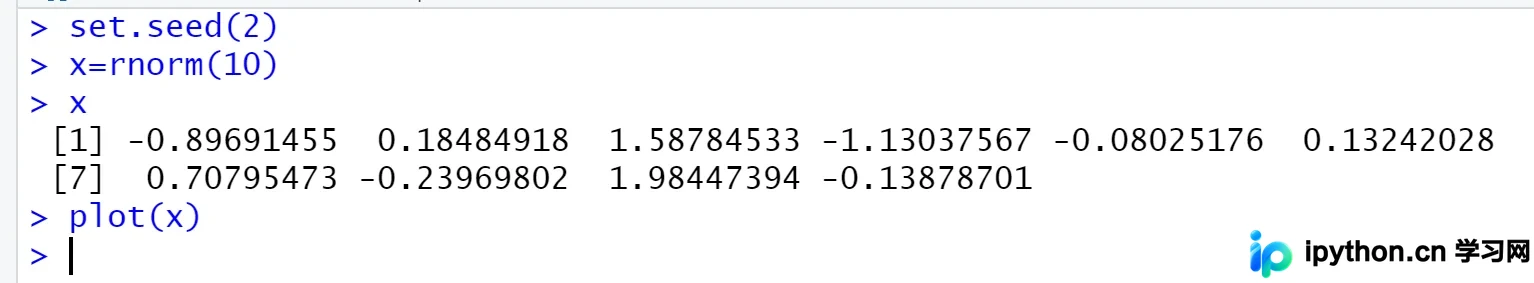
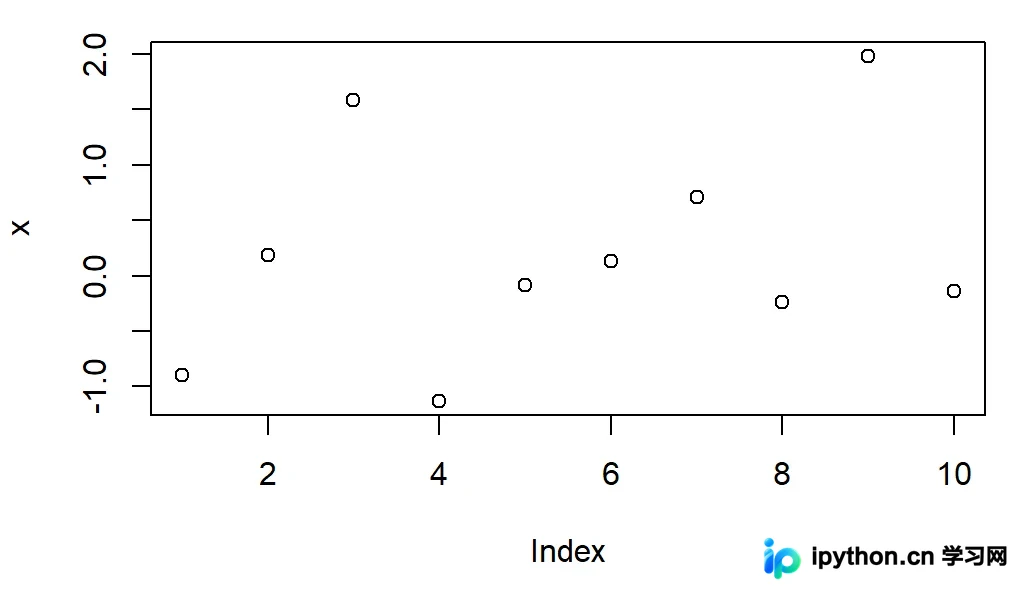
注意:虽然两组数据的随机性表现不同,但只要你分别将种子设回1和2并重新运行,这两组特定的结果将永远可以重现。
总结与应用建议
set.seed()的主要作用是确保实验的可重复性(Reproducibility)。在以下场景中强烈建议使用:
- 科研发表:确保审稿人或他人能根据代码复现你的图表和数据。
- 模型调优:在交叉验证或Bagging等基于采样的算法中,固定种子可以避免因随机采样带来的性能波动。
- 调试报告:当遇到难以追踪的Bug时,固定随机流有助于定位问题。
通常我们会选择一个易于记忆的整数作为种子(如年份、项目版本号或个人偏好数字),并在脚本开头统一声明,例如:set.seed(20231013)。
以上就是R语言中set.seed()函数作用与操作的详细内容,更多关于R语言随机数控制与实验复现的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









