

MySQL 分库分表路由策略设计与实现

在海量数据场景下,单表性能瓶颈促使采用分库分表方案。核心难点在于如何高效地将数据写入指定节点并精准读取。本文以订单系统为例,阐述如何选择合适的路由 Key(如用户 ID 或时间),结合 Hash 取模算法实现精确路由,并展示如何通过消息队列处理多端数据一致性,避免全表扫描。
概述
实施分库分表后,首要解决的问题是 路由 Key 的选择与路由规则的设计。理想的路由 Key 应在每个逻辑表中都存在且具有唯一性,同时路由策略应尽可能保证数据在各物理节点间均匀分布,避免热点倾斜。
根据业务特性,路由策略通常分为两类:
- 基于时间维度的归档策略:适用于日志、流水等随时间线性增长的数据。例如按数据的创建时间作为路由 Key,按月或季度自动创建新表。这种策略能有效分离冷热数据,历史访问流量大幅降低,绝大多数请求集中在最新的数据库表中。
- 基于业务关联的策略:将与当前查询最高频的业务主键作为路由 Key,确保同一业务实体的数据尽量聚集在同一分区,优化事务一致性和查询效率。
支持场景分析
以外卖订单平台为例,分库分表后需支撑以下核心业务场景:
- C 端用户视角:实时查看所点外卖订单状态,跟踪物流与信息进度。
- B 端商家视角:查询本店订单信息,通过销售数据分析菜品质量,辅助商业决策。
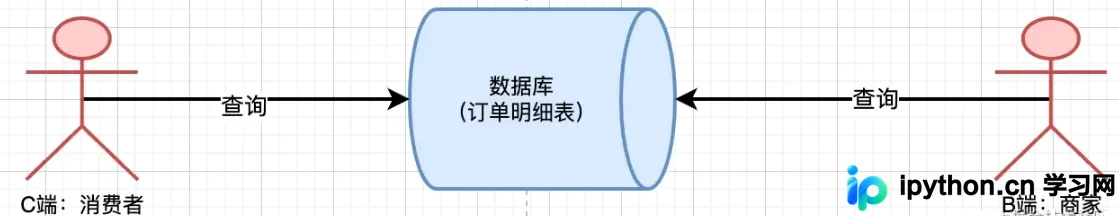
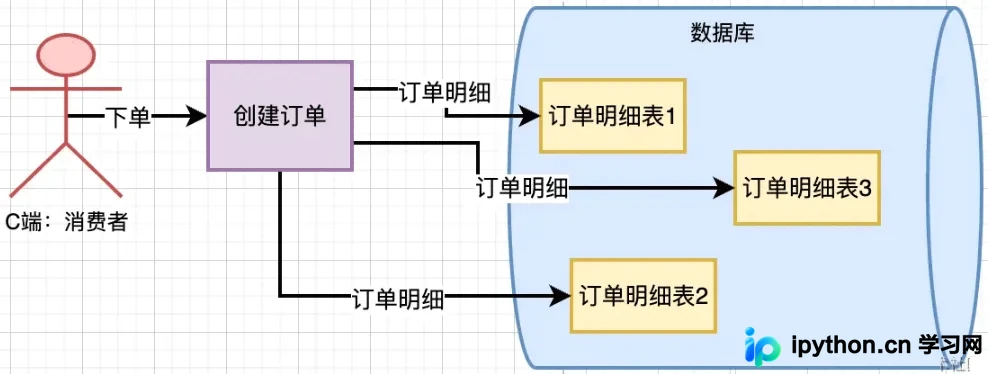
由于用户下单行为并发量大,订单数据会被分散存储在不同的物理表中。若缺乏有效的路由规则,查询操作可能需要遍历所有分片表,导致性能急剧下降。
路由策略核心设计
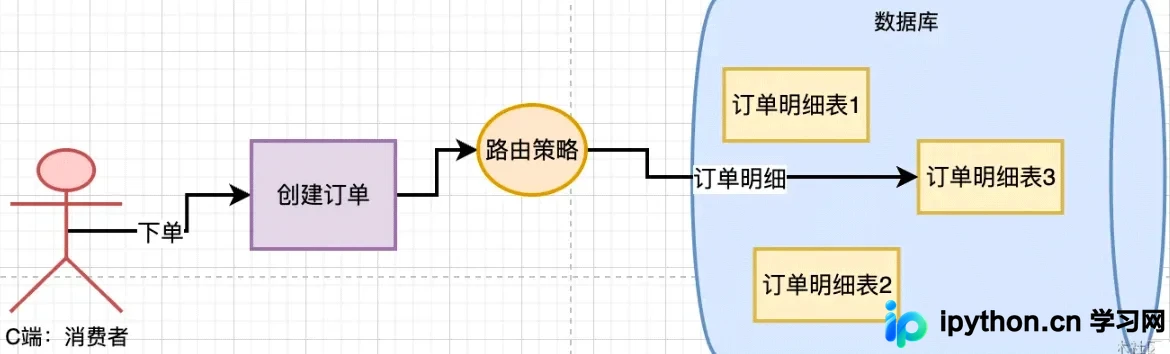
如果创建订单时随机插入到某一张表中,或者在查询时无法确定数据落在哪张表中,系统将不得不执行全库/全表扫描以确保数据的准确性,这在大数据量下是不可接受的。
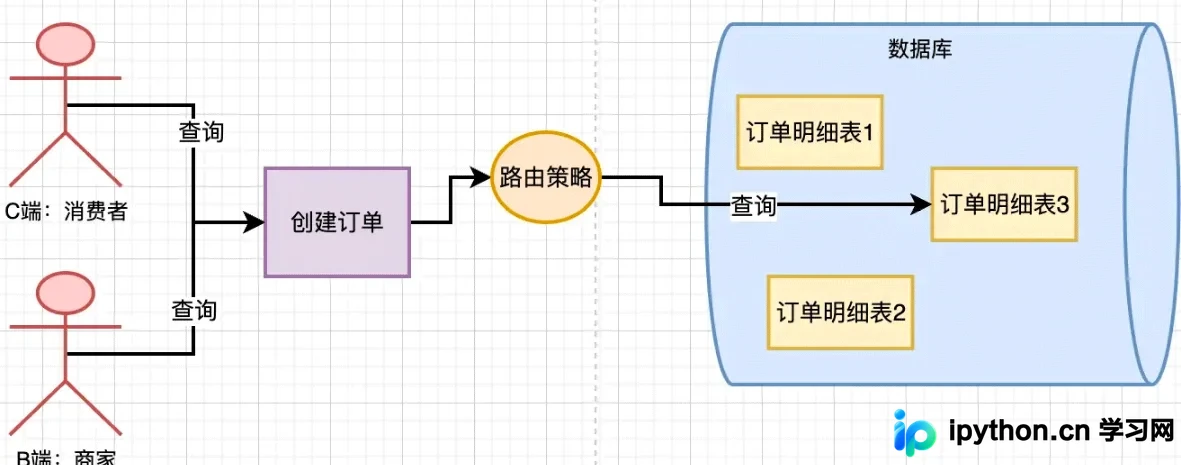
因此,必须建立确定性的路由规则:在插入和查询阶段严格执行相同的计算逻辑,将请求直接导向对应的物理节点,从而消除跨表合并的复杂性。用户端和商家端的查询都应遵循各自独立但内部统一的路由策略。
用户端路由 Key 设计
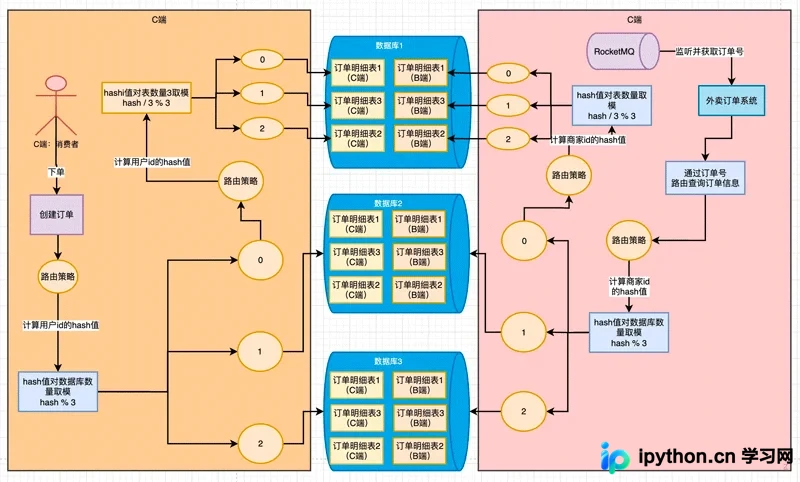
在 C 端场景中,确保同一个 用户 ID (user_id) 的所有数据都能被快速定位并保存到固定的表集中,是提升查询性能的关键。因此,选用 user_id 作为核心路由 Key。
单库分表路由
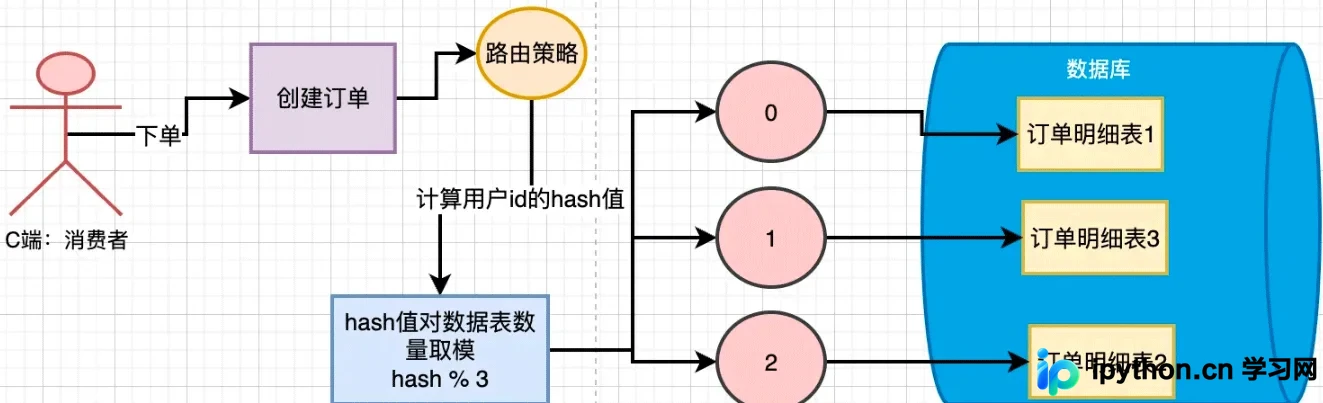
在单一数据库实例进行分表时,流程如下:
- 用户下单生成订单记录。
- 获取
user_id作为路由依据。 - 对
user_id进行 Hash 运算,得到 Hash 值。 - Hash 值对总表数量
N进行取模运算:table_index = hash(user_id) % N。 - 将数据写入计算得出的对应表中。
多库多表路由
当规模扩展至多库多表时,路由过程分为两步:先找库 → 再找表。
- 路由到数据库:根据
user_id的 Hash 值对数据库总数D取模,确定数据所在的物理数据库实例。db_index = hash(user_id) % D - 路由到数据表:在确定的数据库中,再次利用
user_id的 Hash 值对该库内的表数量T取模,确定具体的数据表。table_index = hash(user_id) % T
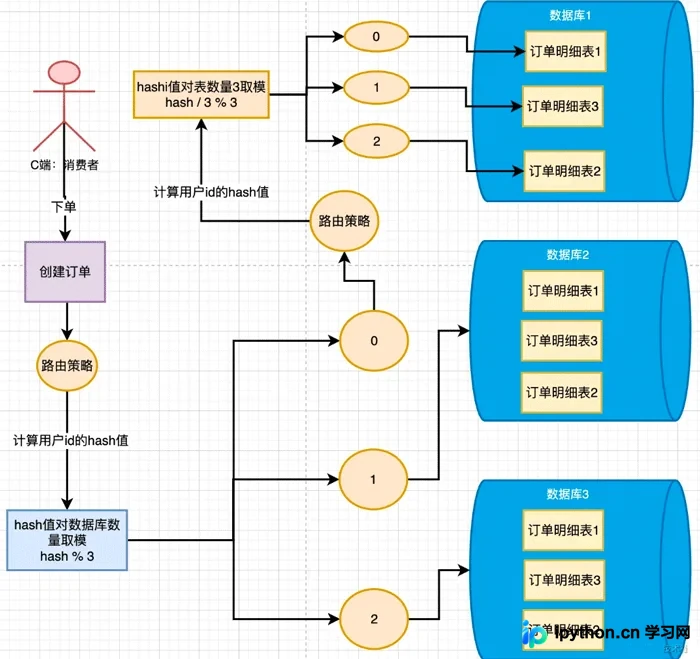
要点总结:路由策略的设计必须紧贴业务场景。对于强一致性要求高、查询频率大的核心实体,选取与其关联度最高的属性作为路由 Key 进行 Hash 取模,是平衡复杂度与性能的最佳实践。
商家端路由 Key 设计
为了减轻数据库负载并保持架构清晰,B 端(商家)的数据通常与 C 端独立存储在不同的一组表中,或者通过特定逻辑隔离。
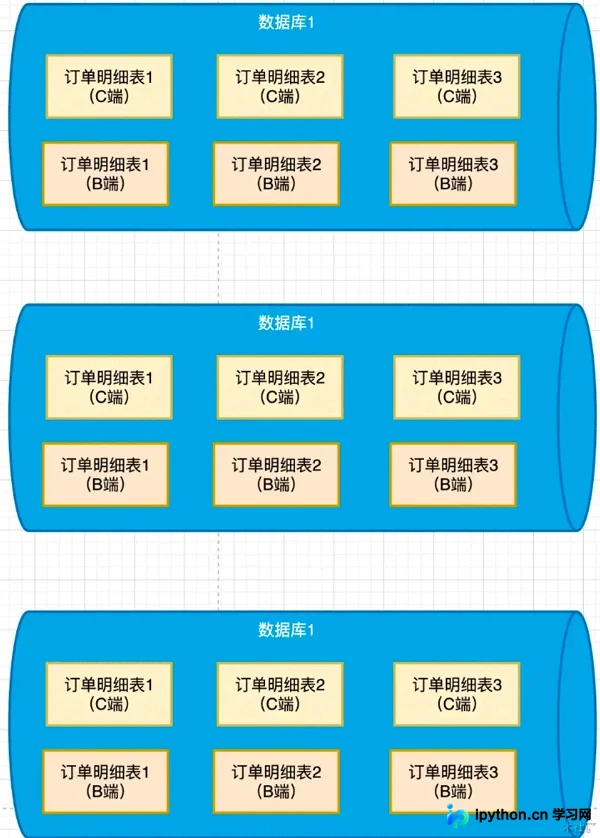
商家的路由 Key 选用 商家 ID (merchant_id)。但这里存在一个数据同步问题:商家如何获取属于其店铺的订单详情?
基于 MQ 的异步数据同步机制
- 订单产生:用户下单成功后,C 端订单落入其指定的分片表。
- 消息发送:系统将包含
order_id及相关属性的消息发送至消息队列(MQ)。 - 消息消费:商家服务订阅该 Topic,消费消息。根据
order_id反查或直接在本地构建订单详情。 - 数据存储:将整理好的订单信息,以
merchant_id为路由 Key,按照与 C 端相同的 Hash 取模逻辑,插入到商家专属的分片表中。
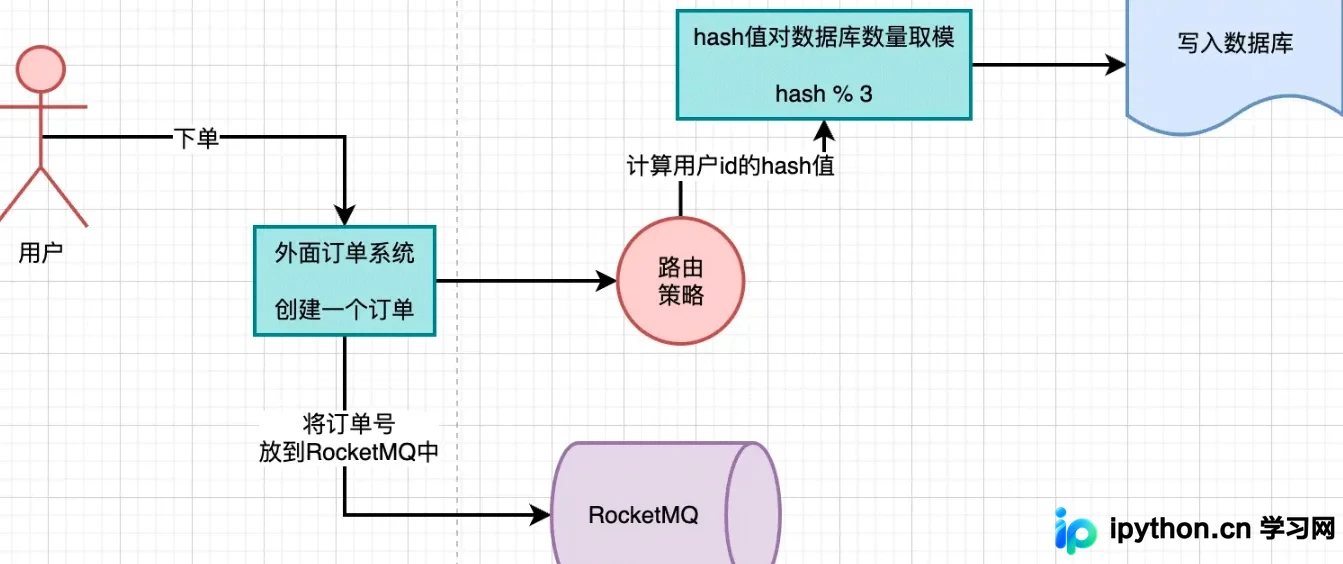
通过这种方式,用户端和商户端虽然拥有独立的物理表集合,但两端的数据流转逻辑保持一致,确保了各端查询的高效性。
以上就是 MySQL 分库分表后路由策略设计的详细内容,更多关于 MySQL 分库分表实战技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









