

R语言中filter函数实现精准数据行筛选详解

本文主要讲解在R语言中如何利用dplyr包的filter函数对数据进行高效的行筛选操作。内容涵盖基础数值条件过滤、多条件组合查询,以及针对复杂文本特征(含括号等)的正则表达式与固定字符串匹配技巧。
结果与准备:构建示例数据集
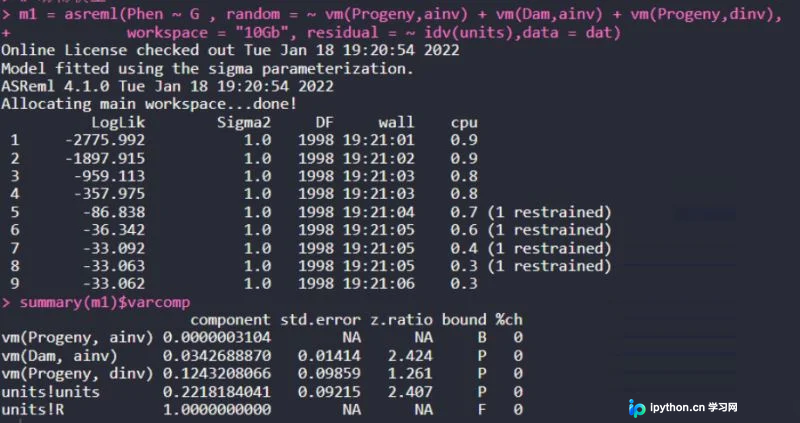
在进行行筛选前,首先需要明确数据结构。假设我们有一个从遗传分析工具(如asreml)导出的BLUP值数据框。coef(m1)$random返回的结果通常没有独立的ID列,行名中混杂了效应类型标识(例如前缀为vm(Progeny, ainv)表示加性效应,vm(Progeny,dinv)表示显性效应),这给直接按名称筛选带来了困难。
因此,第一步是将行名转换为独立的列,并根据分隔符拆解出类型和具体ID。
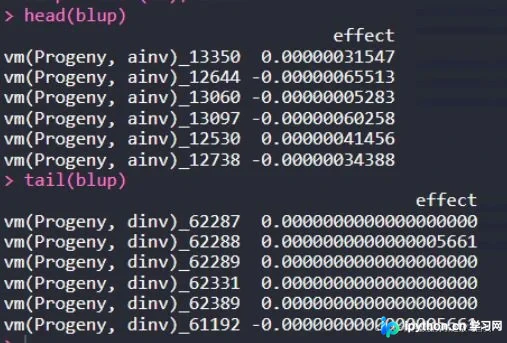
获取原始数据并查看:
blup = coef(m1)$random
head(blup)
tail(blup)
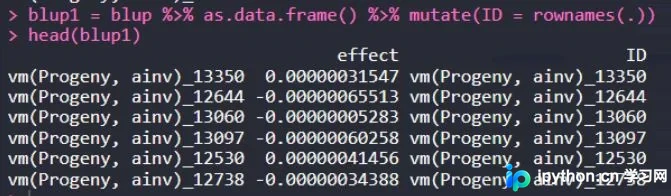
生成ID列和类型拆分:
首先将数据转为数据框并提取行名作为新列,随后根据下划线分割列:
blup1 = blup %>% as.data.frame() %>% mutate(ID = rownames(.))
head(blup1)
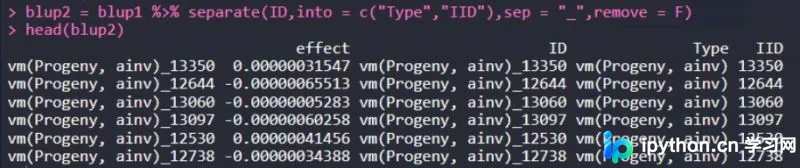
blup2 = blup1 %>% separate(ID,into = c("Type","IID"),sep = "_",remove = F)
head(blup2)
基础数值条件筛选
第1步:单条件数值过滤
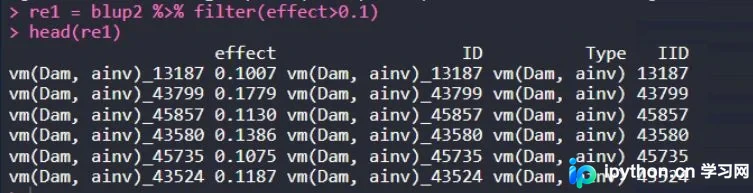
如果需要提取满足单一数值条件的行(例如提取效应值effect大于0.1的个体),可直接传入逻辑判断式。
入口:filter() 内部参数
动作:判断 effect > 0.1
完成状态:结果集仅包含符合条件的行
re1 = blup2 %>% filter(effect>0.1)
head(re1)
第2步:组合条件交集筛选
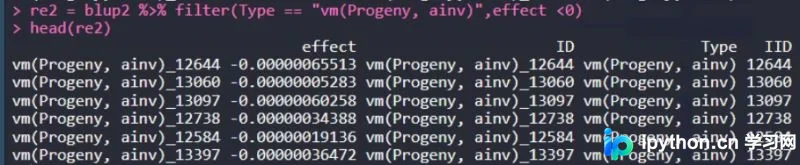
dplyr中的 filter 默认将所有逗号分隔的条件视为“与”(AND)关系。若需同时满足多个条件(例如:类型为加性效应且效应值为负数),只需连续书写条件。
入口:filter(Type == "...", effect < 0)
动作:逻辑与计算
完成状态:结果同时符合类型和数值范围要求
re2 = blup2 %>% filter(Type == "vm(Progeny, ainv)",effect <0)
head(re2)
高级文本模式匹配筛选
当筛选条件涉及部分行名或文本片段时,str_detect 是 stringr 包中与 filter 配合使用的利器。它支持正则表达式,但需注意特殊字符的转义或使用固定匹配模式。
第3步:基于通配特征的灵活筛选
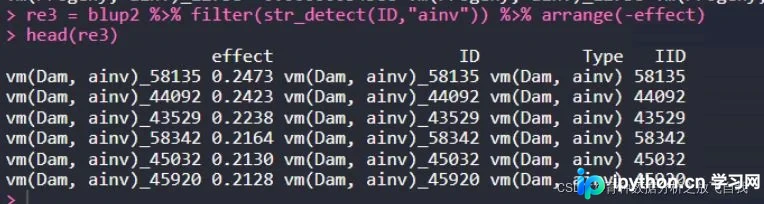
若只需识别包含特定关键词(如ainv)的行,并使用arrange按数值降序排列:
re3 = blup2 %>% filter(str_detect(ID,"ainv")) %>% arrange(-effect)
head(re3)
第4步:处理包含特殊字符的正则表达式
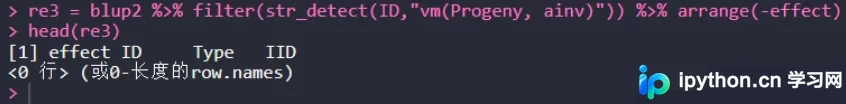
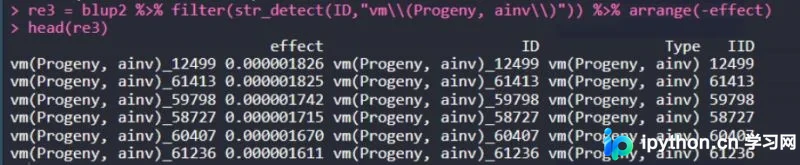
如果尝试直接搜索包含括号的完整字符串(如 vm(Progeny, ainv)),由于括号在正则中具有特殊含义(分组),直接输入会导致报错。
解决方法是对左/右括号使用双反斜杠进行转义 \\:
re3 = blup2 %>% filter(str_detect(ID,"vm\\(Progeny, ainv\\)")) %>% arrange(-effect)
head(re3)
第5步:使用 fixed() 进行精确字符匹配
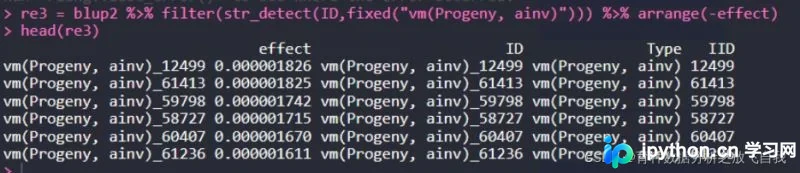
为了避免处理复杂的正则转义规则,可以使用 fixed() 函数包裹待匹配的字符串,从而将其视为纯粹的固定文本进行匹配。这是处理含有大量元字符的字符串最安全的方式。
入口:str_detect(col, fixed("pattern"))
动作:逐字匹配
完成状态:无需手动处理括号等特殊符号
re3 = blup2 %>% filter(str_detect(ID,fixed("vm(Progeny, ainv)"))) %>% arrange(-effect)
head(re3)
总结
以上就是R语言中filter函数的详细内容,更多关于R语言利用dplyr包高效进行数据行筛选的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









