

R语言ComplexHeatmap绘制复杂热图:从数据预处理到高级注释实战

ComplexHeatmap是R语言中用于生成出版级复杂热图的强大工具。本文将通过实际案例,讲解如何加载基因表达数据、清洗矩阵,以及利用HeatmapAnnotation添加临床表型、K-means聚类、行/列块注释等关键元素,并结合anno_mark实现目标基因的精准标记,全方位展示从基础绘图到高级定制的操作流程。
一、加载数据与矩阵预处理
ComplexHeatmap内置了多种演示数据,使用内置的基因表达数据可以更贴近真实的生信分析场景。首先需要载入包并读取示例矩阵,检查数据结构与维度。
第1步:加载环境与内置数据
目的:获取初始表达矩阵并了解其结构。
操作:
library(ComplexHeatmap)
# 读取内置基因表达数据
gene_expr = readRDS(paste0(system.file(package = "ComplexHeatmap"), "/extdata/gene_expression.rds"))
str(gene_expr)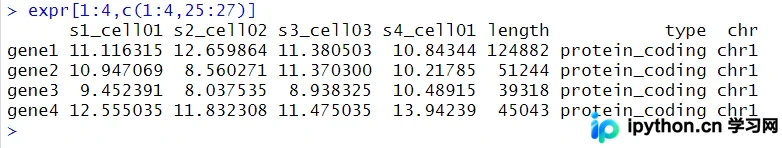
拿到新数据后,除了检查前几行,还需观察列名规律。本例中的列包含特定的细胞类型标识,后续需要针对性筛选。
第2步:矩阵筛选与转换
目的:去除无效列(如非细胞数据的冗余列),将数据框转换为热图所需的数值矩阵格式。
操作:
# 选取列名中包含 "cell" 的样本
mat = as.matrix(gene_expr[, grep("cell", colnames(gene_expr))])
第3步:绘制基准热图
目的:验证数据是否可直接绘图。
操作:
Heatmap(mat)二、添加临床“表型”注释
在热图顶部或底部添加临床信息(如年龄、分期)是文献中最常见的需求。这需要构建独立的注释矩阵并利用HeatmapAnnotation函数。
第4步:准备注释文件
参数:注释矩阵的行名需与主矩阵的列名严格一致。
操作:
anno <- read.csv("anno.csv", header = T)
head(anno)
# 输出示例:sample stage age
# s1_cell01     1  56
# s2_cell02     2  43
第5步:定义颜色映射规则
分类变量直接指定颜色名称;连续变量(如age)建议使用colorRamp2定义梯度。
# 连续变量颜色映射 (蓝色-白色-橙色)
col_fun2 <- colorRamp2(
  c(0, 50, 100),
  c("#ff7f00", "white", "#1f78b4")
) # 注意:若使用 RColorBrewer 风格可替换色板
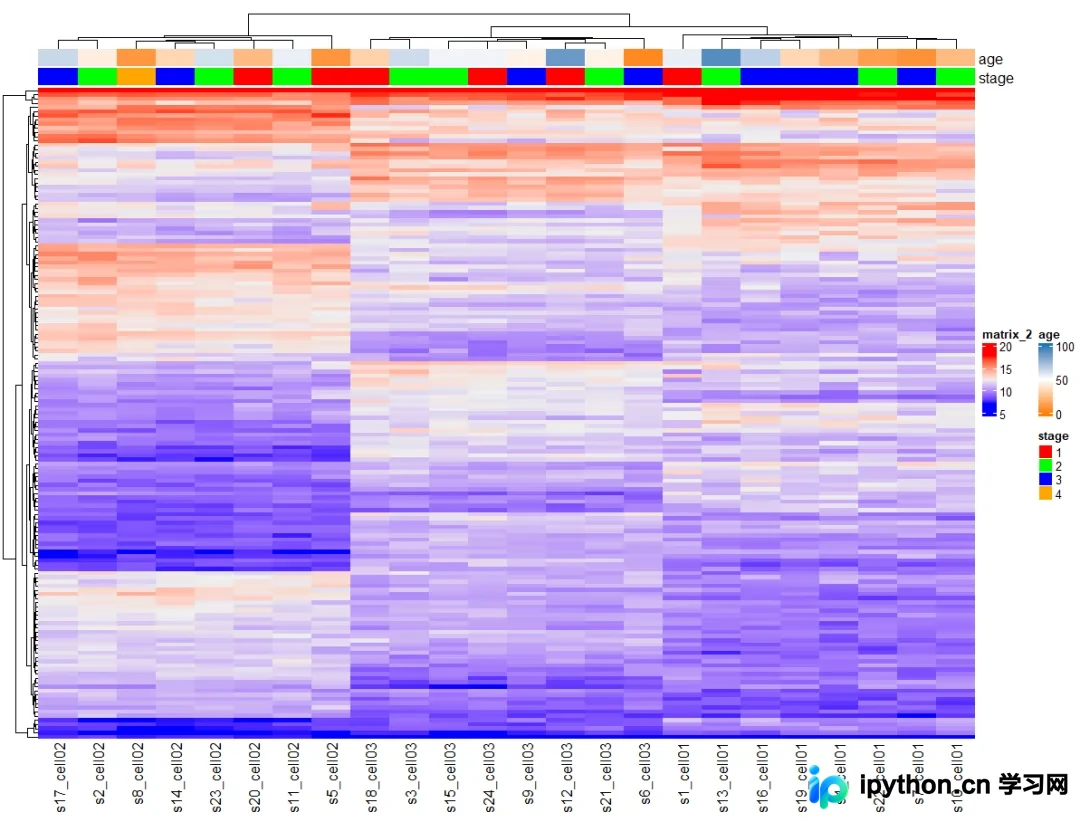
第6步:构建注释对象并应用到热图
入口:top_annotation, bottom_annotation 等。
操作:
ha <- HeatmapAnnotation(
  age = anno$age,
  stage = anno$stage,
  col = list(
    age = col_fun2,
    stage = c("1" = "red", "2" = "green", "3" = "blue")
  )
)

Heatmap(
  mat,
  top_annotation = ha
)
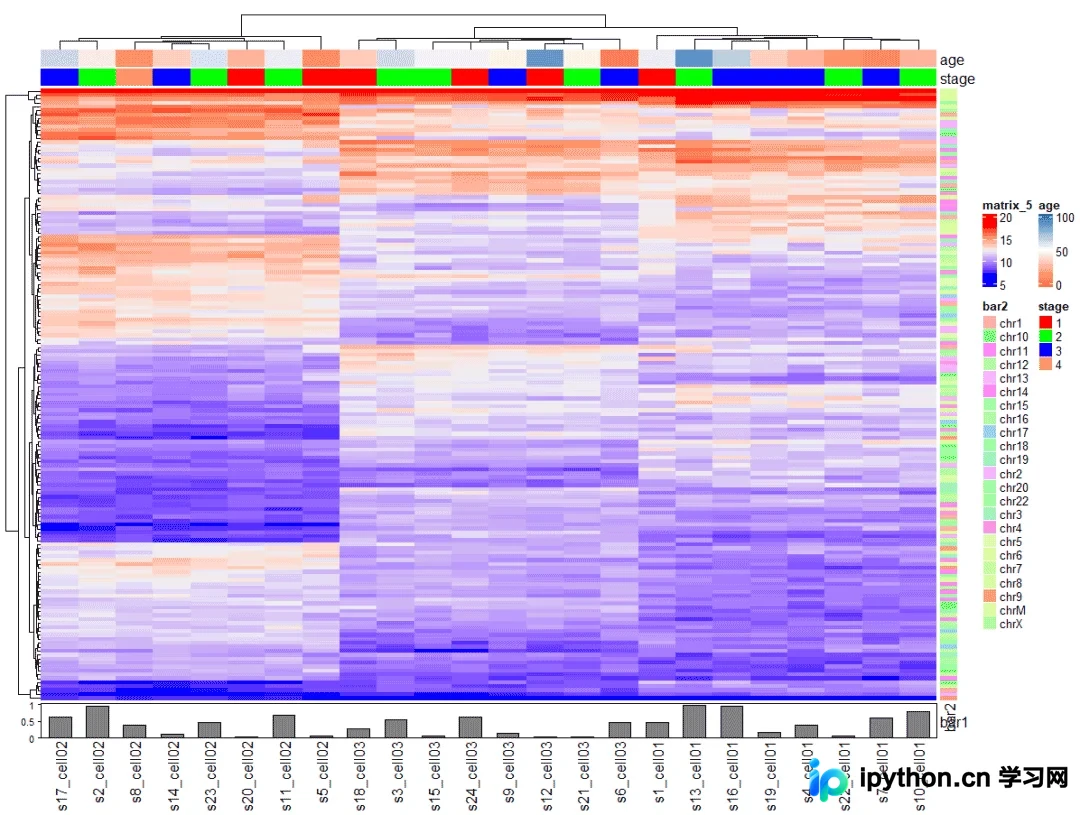
第7步:多位置全局注释
目的:当注释项较多时,分散在热图四周以避免拥挤。
操作:
column_ha <- HeatmapAnnotation(bar1 = anno_barplot(runif(24)))
row_ha <- rowAnnotation(bar2 = gene_expr$chr)

Heatmap(
  mat,
  show_row_names = FALSE,
  top_annotation = ha,
  bottom_annotation = column_ha,
  right_annotation = row_ha
)
三、聚类分析与“块”注释
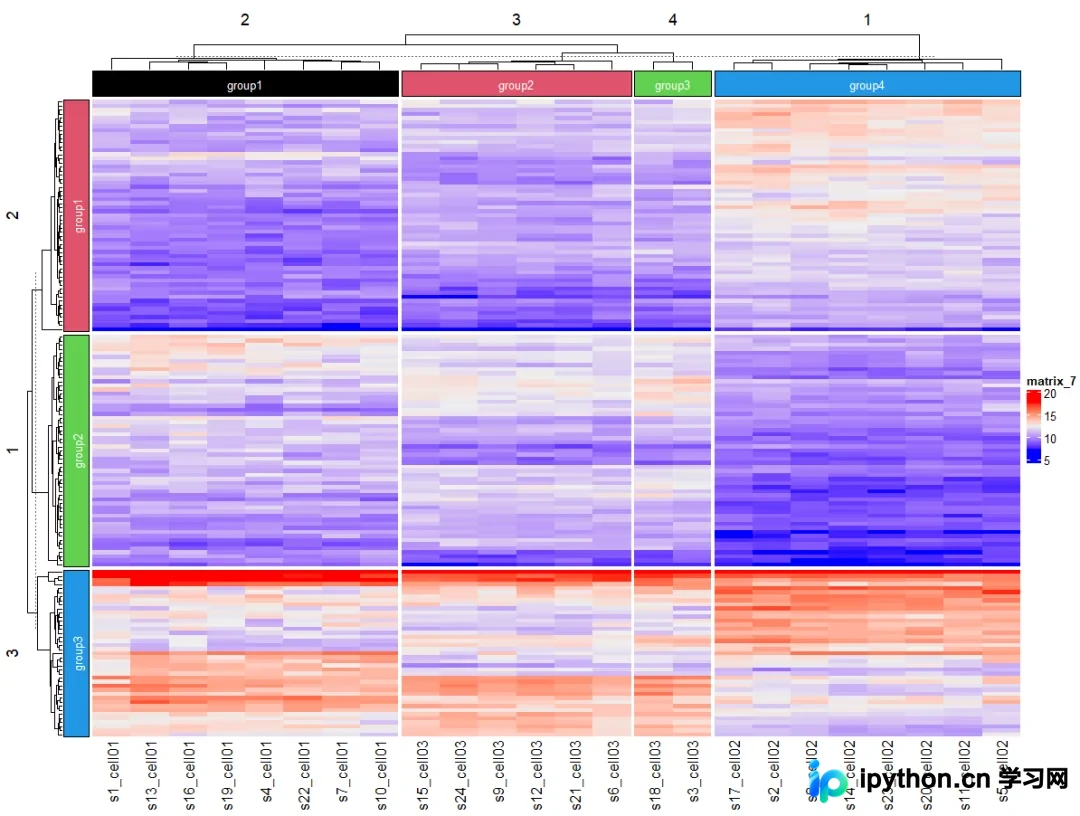
对数据进行聚类分块并在外部标注组别,能有效提升图表的信息量。这可以通过自动K-means聚类或手动指定先验知识实现。
第8步:K-means自动分组与块注释
参数:column_km (列数), row_km (行数)。结合anno_block可视化组别。
操作:
Heatmap(mat,
        top_annotation = HeatmapAnnotation(
            foo = anno_block(gp = gpar(fill = 1:4),
                             labels = c("Group1", "Group2", "Group3", "Group4")),
            labels_gp = gpar(col = "white", fontsize = 10)),
        column_km = 4,
        left_annotation = rowAnnotation(
            foo = anno_block(gp = gpar(fill = 2:4),
                             labels = c("RowG1", "RowG2", "RowG3")),
            labels_gp = gpar(col = "white", fontsize = 10)),
        row_km = 3,
        show_row_names = FALSE
)
第9步:调整标题与文本样式
目的:增强特定文本的可读性。
操作:利用row_title_gp、column_names_gp等参数微调字体颜色(如彩虹色)、大小和透明度。
# ... 在上述基础上叠加 gp 参数 ...
    row_names_gp = gpar(fontsize = 10, col = rainbow(5)[2:4]),
    column_title_gp = gpar(fill = rainbow(5)[1:4], alpha = 0.5)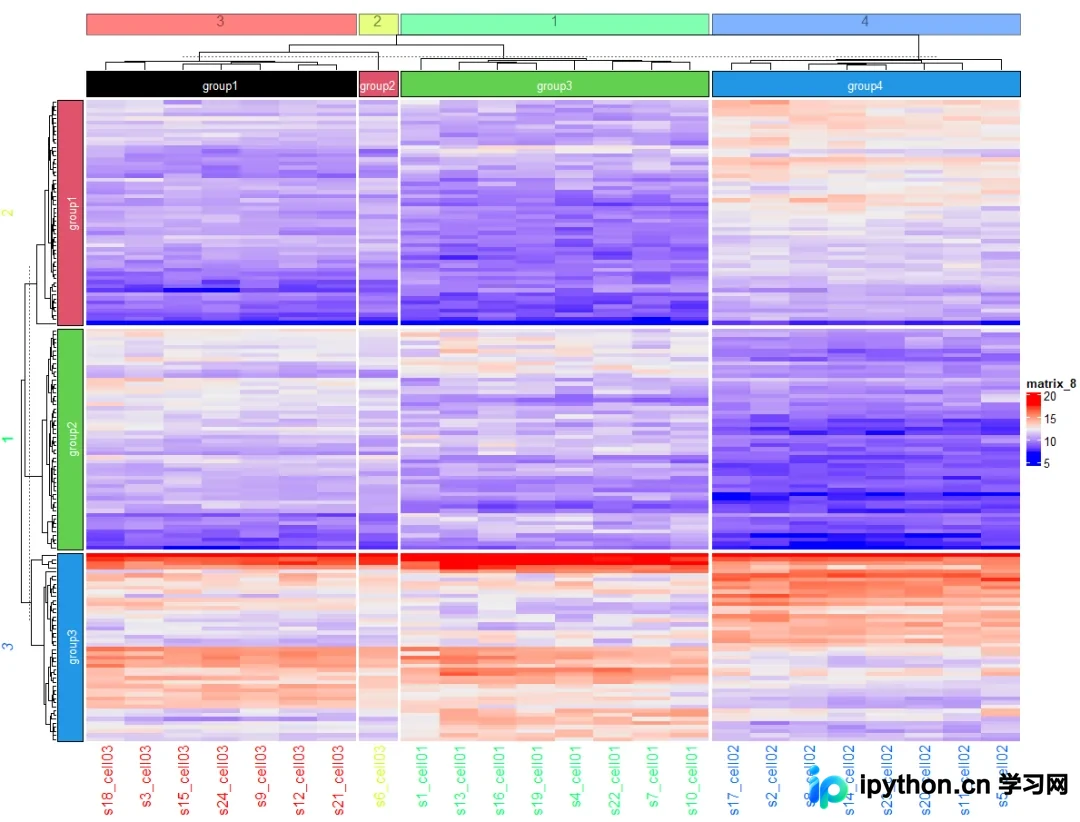
第10步:基于先验知识的手动拆分
目的:根据已知的临床分组(如早中期vs晚期)进行硬性拆分。
操作:使用column_split向量,并确保长度匹配列数。
split = c(rep(c("A","B"), 10), rep("C", 4)) # 自定义分组向量

Heatmap(mat,
        name = "mat_cluster",
        column_split = split,
        top_annotation = ha,
        cluster_rows = TRUE,
        cluster_columns = FALSE,
        column_title = NULL)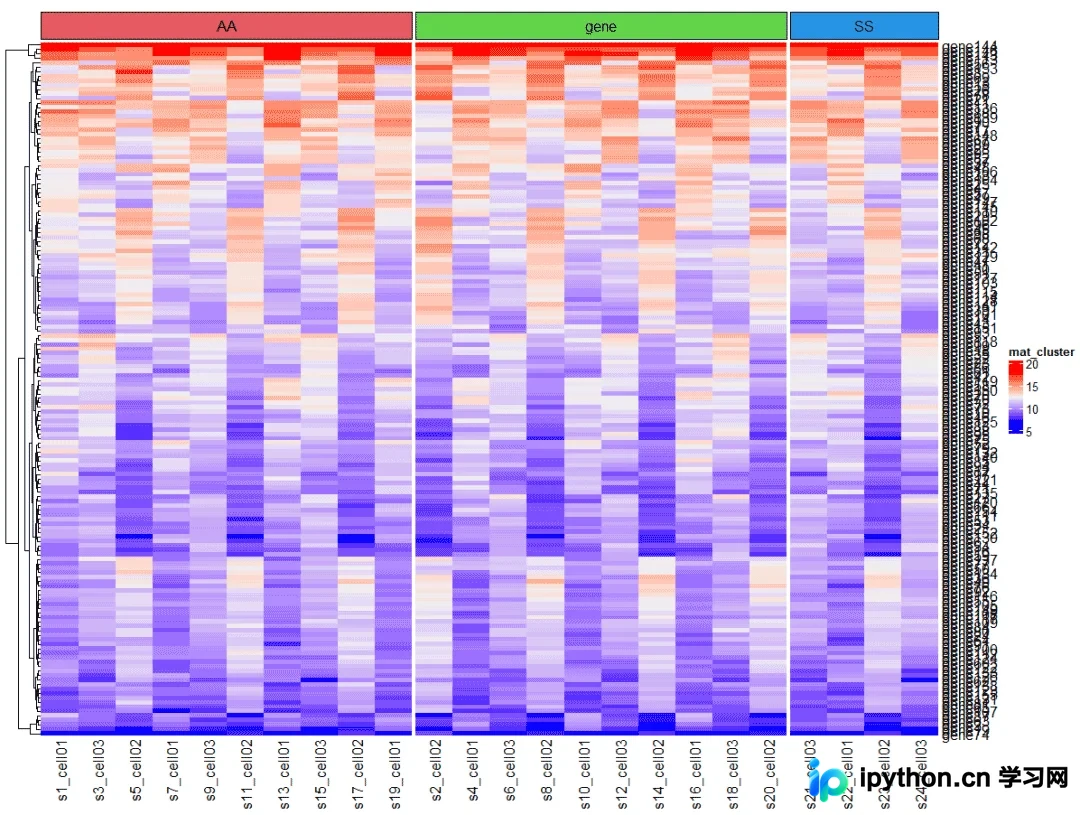
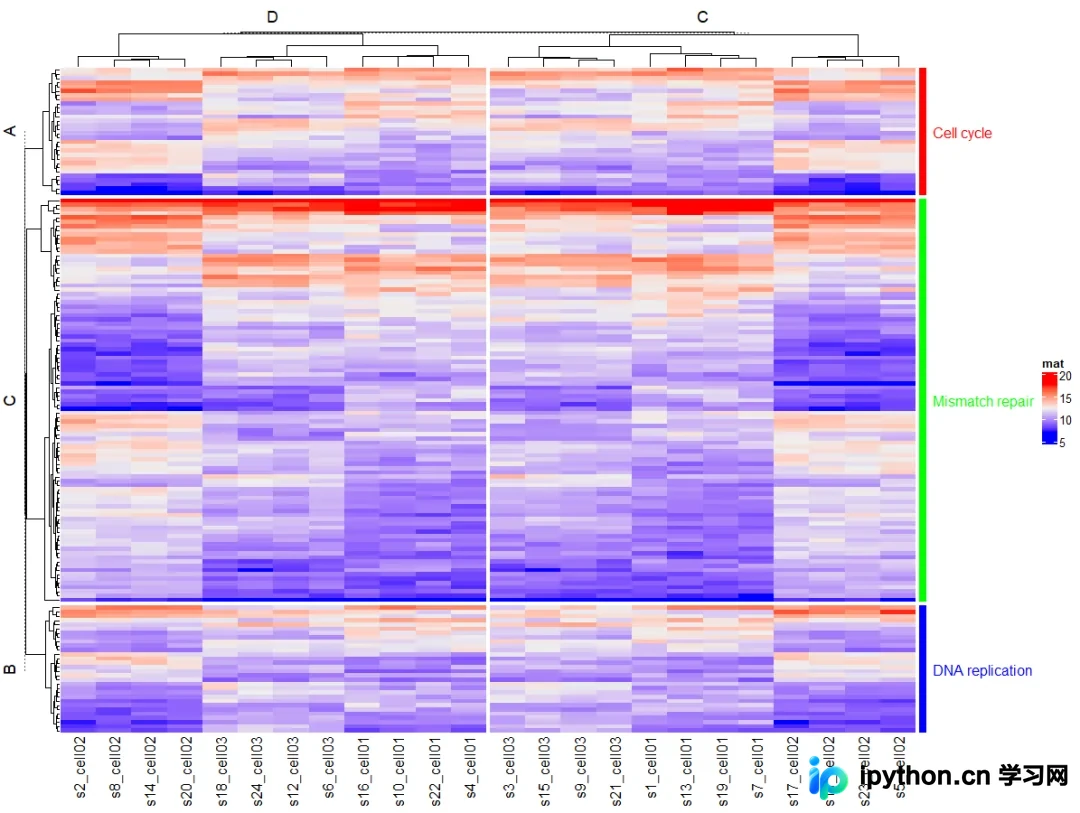
第11步:自定义富集通路块注释(右侧行注)
目的:在图侧标注KEGG通路或GO结果。
操作:先预留空白宽度,再利用decorate_annotation循环绘制色块与文字。
group <- list(A = "Cell cycle", B = "Mismatch repair", C = "DNA replication")

# 1. 预留空间
ha_empty = rowAnnotation(foo = anno_empty(
    width = max_text_width(unlist(group)) + unit(4, "mm")
))

# 2. 绘制热图主体
Heatmap(mat,
        right_annotation = ha_empty,
        row_split = c(rep(c("A","B"), 30), rep("C", 95)))

# 3. 绘制装饰层(需在 Heatmap() 调用后立即执行)
for(i in 1:3) {
    decorate_annotation("foo", slice = i, {
        grid.rect(x = 0, width = unit(2, "mm"),
                  gp = gpar(fill = rainbow(3)[i], col = NA), just = "left")
        grid.text(group[[i]], x = unit(4, "mm"),
                  gp = gpar(col = rainbow(3)[i]), just = "left")
    })
}
四、目标基因的特异性标记
当全基因组热图过密时,往往只需突出某几个靶点。ComplexHeatmap提供了两种主要策略:标记现有位置,或子集重绘。
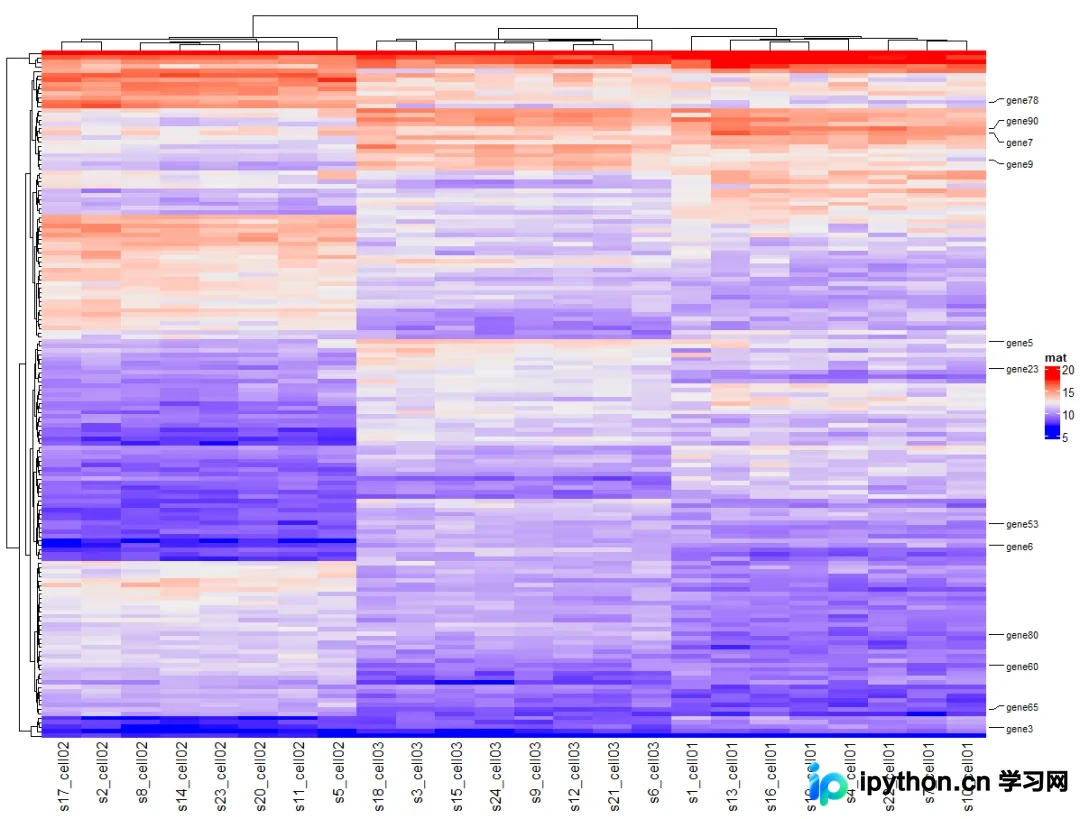
第12步:标注目标基因索引
参数:anno_mark。需提供索引坐标(at)和对应的标签(labels)。
操作:
# 假设已知要关注的基因列表
genelist <- c("gene1", "gene5", "gene53")
index <- which(rownames(mat) %in% genelist)
labs <- rownames(mat)[index]

lab2 <- rowAnnotation(foo = anno_mark(
    at = index,
    labels = labs,
    labels_gp = gpar(fontsize = 8)
))

Heatmap(mat,
        right_annotation = lab2,
        show_row_names = FALSE)
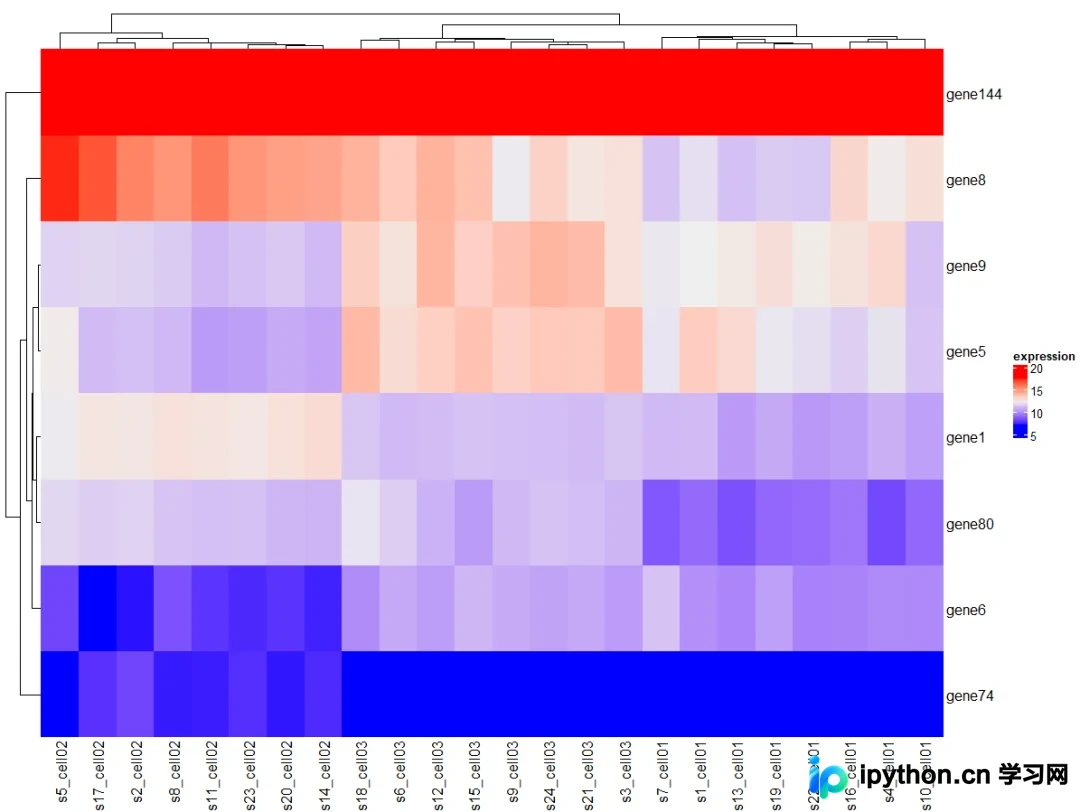
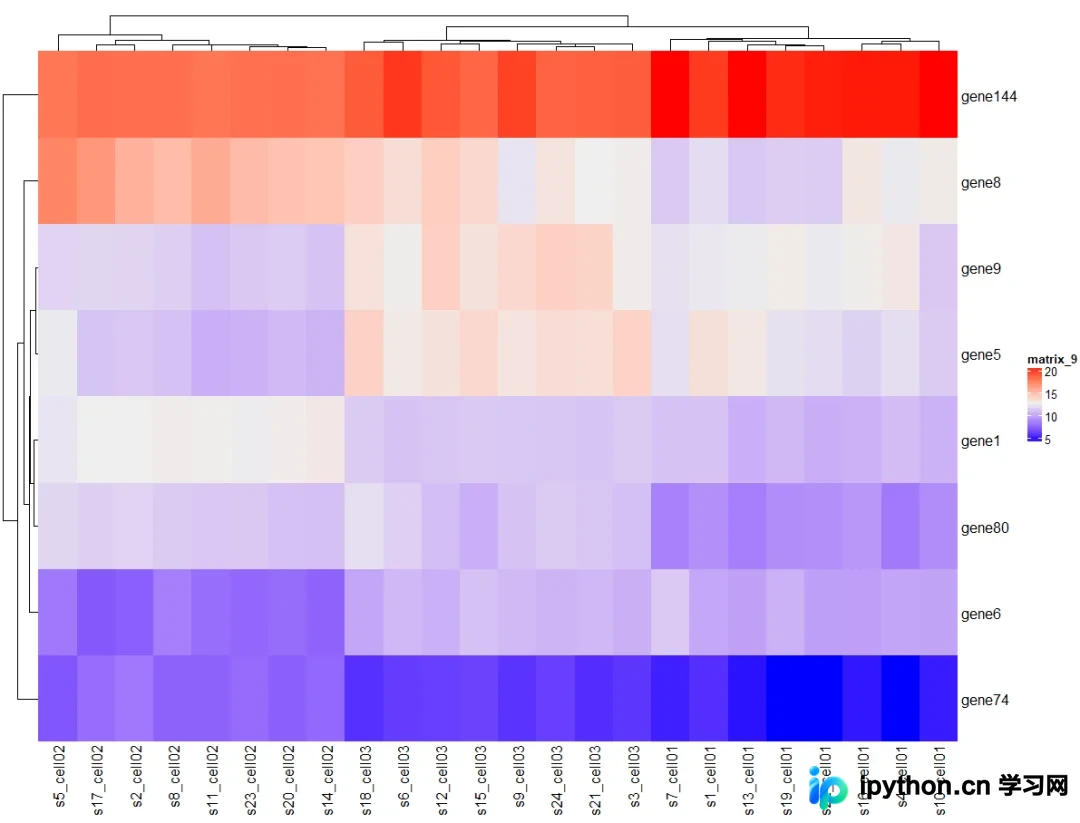
第13步:提取目标基因单独绘图
方法A:截取原热力图对象。保持与原图相同的配色方案,仅显示部分行。
方法B:独立数据重绘。使用dplyr管道过滤数据矩阵后,重新运行Heatmap()。
# 截取值
heatmap4[c(index), ]
# 或重建矩阵
library(dplyr)
mat_filtered <- as.data.frame(mat) %>%
rownames_to_column("gene") %>>%
filter(gene %in% labs) %>>%
column_to_rownames("gene")
Heatmap(as.matrix(mat_filtered))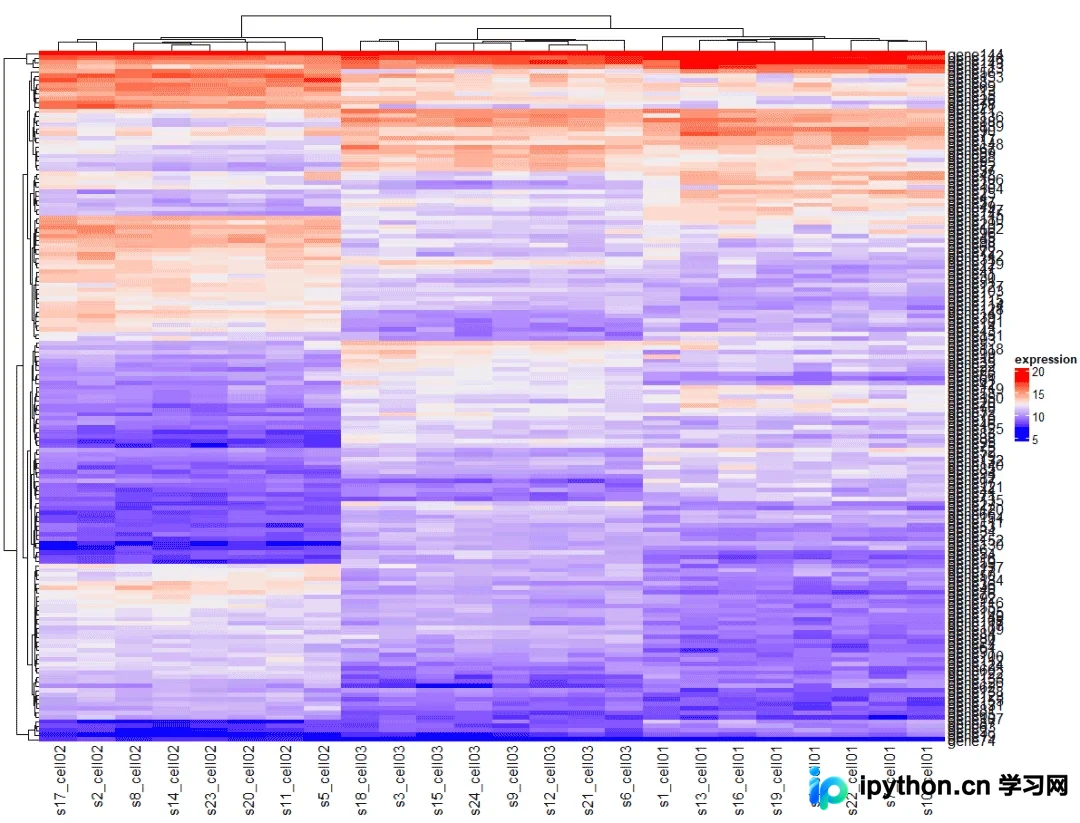
总结
ComplexHeatmap 的强大之处在于其高度可组合的注解系统。通过合理运用 HeatmapAnnotation、聚类拆分(column_split)以及装饰图层(decorate_annotation),可以制作出信息密度极高的科研级图表。以上为使用 R 语言 ComplexHeatmap 绘制复杂热图的详细操作指南,更多关于 R 语言数据分析的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









