

Python目标检测数据增强参数详解与代码实现

针对目标检测算法在复杂场景下鲁棒性不足的问题,本文详解基于Python的数据增强核心参数与同步处理逻辑。通过解析缩放比例、宽高扭曲及HSV色彩调整等关键配置,结合完整源码说明图像变换与边界框坐标校准的实现方法,帮助开发者快速掌握实时数据增强流程并提升模型泛化能力。
数据增强的核心作用与目标
目标检测模型在训练阶段依赖高质量且分布均匀的数据集。单一视角的图片容易导致网络过拟合,实际应用中物体常伴随光照变化、角度偏移与尺度差异。数据增强旨在通过可控的几何与色彩扰动,使输入样本呈现多样化形态,从而迫使神经网络学习更本质的特征表达,降低环境因素对识别精度的干扰。
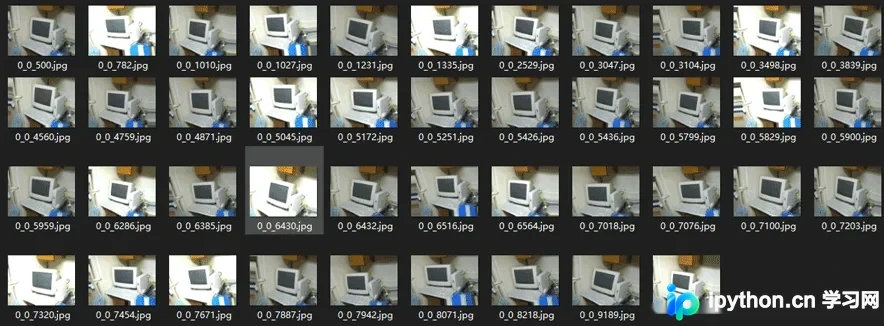
未经增强的样本在重复训练中形态高度一致,而经过合理扰动后的图像在保持语义不变的前提下增加了视觉多样性。将增强后的批次送入训练循环,可有效提升模型对亮度突变、局部遮挡及形变的适应能力。
关键参数的功能定义
在目标检测任务中,数据增强并非独立作用于像素矩阵,必须同步维护真实值(Ground Truth)标注的相对关系。核心控制参数及其默认取值如下:
scale(默认.25 ~ 2):控制整体图像缩放比率,防止目标过小或超出画布。jitter(默认.5):控制纵横比扭曲系数,公式推导范围为1-jitter至1+jitter,用于模拟非标准拍摄比例。hue、sat、val(默认分别为.1、1.5、1.5):对应 HSV 色彩空间的色调偏移量、饱和度乘数与明度乘数。采用对数对称扰动可避免极端偏色导致语义丢失。
完整代码结构与运行流程
以下函数封装了实时增强管线,支持读取单条标注记录并完成图像预处理与边界框对齐。实际使用时直接导入 DataLoader 迭代调用即可。
第1步:初始化与输入格式解析
入口参数包含标注行字符串 annotation_line 与目标输入尺寸 input_shape。代码首先按空格分割路径与坐标列表,利用 PIL.Image.open 获取原始分辨率 (iw, ih),并将数值型坐标转换为 NumPy 矩阵。
第2步:图像缩放与背景填充
根据 jitter 生成目标纵横比,结合 scale 计算缩放后的高宽 (nw, nh)。调用 image.resize() 完成重采样后,在固定尺寸的灰色底板 (w, h) 上随机选取粘贴坐标 (dx, dy),保留中心区域的同时引入位置随机性。
第3步:随机翻转与色域扰动
以 50% 概率执行水平镜像 FLIP_LEFT_RIGHT。随后进入 HSV 空间转换,对 H 通道叠加 [-hue, hue] 随机偏移,对 S 与 V 通道执行 [1, sat/val] 区间的乘除对称扰动。最终通过阈值钳位 x[x>1]=1 与 x[x<0]=0 防止越界溢出。
第4步:边界框坐标同步校准
图像变换必须严格映射至标注框。先按相同缩放比例 nw/iw 与 nh/ih 平移坐标原点,加上粘贴偏移 dx/dy。若触发翻转,则执行 w - box[:, [2,0]] 镜像计算。最后裁剪越界值并丢弃宽高小于 1 像素的无效框,确保返回的检测框数量不超过 max_boxes。
from PIL import Image, ImageDraw
import numpy as np
from matplotlib.colors import rgb_to_hsv, hsv_to_rgb

def rand(a=0, b=1):
    return np.random.rand()*(b-a) + a

def get_random_data(annotation_line, input_shape, random=True, max_boxes=20, jitter=.5, hue=.1, sat=1.5, val=1.5, proc_img=True):
    '''random preprocessing for real-time data augmentation'''
    line = annotation_line.split()
    image = Image.open(line[0])
    iw, ih = image.size
    h, w = input_shape
    box = np.array([np.array(list(map(int,box.split(',')))) for box in line[1:]])

    # 对图像进行缩放并且进行长和宽的扭曲
    new_ar = w/h * rand(1-jitter,1+jitter)/rand(1-jitter,1+jitter)
    scale = rand(.25, 2)
    if new_ar < 1:
        nh = int(scale*h)
        nw = int(nh*new_ar)
    else:
        nw = int(scale*w)
        nh = int(nw/new_ar)
    image = image.resize((nw,nh), Image.BICUBIC)

    # 将图像多余的部分加上灰条
    dx = int(rand(0, w-nw))
    dy = int(rand(0, h-nh))
    new_image = Image.new('RGB', (w,h), (128,128,128))
    new_image.paste(image, (dx, dy))
    image = new_image

    # 翻转图像
    flip = rand()<.5
    if flip: image = image.transpose(Image.FLIP_LEFT_RIGHT)

    # 色域扭曲
    hue = rand(-hue, hue)
    sat = rand(1, sat) if rand()<.5 else 1/rand(1, sat)
    val = rand(1, val) if rand()<.5 else 1/rand(1, val)
    x = rgb_to_hsv(np.array(image)/255.)
    x[..., 0] += hue
    x[..., 0][x[..., 0]>1] -= 1
    x[..., 0][x[..., 0]<0] += 1
    x[..., 1] *= sat
    x[..., 2] *= val
    x[x>1] = 1
    x[x<0] = 0
    image_data = hsv_to_rgb(x) # numpy array, 0 to 1

    # 将box进行调整
    box_data = np.zeros((max_boxes,5))
    if len(box)>0:
        np.random.shuffle(box)
        box[:, [0,2]] = box[:, [0,2]]*nw/iw + dx
        box[:, [1,3]] = box[:, [1,3]]*nh/ih + dy
        if flip: box[:, [0,2]] = w - box[:, [2,0]]
        box[:, 0:2][box[:, 0:2]<0] = 0
        box[:, 2][box[:, 2]>w] = w
        box[:, 3][box[:, 3]>h] = h
        box_w = box[:, 2] - box[:, 0]
        box_h = box[:, 3] - box[:, 1]
        box = box[np.logical_and(box_w>1, box_h>1)] # discard invalid box
        if len(box)>max_boxes: box = box[:max_boxes]
        box_data[:len(box)] = box
    return image_data, box_data

def normal_(annotation_line, input_shape):
    line = annotation_line.split()
    image = Image.open(line[0])
    box = np.array([np.array(list(map(int,box.split(',')))) for box in line[1:]])
    return image, box

if __name__ == "__main__":
    with open("2007_train.txt") as f:
        lines = f.readlines()
    a = np.random.randint(0,len(lines))
    line = lines[a]

    # 渲染原始参考图
    image_data, box_data = normal_(line,[416,416])
    img = image_data
    for j in range(len(box_data)):
        thickness = 3
        left, top, right, bottom  = box_data[j][0:4]
        draw = ImageDraw.Draw(img)
        for i in range(thickness):
            draw.rectangle([left + i, top + i, right - i, bottom - i],outline=(255,255,255))
    img.show()

    # 渲染增强结果
    image_data, box_data = get_random_data(line,[416,416])
    print(box_data)
    img = Image.fromarray((image_data*255).astype(np.uint8))
    for j in range(len(box_data)):
        thickness = 3
        left, top, right, bottom  = box_data[j][0:4]
        draw = ImageDraw.Draw(img)
        for i in range(thickness):
            draw.rectangle([left + i, top + i, right - i, bottom - i],outline=(255,255,255))
    img.show()
测试验证与结果核对
脚本末尾的 __main__ 模块提供即时验证入口。读取随机标注行后,分别调用原始解析函数与增强函数生成 image_data 与 box_data。控制台打印的边界框矩阵可直接对照增强后图像的视觉覆盖范围。
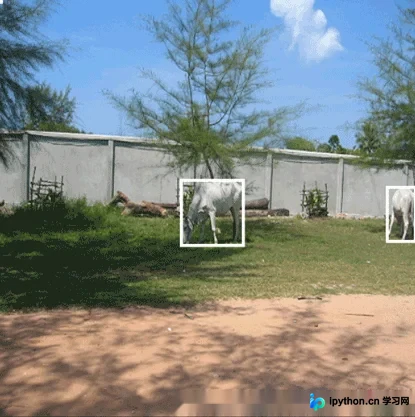
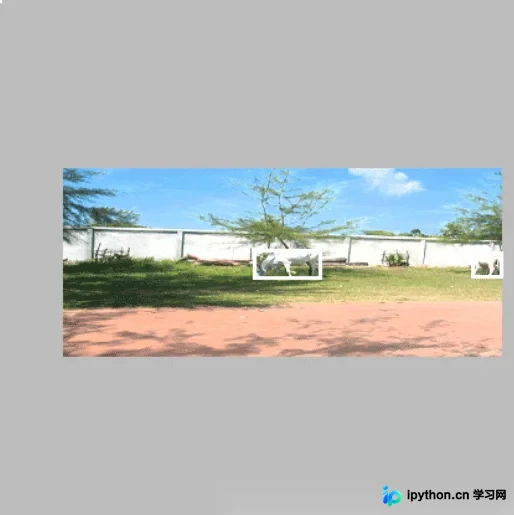
核对重点包括:① 检测框是否紧密贴合增强后物体的轮廓边缘;② 水平翻转时框坐标是否准确镜像至画面另一侧;③ 控制台输出的 NaN 或越界值是否在二次渲染前被正常过滤。满足以上条件即表示管线运行正确。
异常处理与兼容性排错
若在数据准备阶段遇到 InvalidBox 或训练收敛缓慢,请按以下顺序排查:
- 标注文件解析错位:确认
line.split()的分隔符与数据集实际制表符/逗号一致,路径需使用绝对目录或正确配置基础工作目录。 - 缩放比例失衡:适当缩小
scale上限或增大jitter限制,避免目标主体被压缩至无法提取特征的极小尺寸。 - 色彩过曝/过暗:降低
sat与val的最大乘数至1.2左右,保留主体纹理细节。
总结
目标检测的数据增强本质是物理世界不确定性的数学映射。合理设置几何扭曲与色域扰动参数,配合严格的边界框同步校准逻辑,能够显著拓宽模型的特征决策边界。以上就是python目标检测数据增强的代码参数解读及应用的详细内容,更多关于目标检测模型训练与数据预处理的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









