

C/C++内存管理详解:堆与栈的区别及使用场景

指针被视为C语言的精髓,也是初学者难以跨越的门槛。由于C/C++允许直接操作内存以换取高性能,理解进程内存布局中的栈与堆是掌握指针的基础。本文将详细解析两者在分配方式、性能、大小限制及适用场景上的核心区别,并提供实际开发建议。
C/C++为何需要指针?
在C++中,虽然自C++11引入智能指针(smart pointer)大幅减少了裸指针的使用,但完全避免指针并不现实。原因在于团队协作中无法保证其他成员或合作方不使用指针,且许多底层交互仍需裸指针支持。指针的存在根植于进程的内存布局,只有理解了内存如何划分,才能理解内存管理的本质。
进程内存布局结构
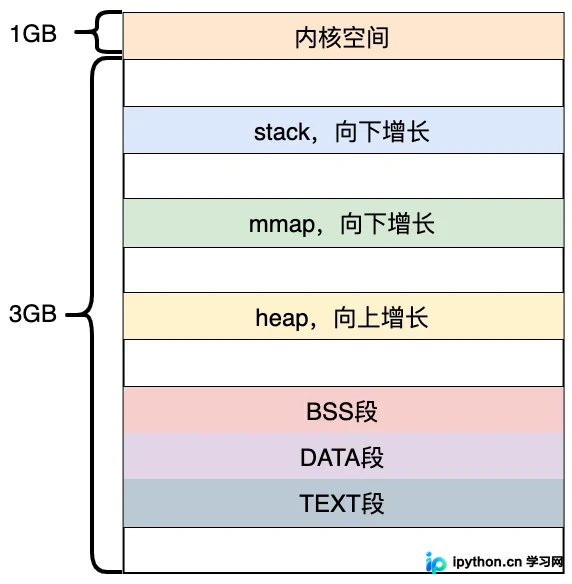
以32位进程为例,其内存空间主要分为以下几个关键区域:
- 内核空间:供操作系统内核使用,存储内核代码与数据。
- Stack(栈):存储自动变量(automatic variable),由编译器自动管理。
- mmap(内存映射):用于在虚拟地址空间中创建与物理内存的映射关系,常用于共享内存或动态库加载。
- Heap(堆):用于动态内存分配,由开发者手动管理。
- BSS段:存放未初始化的全局和静态变量,由0或空指针初始化。
- Data段:存放已初始化的全局和静态变量,具有读写权限。
- Text段(代码段):存放编译后的二进制机器码,通常为只读且可共享。
本文将重点聚焦于栈(Stack)与堆(Heap),因为它们是应用程序运行时内存分配的主要场所。
栈(Stack)详解
栈是一块连续的内存区域,其最显著的特点是“后进先出”(FILO)。编译器在编译阶段即可确定局部变量的大小,因此在函数调用时,相关变量直接在栈上分配;函数结束时,变量自动释放,内存归还给栈。
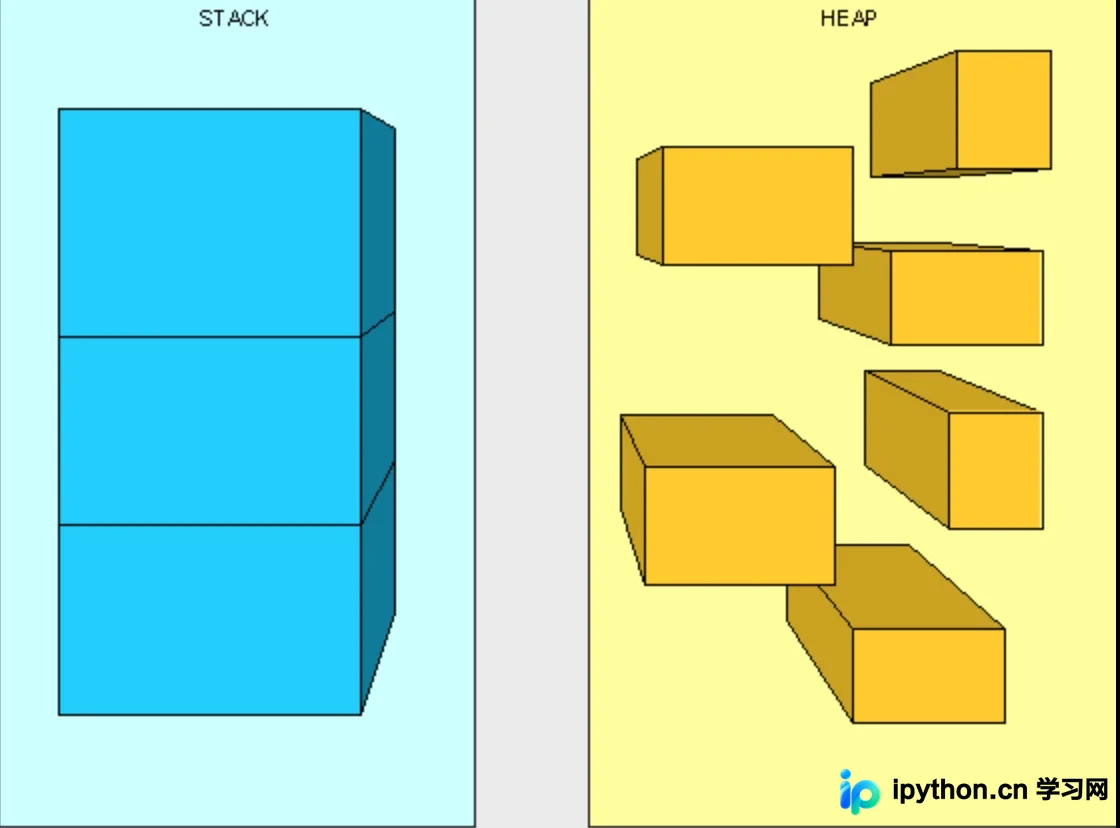
栈的分配与特点
1. 分配速度快
栈的操作仅涉及指针的移动(压栈和出栈),无需复杂的搜索算法,因此效率极高。例如以下代码中,obj在fun作用域内分配:
class Object {
public:
    Object() = default;
};
void fun() {
    Object obj; // 在栈上分配
    // do sth
} // obj在此处自动析构并释放
2. 分配方式
- 静态分配:由编译器完成。如
int a[10];,编译器在编译期直接计算占用字节数,运行时直接移动栈指针。 - 动态分配:由
alloca()函数实现。虽然名为动态,但其内存仍由编译器在函数返回时自动释放,无需开发者手动干预。
栈的配置与限制
每个线程拥有独立的栈空间,且大小受限。过大可能导致栈溢出或耗尽RAM。在Linux系统中,可通过命令查看和修改栈大小:
# 查看当前栈大小(单位KB)
ulimit -s
# 输出示例:10240 (即10MB)

# 临时修改栈大小为100MB
ulimit -s 102400

# 永久修改需编辑配置文件
/etc/security/limits.conf
堆(Heap)详解
堆是操作系统管理的一块较大内存区域,用于满足程序运行时的动态内存需求。由于进程对内存的申请和释放缺乏规律性,堆的管理变得复杂。通常由运行时库(如glibc)提供malloc/free接口,底层调用_sbrk_或_mmap_等系统调用。
堆的特点:
- 动态分配:仅在运行时根据需求申请,无固定大小上限(受限于物理内存RAM)。
- 跨线程访问:堆内存属于进程级别,任何线程均可访问该区域内的数据。
- 手动管理:必须由开发者显式调用
malloc/new申请,并调用free/delete释放,否则易导致内存泄漏。 - 产生碎片:频繁的不规则分配与释放会导致内存空间不连续,形成碎片,影响效率。
堆与栈的核心区别
理解两者的差异有助于在开发中做出更优的性能决策。以下是主要维度的对比:
- 空间大小:
- 堆:几乎无限制(32位系统可达4GB,64位更大),仅受物理内存约束。
- 栈:有严格限制(如Linux默认8MB~10MB),过小会导致栈溢出。
- 内存连续性:
- 堆:可能产生碎片,内存块不一定连续。
- 栈:始终连续,通过指针移动进行分配,无碎片问题。
- 增长方向:
- 堆:向高地址方向增长(向上)。
- 栈:向低地址方向增长(向下)。
- 分配效率:
- 栈:极快,仅需移动寄存器指针。
- 堆:较慢,涉及复杂的查找空闲区块逻辑。
- 生命周期:
- 栈:随函数作用域结束自动销毁,安全便捷。
- 堆:需手动释放,存在泄漏风险。
指针与内存布局实例
为了更好地理解指针在内存中的位置,观察以下代码:
#include <stdio.h>
#include <stdlib.h>
int main() {
    int a;          // 存储在栈上
    int *p;         // 指针本身存储在栈上
    p = (int *)malloc(sizeof(int)); // 指向堆上的内存
    free(p);
    return 0;
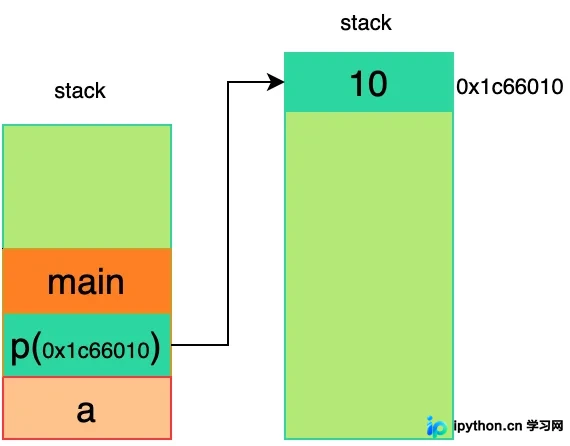
}在此例中,变量a和指针p均位于栈上,而p所指向的实际整型数据位于堆上。p的值即为堆内存的地址(如0x1c66010)。
开发建议总结
尽管栈存在大小限制且不支持多线程共享,但鉴于其极高的分配效率和自动管理的便利性,**在开发中应优先使用栈**。建议遵循以下原则:
- 能栈则栈:对于小型对象和局部变量,尽量使用栈分配,避免内存泄漏和碎片问题。
- 大对象用堆:当数据体积超过栈容量限制,或需要在不同函数/线程间共享时,再使用堆分配。
- 严格配对:若必须使用堆,务必确保
malloc与free成对出现,或使用智能指针管理所有权。
以上就是C语言指针与内存管理(堆与栈区别)的详细内容,更多关于C/C++底层优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









