


很多语言都在讲协程,但一旦脱离具体实现,概念很容易越说越虚。这篇文章换一个更直接的办法:不从语法糖讲起,而是用一个基于 aarch64 macOS 的 C 语言玩具实现,看看协程最底层到底在切换什么、保存什么。读完你至少能判断三件事:有栈协程和线程的边界在哪里,最小协程结构体该保存哪些寄存器状态,以及为什么这类代码会频繁撞上 ABI、栈和编译器优化带来的细节问题。
协程到底是什么
不同语言里的协程外观差异很大,但如果只抓住共性,可以先把它理解成一种“用户态控制的执行单元”。这篇文章讨论的是有栈协程,不涉及无栈协程。
从 CPU 的角度看,真正关键的东西其实不多:要执行的指令,以及执行时使用的栈。进程和线程之所以能被 CPU 来回切换,是因为操作系统负责调度,也负责切换对应的执行现场。
如果把这件事换到用户态来做,程序员自己准备栈,自己保存和恢复执行位置,再自己决定切到哪个执行单元,这就进入了协程的范畴。换句话说,协程的核心不是某个语言关键字,而是执行现场由用户代码管理。
一个协程最少要保存哪些状态
如果把协程当成一个 C 结构体来看,它至少要回答两个问题:
- CPU 接下来要执行哪段代码
- 这些代码要在哪个栈上执行
这也是本文示例里结构体设计的出发点。
在这个层面,开发已经不是面向 API 或系统调用,而是更接近面向 ABI 和寄存器。程序员不能直接命令 CPU 做什么,但可以通过指令去修改寄存器的值,从而改变 CPU 后续的执行行为。
例如:
ret会利用返回地址寄存器,间接决定下一条要执行的指令mov可以修改栈相关寄存器,让后续内存读写落到另一个栈上
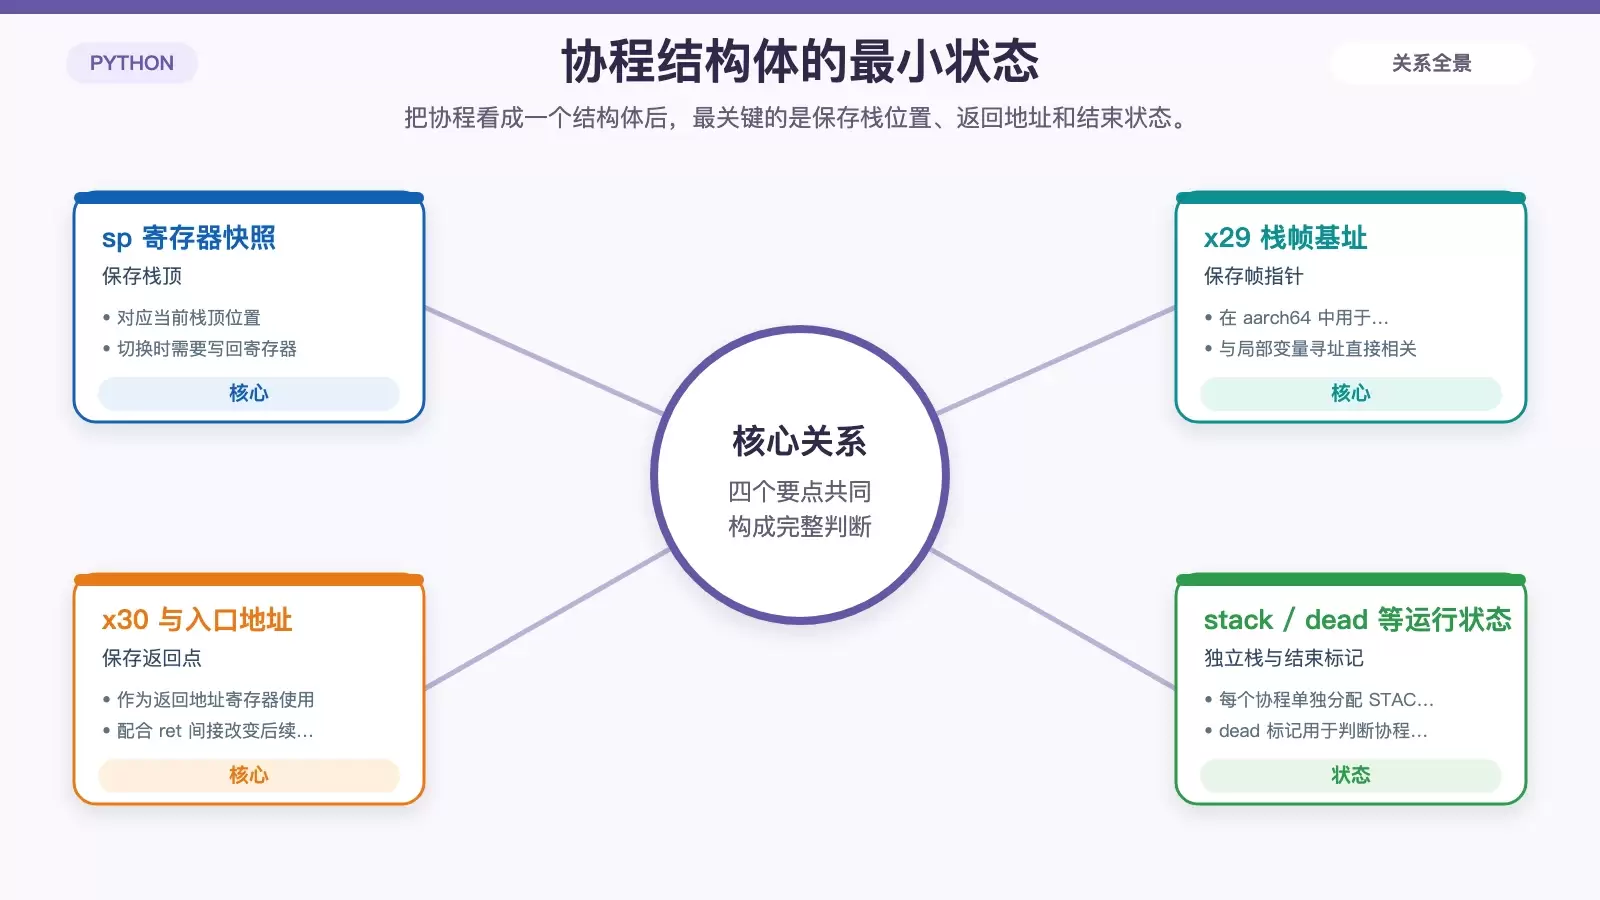
因此,一个最小的有栈协程,通常要保存:
- 栈顶位置
- 栈帧基址
- 返回地址或入口地址
- 协程自身的栈内存
- 执行完成标记
本文示例正是围绕这些状态展开。
示例里的协程结构体怎么设计
原始实现基于 aarch64 macOS,指令使用的是 ARM 指令,编译器使用系统自带的 gcc(clang)。下面这段代码保留了原文实现:
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#define STACK_SIZE 1024
typedef struct {
/** 栈顶寄存器 */
u_int64_t sp;
/** 栈底寄存器 */
u_int64_t x29;
/** 返回地址寄存器 */
u_int64_t x30;
/** 主协程结束,跳回main函数使用 */
u_int64_t endAddr;
u_int64_t endSp;
u_int64_t endX29;
u_int64_t endX30;
uint64_t entry;
u_int8_t* stack;
size_t size;
/** 标记协程是否执行完毕 */
int dead;
} Routine;
typedef void (*Entry)();
/** 记录当前执行的协程 */
Routine* current;
/** 模拟协程池 */
Routine queue[2];
Routine createRoutine(Entry entry) {
u_int8_t* stack = (u_int8_t*)malloc(STACK_SIZE);
if (stack == NULL) {
perror("Failed to allocate stack memory");
exit(EXIT_FAILURE);
}
Routine r;
uint64_t aligned_sp = (uint64_t)(stack + STACK_SIZE - 1) & ~0xF; // 16字节对齐
r.sp = aligned_sp;
r.x29 = aligned_sp;
r.entry = (uint64_t)entry;
r.x30 = (uint64_t)entry;
r.size = STACK_SIZE - 1;
r.dead = 0;
r.stack = stack;
return r;
}
void switchToRoutine(Routine* routine) {
__asm__ volatile(
"add %0, sp, #32\n\t"
"mov %1, x29\n\t"
"mov %2, x30\n\t"
: "=r"(current->sp), "=r"(current->x29), "=r"(current->x30)
:
: "memory"
);
current = routine;
__asm__ volatile(
"ldr x10, [%0]\n\t"
"mov sp, x10\n\t"
"ldr x29, [%1]\n\t"
"ldr x30, [%2]\n\t"
"ret\n\t"
:
: "r"(¤t->sp), "r"(¤t->x29), "r"(¤t->x30)
: "x10", "x30", "memory"
);
}
void queueOneDead() {
queue[1].dead = 1;
}
Routine* queueZero() {
return &queue[0];
}
Routine* queueOne() {
return &queue[1];
}
// 模拟用户给协程定义要执行的代码
void hello() {
printf("hello\n");
switchToRoutine(&queue[0]);
printf("world\n");
// 标记协程结束;
// 之所以放在一个函数中完成,是因为编译器会优化代码,
// 将 queue[1] 写入栈中,当写入queue[1]时,并不会
// 更新全局作用域的queue[1], 而是更新栈上的内容;
// 这会调至 switchToRoutine 跳转到另一个协程时,
// 出现问题。
queueOneDead();
switchToRoutine(queueZero());
}
void mainRoutineEntry() {
while(1) {
printf("enter main routine\n");
// 模拟调度逻辑
// 模拟结束调度的条件,目前我们是一个协程,
// 如果多个协程,改用循环语句判断
if (queue[1].dead == 1) {
printf("yes\n");
Routine* a = queueZero();
__asm__ volatile(
"mov sp, %0\n\t"
"mov x29, %1\n\t"
"mov x30, %2\n\t"
"ret\n\t"
:
: "r"(a->endSp), "r"(a->endX29), "r"(a->endX30)
);
} else {
// 模拟选中下一个协程,切换过去
switchToRoutine(&queue[1]);
}
}
};
void execute() {
__asm__ volatile(
"add sp, sp, #16\n\t"
"mov x10, sp\n\t"
"str x10, [%0]\n\t"
"str x29, [%1]\n\t"
"str x30, [%2]\n\t"
"ldr x10, [%3]\n\t"
"mov sp, x10\n\t"
"ldr x29, [%4]\n\t"
"ldr x30, [%5]\n\t"
"ret\n\t"
:
: "r"(&queue[0].endSp), "r"(&queue[0].endX29), "r"(&queue[0].endX30), "r"(&queue[0].sp), "r"(&queue[0].x29), "r"(&queue[0].x30)
: "x10", "x30", "memory"
);
}
int main() {
Routine routine = createRoutine(hello);
Routine Main = createRoutine(mainRoutineEntry);
queue[0] = Main;
queue[1] = routine;
current = &queue[0];
execute();
printf("ok, that's right\n");
free((void *)(routine.stack));
free((void*)(Main.stack));
printf("wow\n");
return 0;
}
这段结构体和初始化逻辑里,有几个点尤其关键:
1. 保存栈和返回位置
示例把 sp、x29、x30 都放进了 Routine。这三者分别对应当前栈顶、栈帧基址和返回地址,是恢复执行现场的核心。
2. 每个协程都要有独立栈
createRoutine 里通过 malloc(STACK_SIZE) 分配栈空间,并把栈顶按 16 字节对齐:
uint64_t aligned_sp = (uint64_t)(stack + STACK_SIZE - 1) & ~0xF; // 16字节对齐这个细节和 ABI 有直接关系。如果栈没有按要求对齐,后续执行 C 函数或汇编切换时就可能出现异常行为。
3. 主协程还要保存“返回 main”所需状态
除了正常切换用的 sp、x29、x30,示例还额外准备了 endSp、endX29、endX30。它们的用途很明确:当所有普通协程执行完后,把执行流切回 main,再做资源释放和程序收尾。
协程切换到底在切什么
这套玩具实现的核心,不在“并发”,而在执行现场切换。所谓调度,放到这里其实很朴素:从队列里选出一个协程,把 CPU 当前寄存器保存下来,再把目标协程之前保存的寄存器恢复回去。
在 aarch64 体系里,文中重点提到:
x29负责栈帧基址sp负责栈顶x30负责返回地址
而 bl 指令的作用,是跳转到某个函数,同时把下一条指令地址写入 x30。等函数执行到结尾,ret 会把 x30 的值写回到 PC,于是函数就“返回”了。
这也是示例为什么能通过改写 x30 来间接控制后续执行位置。直接去改 PC 不现实,但利用调用约定中的返回机制,可以达到类似效果。
switchToRoutine 做的事情,可以概括为两步:
- 把当前协程的
sp、x29、x30保存到结构体里 - 从目标协程结构体里取出对应值,写回寄存器,再通过
ret跳转
因此,切换协程本质上不是“调用另一个函数”,而是恢复另一个执行现场。
这份示例代码的整体执行流程
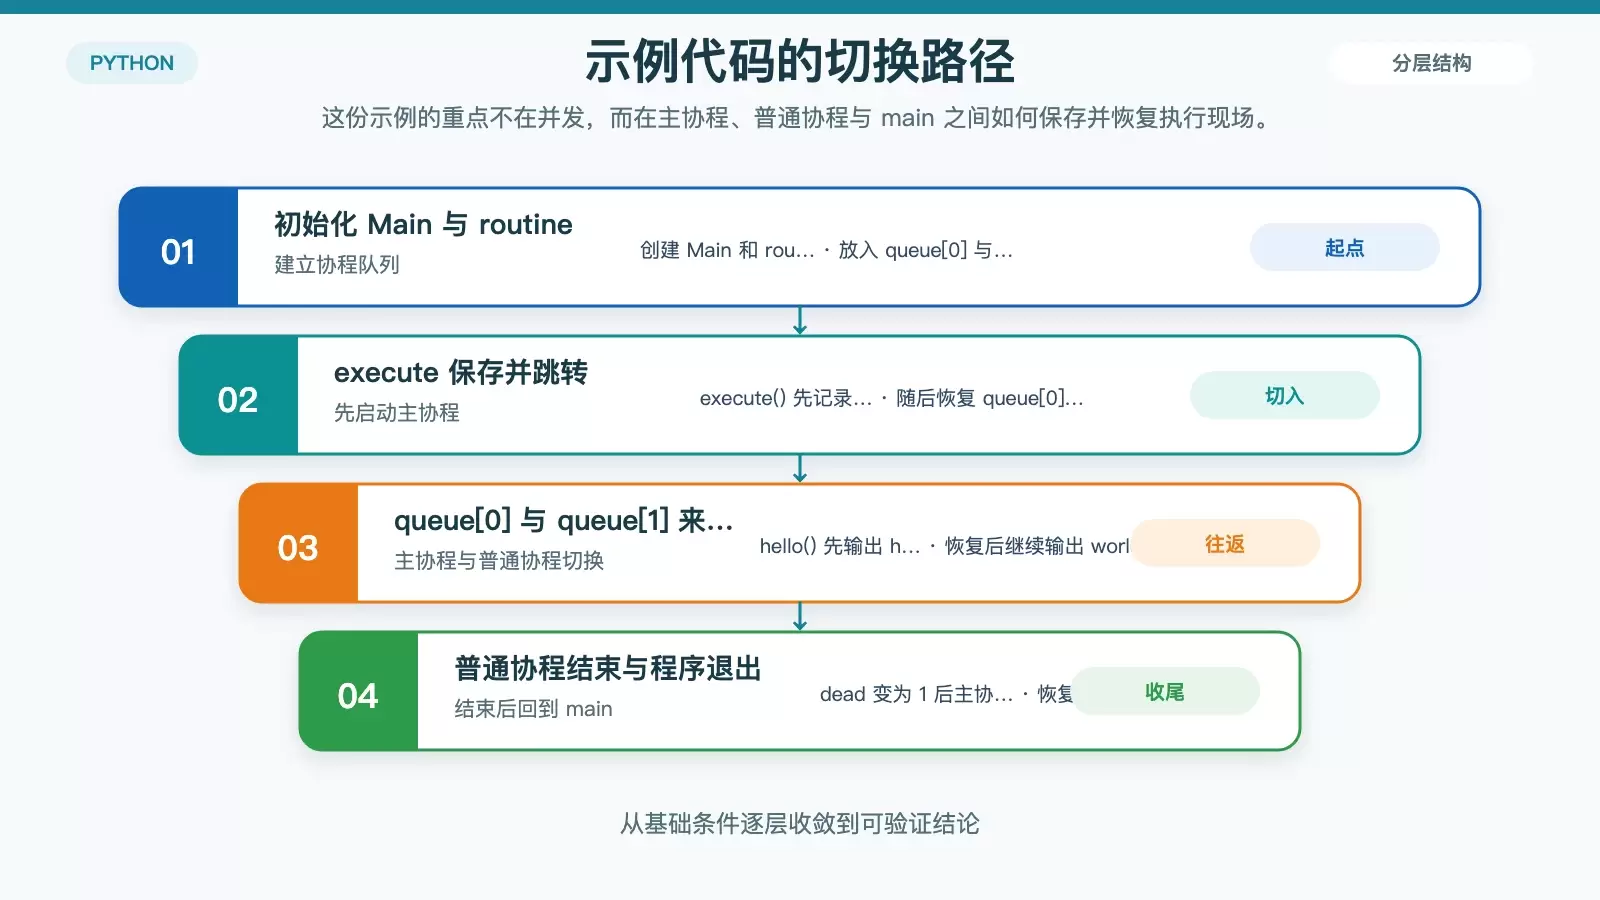
原文对整体思路做了概括,整理后可以更清楚地看成下面 4 步:
- 先创建主协程
Main和普通协程routine,并存入queue。协程入口函数在 C 里本质上就是函数地址,因此可以用uint64_t保存,并在后续恢复到x30中。 - 调用
execute(),先启动主协程。同时把execute后续返回所需的寄存器状态记录下来,方便所有协程结束后切回main。 - 主协程和普通协程之间来回切换执行。示例里的
hello()会先输出hello,切回主协程,再继续输出world。 - 当普通协程标记为结束后,主协程恢复到
main的上下文,释放栈内存,程序退出。
如果你的电脑也是 aarch64 macOS,可以直接按原文方式编译运行:
gcc main.c -o main

# 如果上面的代码无法执行起来,或者执行报错,可以尝试这种方式
gcc main.c -O1 -o main
原作者还给出了完整版说明,包含这份代码的缺陷、改进版本,以及使用 lldb 调试时常见指令:https://zhangzhuang15.github.io/blog/coroutine.html
为什么这种玩具实现很容易出问题
这类代码最容易踩坑的地方,恰恰也是它最有学习价值的地方:你会非常直接地碰到 ABI、编译器优化和内存访问规则。
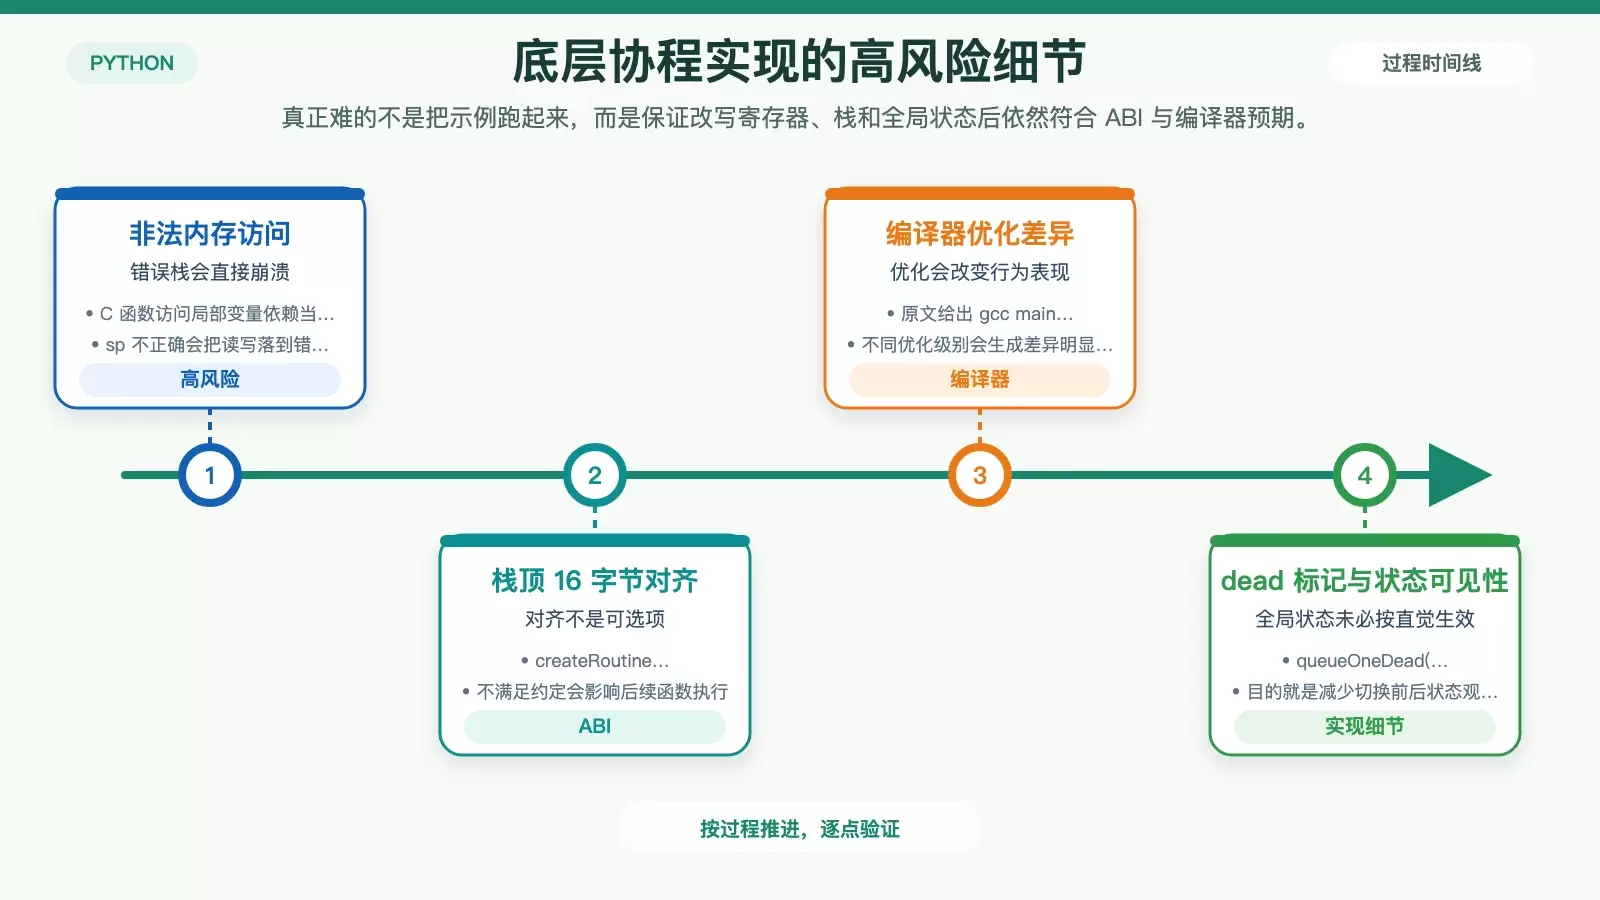
原文提到,最突出的一个问题是非法内存访问。原因并不神秘:
内联汇编会直接修改 sp,而像 hello() 这样的 C 函数,在访问局部变量时本来就依赖当前 sp 进行寻址。如果 sp 被改到了不正确的位置,后续局部变量读写就可能落到错误内存区域,结果就是崩溃或行为异常。
另一个细节是编译器优化。原文专门把 queue[1].dead = 1 包进 queueOneDead() 函数中,理由是编译器可能会把某些写操作保留在当前栈帧或寄存器视角下,导致切换协程后观察到的全局状态不符合预期。也正因为如此,原文在编译时额外给出了 -O1 的尝试方式。
所以,这份代码更适合作为“理解协程底层切换”的样本,而不是生产环境方案。它展示的不是完整工程能力,而是最核心也最危险的那一层:只要你自己接管栈和返回地址,就必须自己承担现场保存恢复的全部正确性。
怎么理解这个实验的价值
如果只看高级语言里的 async、await 或生成器,协程常常像一个语言特性;但把它拆到 C 和汇编层,你会更容易看清本质:协程首先是执行流管理问题,其次才是语法设计问题。
这份 aarch64 macOS 上的玩具实现虽然粗糙,却把几个关键事实讲得很直白:
- 有栈协程要自己准备栈
- 切换协程本质是切换寄存器和返回位置
- 调度就是选择下一个要恢复的执行现场
- 一旦进入这层实现,ABI 与编译器细节都会立刻变成实际问题
对于想把“协程”这个词真正落到机器执行层的人来说,这种自己动手做一个最小版本的过程,比单纯看概念定义更有效。









