

一条SQL的执行过程:详解MySQL架构设计与InnoDB核心原理

很多开发者对MySQL的了解仅停留在增删改查层面,认为SQL处理是一个黑盒。实际上,MySQL拥有清晰的三层逻辑架构。本文以一条标准的更新语句为线索,详细拆解从网络连接、SQL解析优化到InnoDB存储引擎内部组件协作的完整流程,重点解析Buffer Pool管理策略与事务日志(Binlog、Redo Log、Undo Log)的一致性保证机制。
1 MySQL整体架构概览
MySQL的逻辑架构主要划分为三层:应用层(连接器等)、服务层(SQL接口、解析器、优化器、执行器)以及存储引擎层。其中,插件式的存储引擎是MySQL区别于其他关系型数据库的核心特性。为了直观理解,我们假设执行以下SQL:
update users set name='zhangsan' where id = 10在Java服务端开发中,这条语句意味着通过驱动连接数据库,定位主键为10的记录并修改Name字段。下面我们将沿这一路径,层层剖析MySQL内部的处理细节。
2 应用层与连接管理
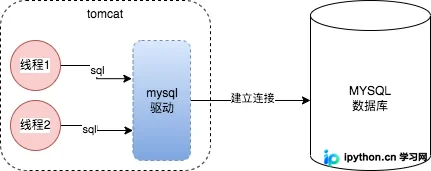
SQL执行的起点是客户端与数据库的网络连接。由于高并发场景下频繁建立TCP连接会消耗大量资源,现代应用通常采用连接池技术来复用连接。
第1步:建立连接与鉴权
程序通过JDBC驱动程序发起请求,MySQL服务端由专门的监听线程负责接收连接。建立连接时,服务器会进行双重校验:
1. **身份鉴权**:验证用户名、密码及客户端IP地址。
2. **权限检查**:确认该用户是否具备执行特定SQL的操作权限。
连接池的存在确保了这种“昂贵”的连接操作只发生一次或极少次数,后续请求直接复用已有连接句柄。
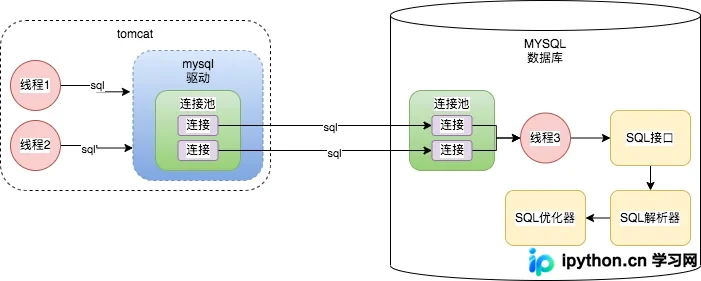
下图展示了连接建立的交互模型:
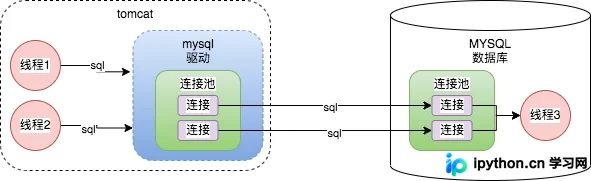
第2步:请求分发
连接建立后,多个并发请求被接入。MySQL内部使用固定数量的线程来处理这些请求(每个连接一个线程),避免了动态创建线程带来的系统开销。
3 服务层处理流程
一旦MySQL收到SQL文本,服务层便接手进行复杂的逻辑处理。这一过程并非直接执行,而是经过多道工序。
第3步:SQL接口与解析
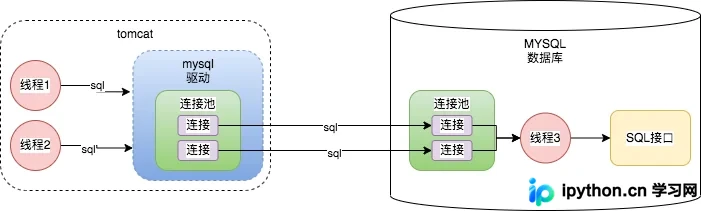
MySQL接收到SQL后,首先通过SQL接口进行预处理。随后进入SQL解析器阶段,将SQL文本转换为词法分析和语法分析结果,最终生成AST(抽象语法树)。
对于上述更新语句,解析器将其拆解为结构化的语义单元:
- 目标对象:users表
- 过滤条件:id = 10
- 更新动作:set name='zhangsan'
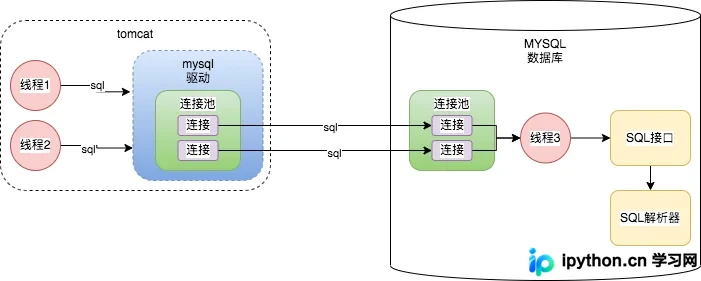
此时,MySQL已完全理解了SQL意图,并将其转化为机器可操作的语法树结构。
第4步:查询优化
在明确意图后,MySQL面临多种实现路径的选择。例如,可以通过主键索引直接定位,也可以通过其他辅助索引遍历。这一阶段由SQL优化器完成,它基于成本估算模型(Cost-Based Optimizer),选择执行代价最低的执行计划。
通常情况下,通过主键id=10定位是最优路径。优化器输出的执行计划将被传递给执行器。
第5步:执行控制
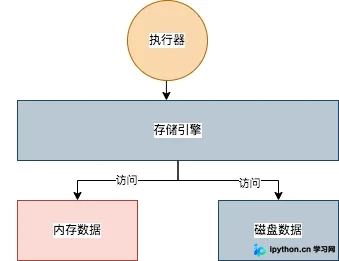
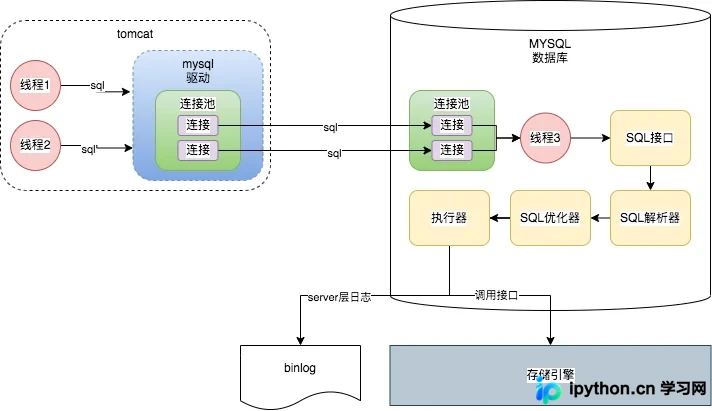
执行器根据执行计划调用存储引擎的接口。
注意:在此过程中,MySQL还会开启全局查询缓存(Query Cache)。但需要注意的是,由于全字匹配要求严格且任何表的更新都会导致相关缓存失效,MySQL 5.7开始默认关闭此功能,8.0版本已彻底移除。
同时,执行器会将本次操作生成的二进制日志(Binlog)写入磁盘。需要区分的是,Binlog属于Server层日志(逻辑日志),而后续讨论的Redo/Undo属于存储引擎层日志。
4 存储引擎层:InnoDB核心机制
执行器向InnoDB发出请求,要求其完成数据的实际读写。这是MySQL性能优化的关键所在,核心组件包括Buffer Pool和日志系统。
第6步:缓冲池(Buffer Pool)操作
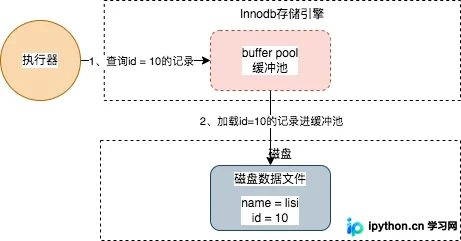
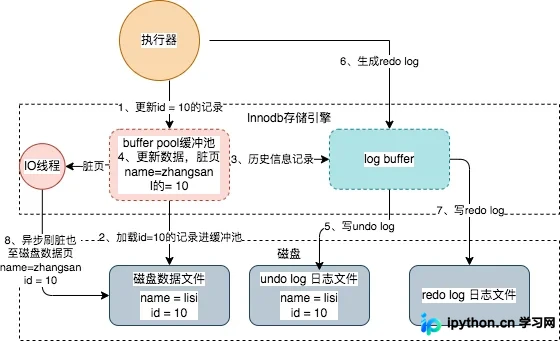
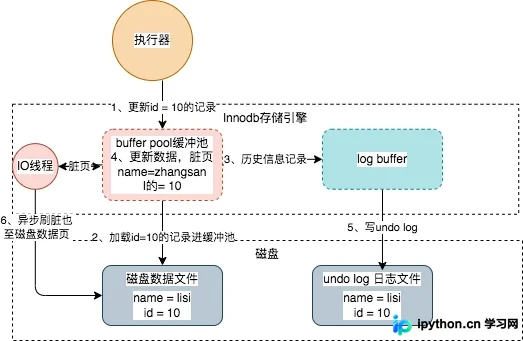
InnoDB读取数据不是直接访问磁盘,而是先在内存中的Buffer Pool查找。如果命中(即数据已在内存),则直接返回;未命中则需从磁盘读取。
4.2.1 数据页与脏页
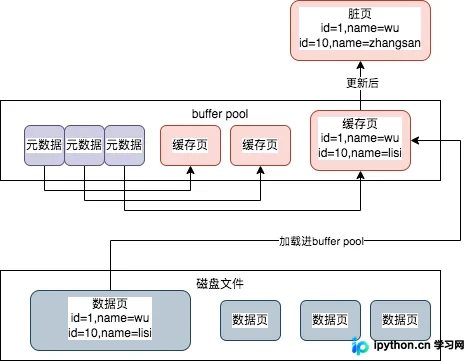
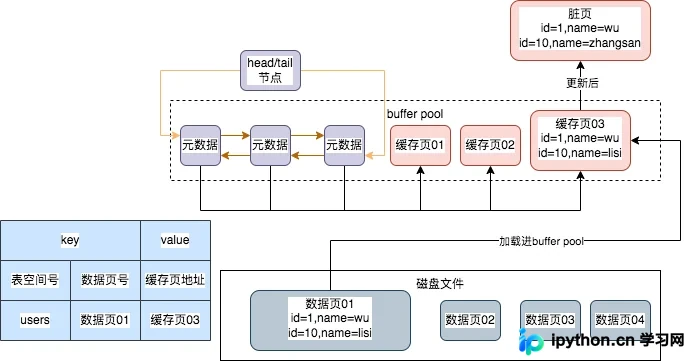
为了管理效率,InnoDB将磁盘数据划分为固定大小的数据页(默认16KB)。当数据页加载到内存后成为缓存页。如果对该缓存页进行了修改但尚未落盘,它被称为脏页。
4.2.2 Buffer Pool的内部链表管理
Buffer Pool包含多个数据结构来维持高效运作:
- Hash表:通过(表空间ID + 页号)快速定位数据页是否存在于内存中。
- Free链表:管理空闲的缓存页元数据。数据页未刷盘前不能使用,只能从Free链表获取空闲块。
- Flush链表:专管脏页。后台I/O线程定期将Flush链表中的脏页异步刷回磁盘,完成后从该链表中移除并加入Free链表。
4.2.3 LRU算法与冷热分离
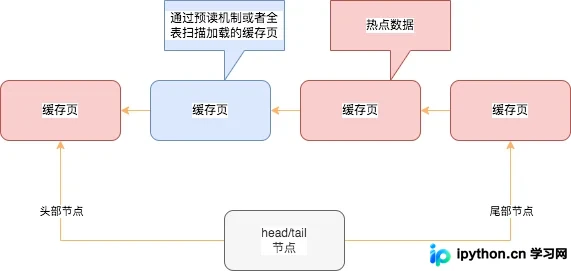
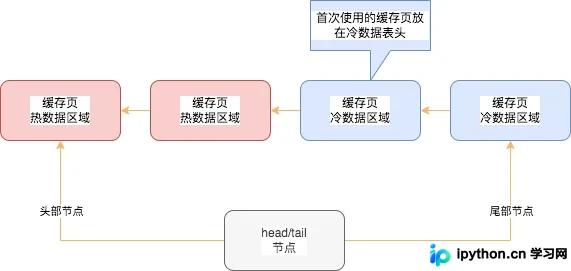
InnoDB使用LRU(最近最少使用)策略管理内存淘汰。原始LRP有一个缺陷:全表扫描会将大量冷门数据带入头部,挤占热点数据空间。
改进方案:LRU Splitting(冷热分离)
MySQL将LRU链表分为新生区和活跃区:
- 冷数据转热:数据第一次加载进入“新生区”。如果在1秒内再次被访问,则认为它是热点数据,会被移动到“活跃区”。
- 热数据处理:只有访问位于活跃区后3/4位置的数据时,才将其移至头部。这减少了频繁移动的开销,保护了真正的热点数据。
第7步:日志系统确保事务安全
数据在Buffer Pool中修改为脏页后,如何保证崩溃不丢数据?InnoDB引入了双写与WAL(Write-Ahead Logging)机制,核心涉及Undo Log和Redo Log。
4.3 Undo Log:支持回滚与MVCC
在执行更新前,InnoDB会将旧数据记录到Undo Log中(逻辑逆向操作)。这提供了两个核心价值:
- 事务回滚:若事务失败或手动回滚,可通过Undo Log恢复数据原状。
- MVCC(多版本并发控制):提供非阻塞读,提高系统并发能力。
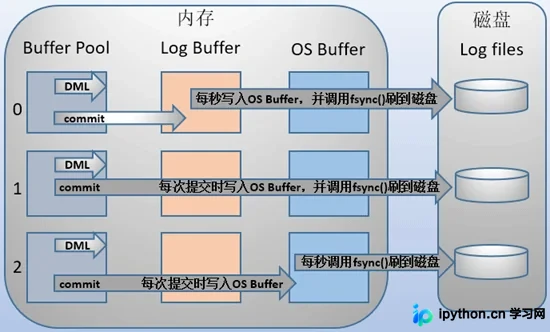
4.4 Redo Log:保证持久性与崩溃恢复
相比随机IO的Buffer Pool刷盘,Redo Log是顺序追加写的文件,性能极高。其工作流程如下:
- 数据在内存修改,生成Redo Log。
- Redo Log先写入缓存(Log Buffer),再刷入磁盘文件。
- 若宕机重启,MySQL会根据Redo Log重放已提交的事务记录,将内存状态恢复到一致点。
5 Binlog与Redo Log的两阶段提交
MySQL的事务一致性依赖于两个不同的日志文件:作为逻辑日志的Binlog(Server层)和作为物理日志的Redo Log(InnoDB层)。为保证两者原子性,采用了两阶段提交(Two-Phase Commit)协议。
第8步:两阶段提交流程
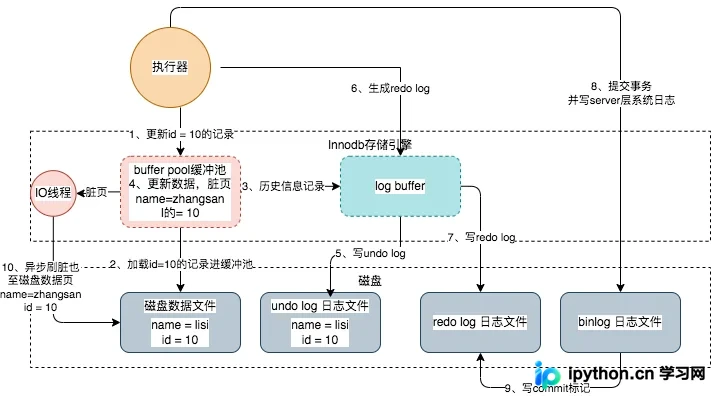
具体步骤简述如下:
- InnoDB执行更新,生成Redo Log并写入Log Buffer,标记为Prepare(准备)状态。
- InnoDB通知执行器,将对应的Binlog写入磁盘。
- Binlog写成功后,InnoDB将Redo Log状态变更为Commit(提交)并刷盘。
异常情况分析:
- 情况一(Redo未写完Commit):崩溃恢复时检测到未提交的记录,视为未完成事务,不执行回滚或重放,保证数据一致性。
- 情况二(Binlog缺失但Redo有Commit):可能导致主从复制不一致。但在主库内部,数据已是持久的。可通过主从校验工具修复。
6 总结
通过分析一条Update语句的执行链路,我们看到了MySQL精密协作的架构:从连接层的复用优化,到解析层的语法树构建,再到执行层的成本控制。而在内核层面,Buffer Pool的冷热分离LRU策略极大提升了内存命中率,结合Undo Log(用于回滚/MVCC)与Redo Log(用于崩溃恢复)的顺序IO优势,使得MySQL在处理高并发事务时兼具高性能与高可靠性。理解这些底层原理,有助于在实际开发中进行更合理的索引设计和SQL调优。
以上就是通过一条SQL详解MYSQL架构设计详情的详细内容,更多关于MYSQL架构设计与事务原理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









