

深入解析C语言数据存储:补码、字节序与整形提升

C语言中的数据在内存中并非直接以人类可读的形式存在,而是遵循特定的二进制编码规则。理解数据的存储方式对于掌握底层原理至关重要,本文系统梳理了数据类型分类、补码运算、大小端模式差异,以及在实际开发中常见的字符类型截断、整形提升与溢出问题。
数据类型体系与存储意义
C语言的数据类型决定了数据在内存中占据的空间大小以及编译器解读数据的方式。主要分为以下几大家族:
第1步:识别整形家族
整型是日常开发中最常用的类型,根据是否有符号和占用位数细分:
- char:内存中存储的是ASCII码值,本质上是一个整数。分为
signed char(默认)和unsigned char。 - short:分为
signed short和unsigned short,其中signed unsigned int中的int可省略。 - int:标准整型,同样包含有符号
signed int和无符号unsigned int。 - long:长整型,支持
signed long和unsigned long。
第2步:区分浮点型与指针类型
- 浮点型:包括
float和double,用于表示小数,其存储遵循IEEE 754标准,与整型的补码存储机制不同。 - 指针类型:如
int*,char*,void*等。指针的本质是地址,但其类型决定了操作行为。
第3步:理解空类型 void
void 表示“无类型”或“空类型”。它通常不定义变量,而是广泛应用于函数返回类型、参数列表(表示无参数)以及通用指针(void*),用于强调数据的不确定性或占位。
类型的核心意义在于两点:1. 确定内存分配大小;2. 决定数据解析视角(即相同的内存比特流,被解释为有符号数还是无符号数,结果截然不同)。
数据的底层存储机制:原码、反码与补码
计算机内部所有数值运算均基于补码进行。理解这一转换过程是分析内存数据的基础。
第4步:掌握有符号整数的三种表示法
有符号整数由符号位(0为正,1为负)和数值位组成。三种表示方法的转换规则如下:
- 原码:直接将数值转换为二进制,最高位为符号位。
- 反码:正数的反码同原码;负数的反码是符号位不变,其余各位按位取反。
- 补码:正数的补码同原码;负数的补码是反码加1。
计算机中只存储补码。这是因为补码可以将减法运算转化为加法运算,简化了CPU运算器的设计。
// 以 int a = 20 为例(正数,原=反=补)
// 原码:00000000 00000000 00000000 00010100
// 反码:00000000 00000000 00000000 00010100
// 补码:00000000 00000000 00000000 00010100

// 以 int a = -1 为例(负数,需经过复杂转换)
// 原码:10000000 00000000 00000000 00000001 (注意:原文草稿此处笔误写成了-2的原码,标准-1原码应为...01)
// 反码:11111111 11111111 11111111 11111110
// 补码:11111111 11111111 11111111 11111111
内存视图:大端与小端字节序
当数据宽度超过1个字节时,就需要考虑多字节的存储顺序,这被称为字节序。
第5步:判断系统的字节序
大端模式(Big-Endian):数据的高位字节存放在低地址处,低位字节存放在高地址处。符合人类的阅读习惯。
小端模式(Little-Endian):数据的低位字节存放在低地址处,高位字节存放在高地址处。现代x86架构多为小端模式。
可以通过强制类型转换来检测当前机器的存储模式。将指向整型变量的指针强转为指向单字节(char*)的指针,读取第一个字节的值即可判断:
int check_sys()
{
    int a = 1;
    // 创建值为1的整型,内存中低位为01,高位为00
    char* p = (char*)&a;
    // 强制转为char*,只访问起始的低地址字节
    return *p;
}
int main()
{
    int ret = check_sys();
    if(ret == 1)
        printf("小端\n");
    else
        printf("大端\n");
    return 0;
}
此代码利用 char* 每次只访问一个字节的行为,探测了 a 最低有效字节是否存储在最低地址。若输出1,则为小端;若输出0,则为大端。
第6步:理解指针类型的运算含义
指针不仅仅是一个地址,其类型赋予了内存访问的语义:
- 解引用范围:
int*解引用访问4个字节,而char*仅访问1个字节。 - 步进长度:
p + 1时,char*跳过1字节,int*跳过4字节,double*跳过8字节。
实战应用:截断、整形提升与溢出陷阱
在实际编码中,类型之间的赋值常引发隐式转换,导致难以察觉的Bug。
第7步:字符类型的截断与输出
当较大的类型赋值给较小的类型时,会发生截断(保留低位字节)。当使用 %d 打印字符时,会发生整形提升。
char a = -1;       // 截断后内存存 11111111
char b = -1;       // 同上
unsigned char c = -1; // 截断后内存存 11111111
printf("%d %d %d\n", a, b, c);
// 输出:-1 -1 255
原理分析:
- a 和 b:类型为
signed char,最高位是符号位(1,表示负数)。整形提升时,符号位扩展,高位补1,结果仍为 -1。 - c:类型为
unsigned char,最高位被视为数值位。整形提升时,高位补0,结果为 11111111 (二进制) = 255 (十进制)。
第8步:极端值的截断测试
观察 -128 的输出:
char a = -128;
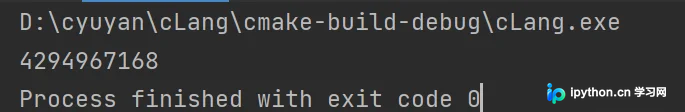
printf("%u\n", a); // 输出为 4294967168 (即补码的全1形式转无符号)
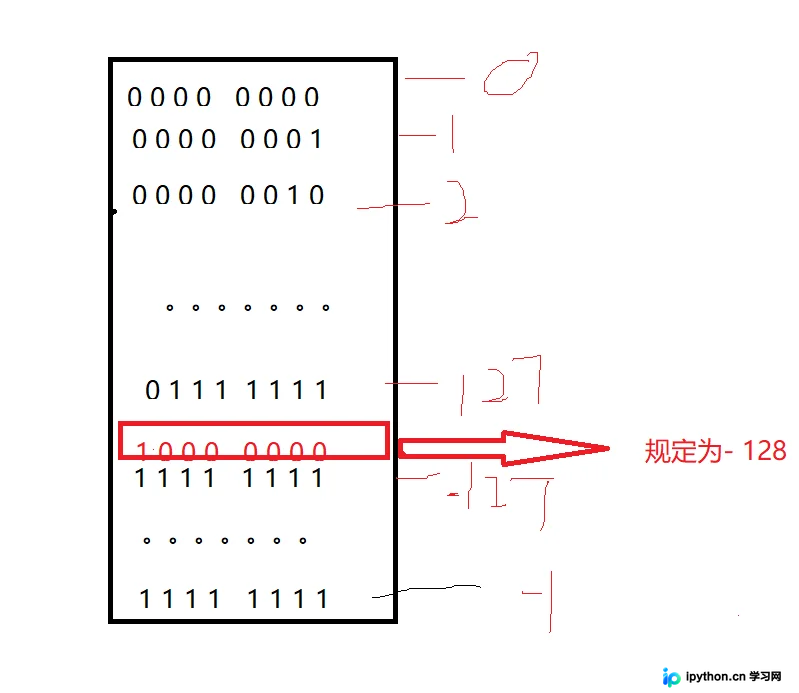
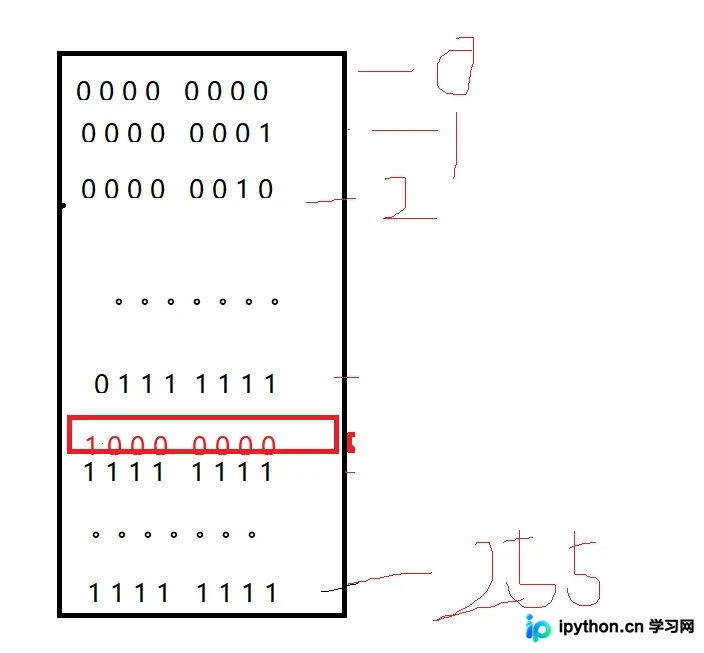
-128 的补码为 10000000。赋给 char 后未变化。使用 %u 打印时,发生整形提升变为 11111111 11111111 11111111 10000000。作为无符号数解释,这是一个极大的正整数。
典型例题与误区排查
第9步:strlen 与字符遍历
strlen 遇到 '\0' 结束。在有符号 char 数组中,当遍历填充特定数值时,必须预判何时会生成 '\0'。
char a[1000];
int i;
for(i=0; i<1000; i++)
{
    a[i] = -1 - i;
}
printf("%d\n", strlen(a));
推导过程:
i=0时,a[0] = -1。- 随着
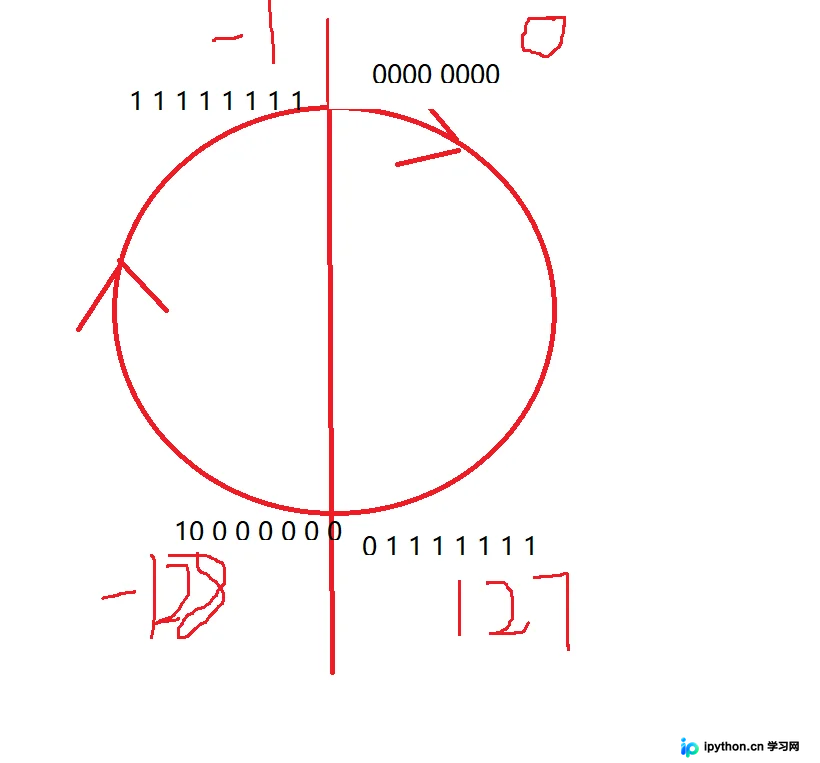
i增加,a[i]的值依次为 -1, -2, ..., -128, 127, 126, ..., 1, 0。 - 从 -1 到 -128 需要 128 个数(下标 0 ~ 127)。
- 从 -127 回到 127 再到 0,是一个完整的周期,共 255 个非零值。
- 最终
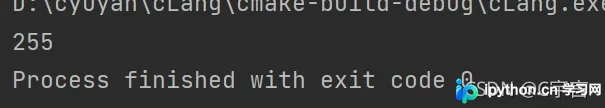
a[255]为 0,触发停止条件。因此长度为 255。
第10步:无符号char的死循环陷阱
这是一个经典的面试考点:
unsigned char i = 0;
for(i=0;i!=255;i++)
{
   printf("hello\n");
}
结果:程序陷入死循环。
原因: unsigned char 的范围是 0 ~ 255。当 i 增加到 255 时,再执行 i++,由于无符号回绕(Wrap-around),i 会变成 0。因为 0 != 255 依然成立,循环永远不会退出。
总结
理解C语言中数据的存储不仅仅是背诵概念,更需要掌握二进制转换的逻辑。从原反补码的转换,到大端小端的差异,再到因类型截断引发的整形提升和溢出异常,这些底层细节构成了C语言高效但也充满挑战的特质。在实际编程中,特别是处理嵌入式或底层数据交互时,务必关注变量的符号属性(signed/unsigned)和内存对齐情况,以避免隐蔽的逻辑错误。
以上就是C语言数据存储与类型转换的详细解析,更多关于C语言进阶优化的技巧请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









