

Python机器学习实战:线性判别分析(LDA)分类模型详解与代码实现

本文深入解析Python中线性判别分析(LDA)的分类应用。对比LDA与PCA在监督与无监督降维上的差异,阐述其“类内方差最小、类间方差最大”的核心思想。通过完整代码演示LDA在合成数据及MNIST手写数字数据集上的训练、预测与评估流程,涵盖模型构建、可视化及混淆矩阵分析,帮助开发者掌握LDA在模式识别中的实际落地方法。
一、引言
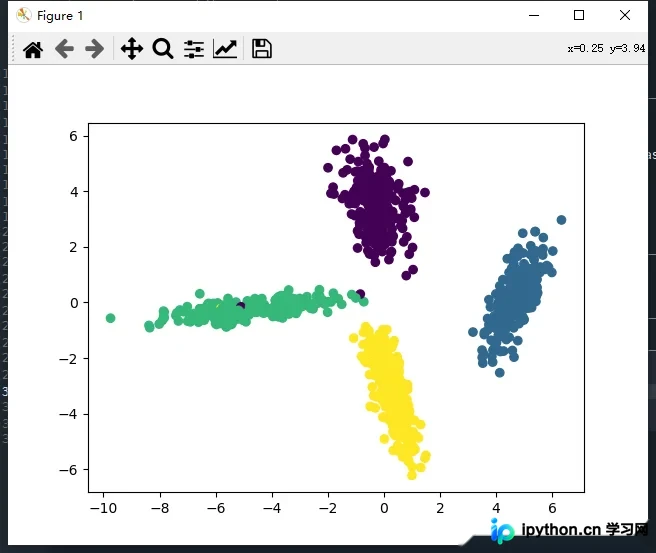
线性判别分析(LDA)在模式识别领域,尤其是人脸识别等图像识别场景中应用广泛。作为一种监督学习下的降维技术,LDA要求数据集的每个样本具备类别标签,这与不考虑类别输出的无监督降维技术PCA存在本质区别。LDA的核心思想可概括为“投影后类内方差最小,类间方差最大”。具体而言,我们将数据投影至低维空间,旨在使同一类别数据的投影点尽可能聚集,同时不同类别的中心间距最大化。最终目标是实现投影后数据按类别自然分簇,同类点距离更近。
1. LDA的优势
- 在降维过程中,LDA能够利用类别的先验知识,而PCA等无监督方法无法使用此类信息;
- 当样本分类信息主要依赖均值而非方差时,LDA的表现通常优于PCA等算法。
2. LDA的局限性
- LDA不适用于非高斯分布样本的降维,PCA同样面临此问题;
- LDA降维后的最大维度为类别数 k 减 1(即 k-1)。若需降维至大于 k-1 的维度,则无法直接使用LDA。尽管目前存在LDA的改进算法可解决此限制,但标准LDA受此约束;
- 当样本分类信息主要依赖方差而非均值时,LDA的降维效果不佳;
- LDA模型可能存在对数据过拟合的风险。
3. 模式识别与自然语言处理中LDA的区别
在自然语言处理(NLP)领域,LDA指隐含狄利克雷分布(Latent Dirichlet Allocation),是一种用于文档主题建模的方法。本文讨论的线性判别分析(LDA)除用于降维外,更常用于分类任务。其基本思想是假设各类样本数据符合高斯分布。通过LDA投影后,利用极大似然估计计算各类别投影数据的均值和方差,进而构建该类别的高斯分布概率密度函数。当新样本到来时,将其投影并代入各类别的概率密度函数,计算属于该类别的概率,概率最大的类别即为预测结果。
二、演示环境
#%%导入基本库
# 基础数组运算库导入
import numpy as np
# 画图库导入
import matplotlib.pyplot as plt
# 导入三维显示工具
from mpl_toolkits.mplot3d import Axes3D
# 导入LDA模型
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
# 导入demo数据制作方法
from sklearn.datasets import make_classification
#%%模型训练
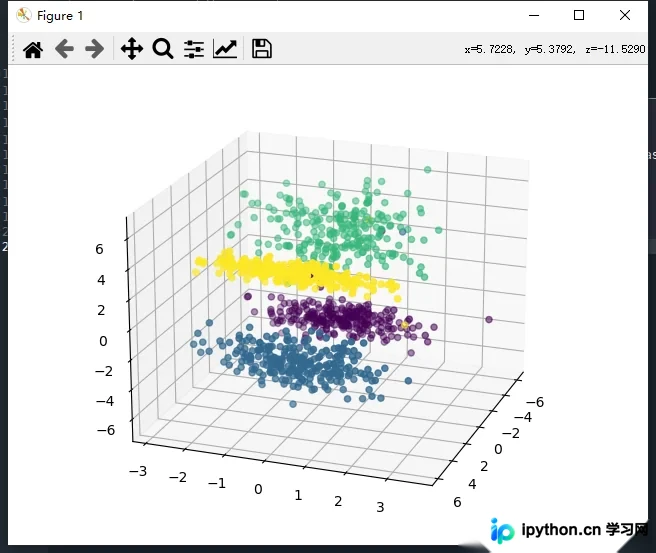
# 制作四个类别的数据,每个类别100个样本
X, y = make_classification(n_samples=1000, n_features=3, n_redundant=0,
                           n_classes=4, n_informative=2, n_clusters_per_class=1,
                           class_sep=3, random_state=10)
# 将四个类别的数据进行三维显示
fig = plt.figure()
ax = Axes3D(fig, rect=[0, 0, 1, 1], elev=20, azim=20)
ax.scatter(X[:, 0], X[:, 1], X[:, 2], marker='o', c=y)
plt.show()
#%%建立 LDA 模型
lda = LinearDiscriminantAnalysis()
# 进行模型训练
lda.fit(X, y)
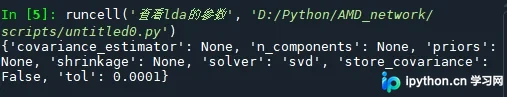
#%%查看lda的参数
print(lda.get_params())
#%%数据可视化
#模型预测
X_new = lda.transform(X)
# 可视化预测数据
plt.scatter(X_new[:, 0], X_new[:, 1], marker='o', c=y)
plt.show()
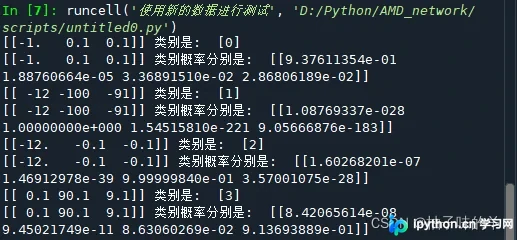
#%%使用新的数据进行测试
a = np.array([[-1, 0.1, 0.1]])
print(f"{a} 类别是: ", lda.predict(a))
print(f"{a} 类别概率分别是: ", lda.predict_proba(a))

a = np.array([[-12, -100, -91]])
print(f"{a} 类别是: ", lda.predict(a))
print(f"{a} 类别概率分别是: ", lda.predict_proba(a))

a = np.array([[-12, -0.1, -0.1]])
print(f"{a} 类别是: ", lda.predict(a))
print(f"{a} 类别概率分别是: ", lda.predict_proba(a))

a = np.array([[0.1, 90.1, 9.1]])
print(f"{a} 类别是: ", lda.predict(a))
print(f"{a} 类别概率分别是: ", lda.predict_proba(a))
三、基于LDA的手写数字分类实战
#%%导入库函数
# 导入手写数据集 MNIST
from sklearn.datasets import load_digits
# 导入训练集分割方法
from sklearn.model_selection import train_test_split
# 导入LDA模型
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
# 导入预测指标计算函数和混淆矩阵计算函数
from sklearn.metrics import classification_report, confusion_matrix
# 导入绘图包
import seaborn as sns
import matplotlib
import matplotlib.pyplot as plt
#%% 导入MNIST数据集
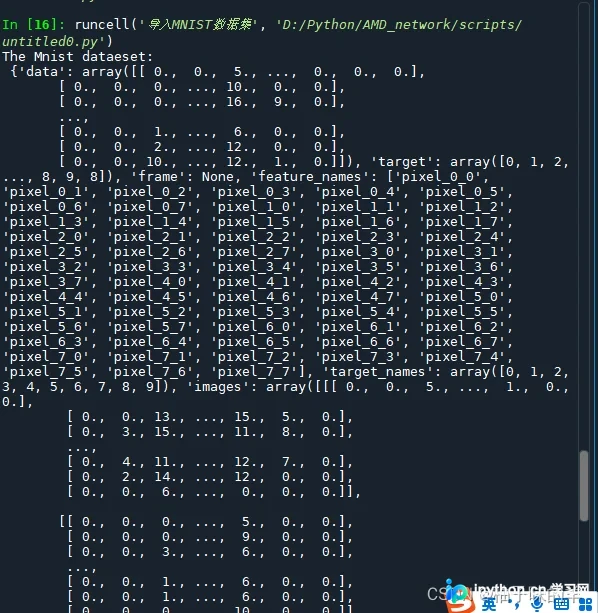
mnist = load_digits()
# 查看数据集信息
print('The Mnist dataeset:\n',mnist)

# 分割数据为训练集和测试集
x, test_x, y, test_y = train_test_split(mnist.data, mnist.target, test_size=0.1, random_state=2)
#%%## 输出示例图像
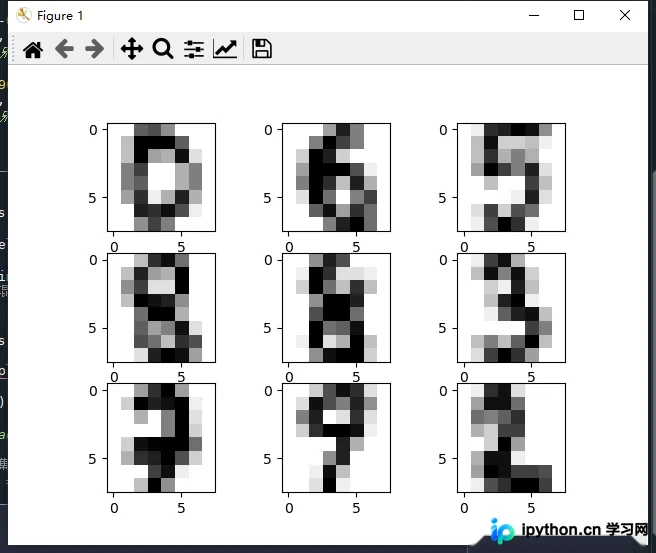
images = range(0,9)

plt.figure(dpi=100)
for i in images:
    plt.subplot(330 + 1 + i)
    plt.imshow(x[i].reshape(8, 8), cmap = matplotlib.cm.binary,interpolation="nearest")
# show the plot
plt.show()
#%%利用LDA对手写数字进行训练与预测
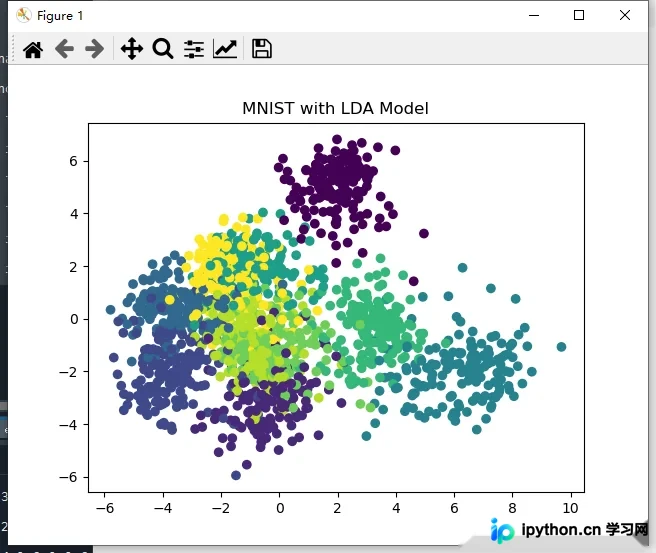
m_lda = LinearDiscriminantAnalysis()# 建立 LDA 模型
# 进行模型训练
m_lda.fit(x, y)
# 进行模型预测
x_new = m_lda.transform(x)
# 可视化预测数据
plt.scatter(x_new[:, 0], x_new[:, 1], marker='o', c=y)
plt.title('MNIST with LDA Model')
plt.show()
#%% 进行测试集数据的类别预测
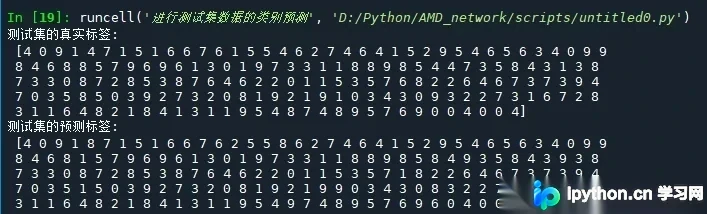
y_test_pred = m_lda.predict(test_x)
print("测试集的真实标签:\n", test_y)
print("测试集的预测标签:\n", y_test_pred)
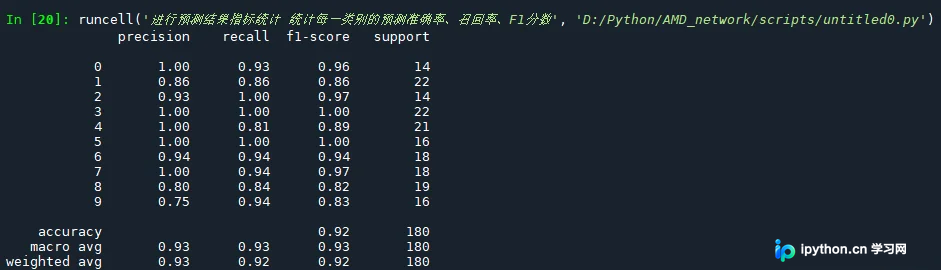
#%% 进行预测结果指标统计 统计每一类别的预测准确率、召回率、F1分数
print(classification_report(test_y, y_test_pred))
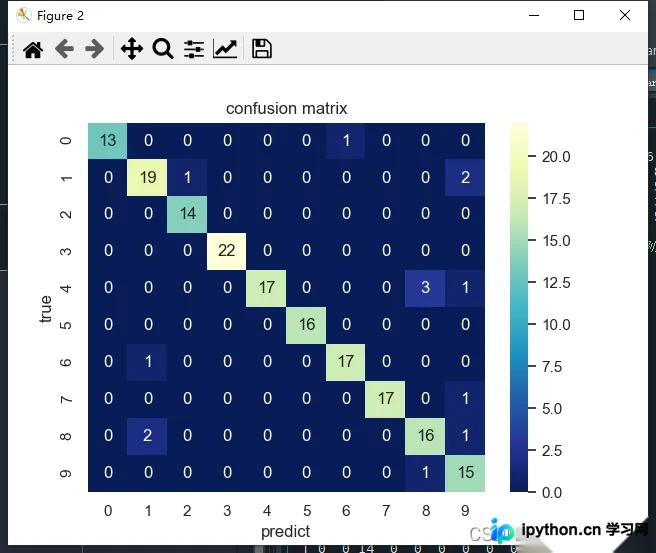
# 计算混淆矩阵
C2 = confusion_matrix(test_y, y_test_pred)
# 打混淆矩阵
print(C2)

# 将混淆矩阵以热力图的防线显示
sns.set()
f, ax = plt.subplots()
# 画热力图
sns.heatmap(C2, cmap="YlGnBu_r", annot=True, ax=ax)
# 标题
ax.set_title('confusion matrix')
# x轴为预测类别
ax.set_xlabel('predict')
# y轴实际类别
ax.set_ylabel('true')
plt.show()
四、总结
LDA适用于线性可分数据,在处理非线性数据时需谨慎使用。 886~~~
至此,关于Python机器学习应用中基于线性判别模型的分类详解介绍完毕。如需了解更多Python线性判别模型相关内容,欢迎搜索本站往期文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









