

Python多进程编程实战:从基础概念到进程池应用

本文深入解析Python中的进程概念,阐述进程与程序的区别及运行状态。通过multiprocessing模块演示Process类的创建、启动、同步及属性,讲解全局变量隔离与守护进程机制,并详细介绍利用Pool实现高效并发处理的异步与同步调用方法。
进程
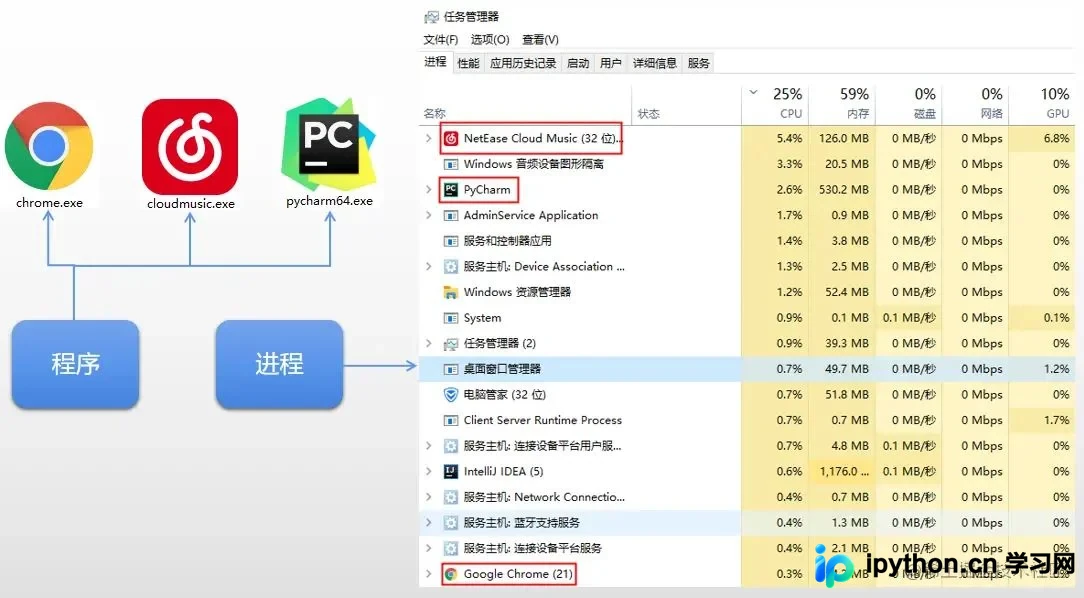
进程是操作系统进行资源分配和调度的基本单位,也是程序运行的隔离边界。
进程与程序的区别
程序本质上是一组静态的指令集合,它本身并不具备执行能力。
进程则是程序执行的具体实例,具有动态特征和生命周期,经历创建、运行到撤销的过程,其存在是暂时的。
进程与程序之间并非一一对应关系:一个程序可以启动多个进程,而一个进程在其生命周期内也可能执行多个不同的程序任务。
通俗理解,未运行的代码文件称为程序,而代码被操作系统加载并开始执行时,便启动了一个或多个进程。
进程的状态
在实际操作系统中,任务数量通常超过CPU核心数,导致部分任务正在执行,而其余任务处于等待状态,从而形成了进程的不同状态。
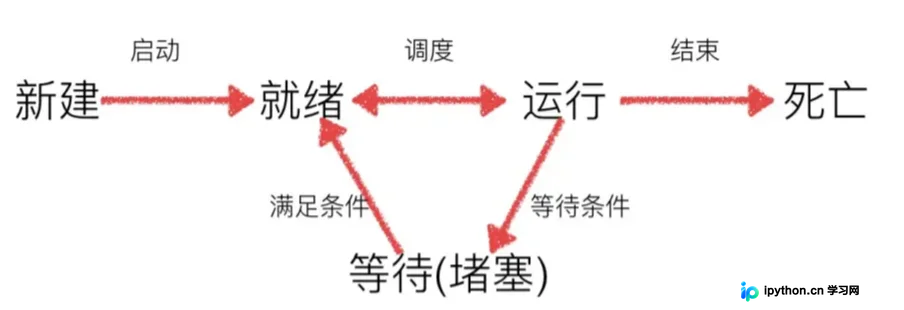
- 就绪状态:进程已具备所有运行条件,正在等待CPU分配时间片以执行。
- 执行状态:CPU正在处理该进程的计算任务。
- 等待状态:进程因等待某些条件满足(如I/O操作完成或调用sleep)而暂时挂起。
Python中的进程处理
在Python中,通过内置的multiprocessing多进程模块来创建和管理进程,该模块提供了Process类用于实例化进程对象。
创建子进程
Process类的语法结构如下:
Process(group, target, name, args, kwargs)
group:指定进程组,大多数场景下无需使用。target:指定调用对象,即子进程需要执行的具体任务函数。name:子进程的名称,若不设定则使用默认值。args:以元组形式传递给target指定函数的位置参数。kwargs:以字典形式传递给target指定函数的关键字参数。
Process常用方法
p.start():启动进程,并自动调用该子进程中的p.run()方法。p.join(timeout):主进程阻塞等待子进程执行结束,timeout参数为可选的超时时间。is_alive():检查子进程是否仍然存活。p.run():进程启动时运行的方法,负责调用target指定的函数。p.terminate():立即终止子进程的执行。
Process实例的常用属性
name:当前进程的别名,默认为Process-N,其中N是从1开始递增的整数。
pid:当前进程的进程ID(pid)。
import multiprocessing
import os
import time
def work(name):
    print("子进程work正在运行......")
    time.sleep(0.5)
    print(name)
    # 获取进程的名称
    print("子进程name", multiprocessing.current_process())
    # 获取进程的pid
    print("子进程pid", multiprocessing.current_process().pid, os.getpid())
    # 获取父进程的pid
    print("父进程pid", os.getppid())
    print("子进程运行结束......")
if __name__ == '__main__':
    print("主进程启动")
    # 获取进程的名称
    print("主进程name", multiprocessing.current_process())
    # 获取进程的pid
    print("主进程pid", multiprocessing.current_process().pid, os.getpid())
    # 创建进程
    p = multiprocessing.Process(group=None, target=work, args=("tigeriaf", ))
    # 启动进程
    p.start()
    print("主进程结束")
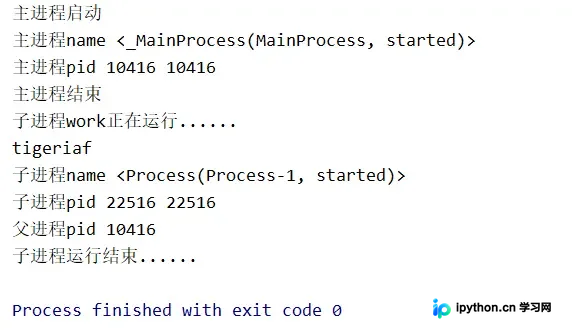
通过上述代码示例可见,multiprocessing.Process帮助我们创建并成功运行了一个子进程。然而,若主进程在子进程执行完毕前就已退出,子进程将变为孤儿进程。为确保主进程等待子进程结束,我们可以调用p.join(),其作用正是让主进程阻塞直到子进程执行完毕。
import multiprocessing
import os
import time
def work(name):
    print("子进程work正在运行......")
    time.sleep(0.5)
    print(name)
    # 获取进程的名称
    print("子进程name", multiprocessing.current_process())
    # 获取进程的pid
    print("子进程pid", multiprocessing.current_process().pid, os.getpid())
    # 获取父进程的pid
    print("父进程pid", os.getppid())
    print("子进程运行结束......")
if __name__ == '__main__':
    print("主进程启动")
    # 获取进程的名称
    print("主进程name", multiprocessing.current_process())
    # 获取进程的pid
    print("主进程pid", multiprocessing.current_process().pid, os.getpid())
    # 创建进程
    p = multiprocessing.Process(group=None, target=work, args=("tigeriaf", ))
    # 启动进程
    p.start()
    p.join()
    print("主进程结束")
运行结果:
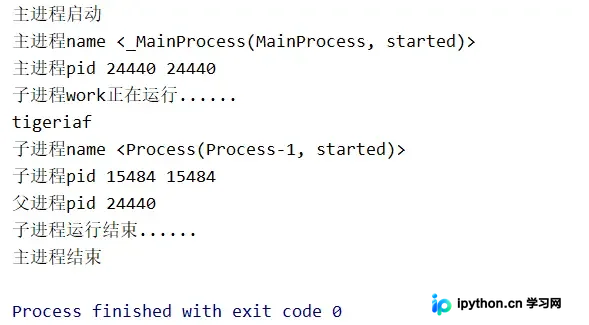
从结果可以看出,主进程是在子进程结束后才退出的。
全局变量隔离问题
在多个进程中,全局变量是不共享的,进程间的数据相互独立,默认情况下互不影响。
import multiprocessing
# 定义全局变量
num = 99
def work1():
    print("work1正在运行......")
    global num   # 在函数内部声明使⽤全局变量num
    num = num + 1  # 对num值进⾏+1
    print("work1 num = {}".format(num))
def work2():
    print("work2正在运行......")
    print("work2 num = {}".format(num))
if __name__ == '__main__':
    # 创建进程p1
    p1 = multiprocessing.Process(group=None, target=work1)
    # 启动进程p1
    p1.start()
    # 创建进程p2
    p2 = multiprocessing.Process(group=None, target=work2)
    # 启动进程p2
    p2.start()
运行结果:
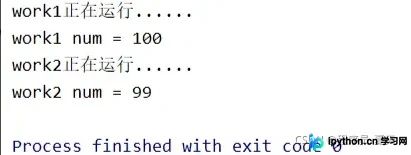
从运行结果可以看出,work1()函数对全局变量num的修改,在work2中并未生效,work2读取到的仍是原始值99,这证明进程之间不共享变量。
守护进程设置
前文提到可以使用p.join()让主进程等待子进程结束,那么是否可以让子进程随主进程结束而立即终止呢?答案是肯定的。我们可以通过设置p.daemon = True或者调用p2.terminate()来实现:
import multiprocessing
import time
def work1():
    print("work1正在运行......")
    time.sleep(4)
    print("work1运行完毕")
def work2():
    print("work2正在运行......")
    time.sleep(10)
    print("work2运行完毕")
if __name__ == '__main__':
    # 创建进程p1
    p1 = multiprocessing.Process(group=None, target=work1)
    # 启动进程p1
    p1.start()
    # 创建进程p2
    p2 = multiprocessing.Process(group=None, target=work2)
    # 设置p2守护主进程
    # 第⼀种⽅式
    # p2.daemon = True  在start()之前设置,不然会抛异常
    # 启动进程p2
    p2.start()
    time.sleep(2)
    print("主进程运行完毕!")
    # 第⼆种⽅式
    p2.terminate()
执行结果如下:
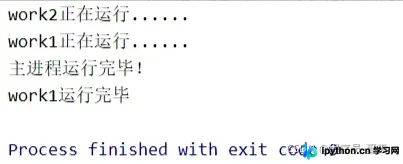
由于p2被设置为守护主进程,因此当主进程运行完毕后,p2子进程也随之结束,work2任务停止,而work1继续运行直至完成。
进程池应用
当需要创建的子进程数量较少时,可以直接利用multiprocessing.Process动态生成多个进程;但若需创建大量进程,手动创建的工作量将极其巨大,此时可以使用multiprocessing模块提供的Pool类来创建进程池,以简化并发任务管理。
multiprocessing.Pool常用函数:
apply_async(func, args, kwds):以非阻塞方式调用func(任务并行执行),args为传递给func的位置参数列表,kwds为关键字参数列表。apply(func, args, kwds):以阻塞方式调用func,必须等待上一个进程执行完任务后才能执行下一个进程,了解即可,实际开发中较少使用。close():关闭Pool,使其不再接受新的任务提交。terminate():无论任务是否完成,立即终止所有进程。join():主进程阻塞,等待所有子进程退出,必须在close或terminate之后使用。
初始化Pool时,可以指定最大进程数。当有新任务提交到Pool中时,如果进程池未满,则创建新进程执行该任务;如果进程池已满(达到指定的最大值),则该任务会等待,直到池中有进程结束并释放资源后,才会创建新进程来执行。
from multiprocessing import Pool
import time
def work(i):
    print("work'{}'执行中......".format(i), multiprocessing.current_process().name, multiprocessing.current_process().pid)
    time.sleep(2)
    print("work'{}'执行完毕......".format(i))
if __name__ == '__main__':
    # 创建进程池
    # Pool(3) 表示创建容量为3个进程的进程池
    pool = Pool(3)
    for i in range(10):
        # 利⽤进程池同步执⾏work任务,进程池中的进程会等待上⼀个进程执行完任务后才能执⾏下⼀个进程
        # pool.apply(work, (i, ))
        # 使⽤异步⽅式执⾏work任务
        pool.apply_async(work, (i, ))
    # 进程池关闭之后不再接受新的请求
    pool.close()
    # 等待po中所有子进程结束,必须放在close()后面, 如果使⽤异步⽅式执⾏work任务,主线程不再等待⼦线程执⾏完毕再退出!
    pool.join()
执行结果为:
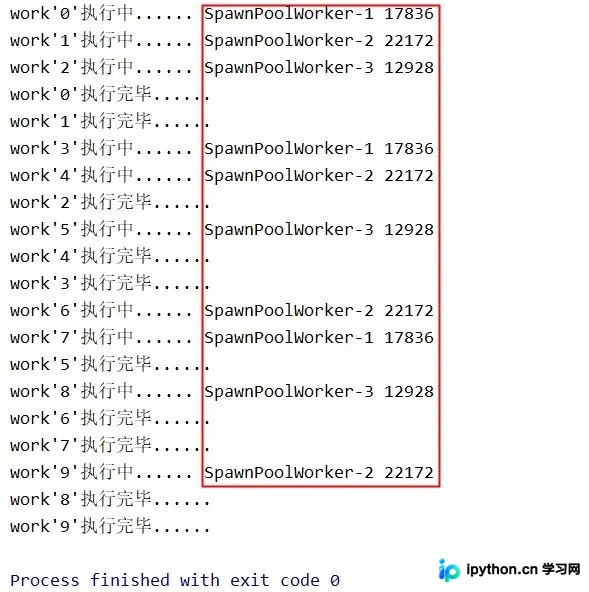
从结果可以看出,只有3个子进程在执行任务。此处我们使用的是异步方式(pool.apply_async(work, (i, )))执行work任务;如果是以同步方式(pool.apply(work, (i, )))执行,进程池中的进程会等待上一个进程执行完任务后才能执行下一个进程。
总结
本篇主要介绍了进程的基本概念、进程与程序的关系、进程的创建与使用方法,以及进程池的创建与应用。并未涉及进程同步及进程通信等高级主题,相关内容将在下篇文章中介绍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









