

Python实现双曲嵌入:基于Poincaré Embeddings的层级网络数据处理与可视化

本文基于Poincaré Embeddings论文,使用Python重新实现层级表示学习算法。通过WordNet数据集中哺乳动物分支构建层次网络,利用双曲几何特性解决欧氏空间难以刻画层级结构的问题。文中详细展示了从数据读取、网络构建到可视化的完整代码流程,并对比了不同层级节点的特征展示。
本文学习的核心文献为:
《Poincaré Embeddings for Learning Hierarchical Representations》
主要参考的开源代码库包括:
poincare_embeddings
gensim库中的Topic Modelling模块(poincare.py)
鉴于部分现有代码存在运行困难、封装过深导致可读性差,甚至包含潜在逻辑错误等问题,我们依据论文原始设定,利用Python重新实现了该方法。目前代码已成功运行,并完成了相应的结果绘图展示。
1. 研究目标
面对具有层级结构的网络数据,我们的核心任务是根据词语在层级路径中的位置,将其映射为实数域中的一个向量(即词嵌入,word embedding)。最直观的思路是使用One-hot编码,虽然构建简单,但并非理想方案。主要原因在于,One-hot向量无法准确反映词语间的相似度,更无法体现词语间的层次关系。另一种常见方法是在欧氏空间进行嵌入(如Word2Vec),这种方式能有效表达词语相似度,但在刻画层级结构方面依然力不从心。
为同时衡量词间相似度与层级结构,本文引入双曲几何思想,在双曲空间中进行嵌入。相较于欧氏空间,双曲嵌入在表征层级结构时具有显著优势,且所需的维度更低。
Python 代码依赖库
为确保后续代码顺利运行,以下列出所需的依赖库:
import nltk
# nltk.download('wordnet') # 第一次运行需运行此命令,安装wordnet数据集
from nltk.corpus import wordnet as wn
from math import *
import random
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.lines as mlines
import networkx as nx
2. 数据集构建
训练数据选用WordNet数据集,具体数据说明已在前期文档中介绍,此处不再赘述。
由于WordNet数据集规模庞大,为验证代码逻辑,我们仅选取“哺乳动物(mammal)”及其相关分支进行训练。首先观察数据集的结构。因仅需利用层次结构信息,我们只需读取并构建数据集中每个哺乳动物相关名词与其父节点、子节点的关系。
network = {} # 构建层级网络
last_level = 8 # 最深的层设置为8层
levelOfNode = {} # 数据的层级信息,0为哺乳动物(根节点),1为哺乳动物下一结构
# 递归构建network
def get_hyponyms(synset, level):
    if (level == last_level):
        levelOfNode[str(synset)] = level
        return
    if not str(synset) in network:
        network[str(synset)] = [str(s) for s in synset.hyponyms()]
        levelOfNode[str(synset)] = level
    for hyponym in synset.hyponyms():
        get_hyponyms(hyponym, level + 1)
# 构建以哺乳动物为根节点的层次结构数据集
mammal = wn.synset('mammal.n.01')
get_hyponyms(mammal, 0)
levelOfNode[str(mammal)] = 0
# 将终端叶子节点补到network字典中
for a in levelOfNode:
    if not a in network:
        network[a] = []
数据展示
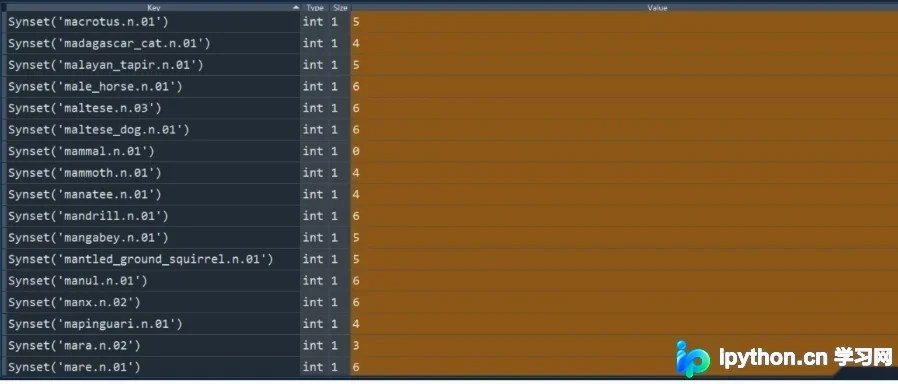
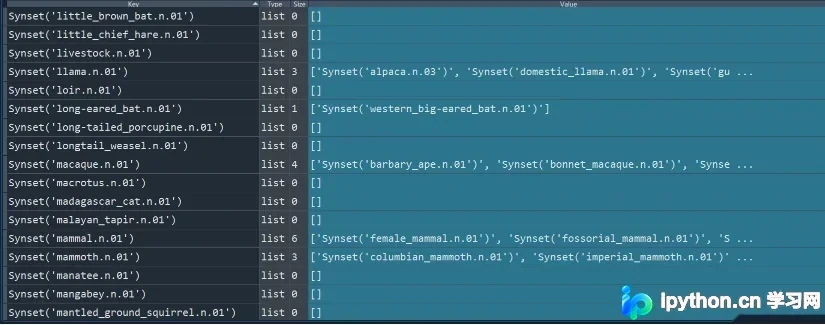
运行上述代码后,可获得对应的节点层级信息及总体网络分支情况。
节点层级(数值代表层级数,最深层级设为6,根节点为0)
网络分支分布情况
为更清晰地刻画树状结构,我们通过额外代码直接展示相关的层次结构。
def norm(x):
    return np.dot(x, x)

def traverse(graph, start, node):
    node_name = node.name().split(".")[0]
    graph.depth[node_name] = node.shortest_path_distance(start)
    for child in node.hyponyms():
        child_name = child.name().split(".")[0]
        graph.add_edge(node_name, child_name) # 添加边
        traverse(graph, start, child) # 递归构建

def hyponym_graph(start):
    G = nx.Graph() # 定义一个图
    G.depth = {}
    traverse(G, start, start)
    return G

def graph_draw(graph):
    plt.figure(figsize=(10, 10)) # 展示整体的网络
    # plt.figure(figsize=(3, 3)) # 展示大象网络
    nx.draw(graph,
         node_size = [10 * graph.degree(n) for n in graph],
         node_color = [graph.depth[n] for n in graph],
         alpha = 0.8,
         font_size = 4,
         width = 0.5,
         with_labels = True)

def get_keys(d, value):
        return [k for k,v in d.items() if v == value]
    root_name = get_keys(graph.depth, 0)[0]
    plt.savefig("~/hyperE/fig/" + root_name + ".png", dpi = 300)

graph = hyponym_graph(mammal)
graph_draw(graph)
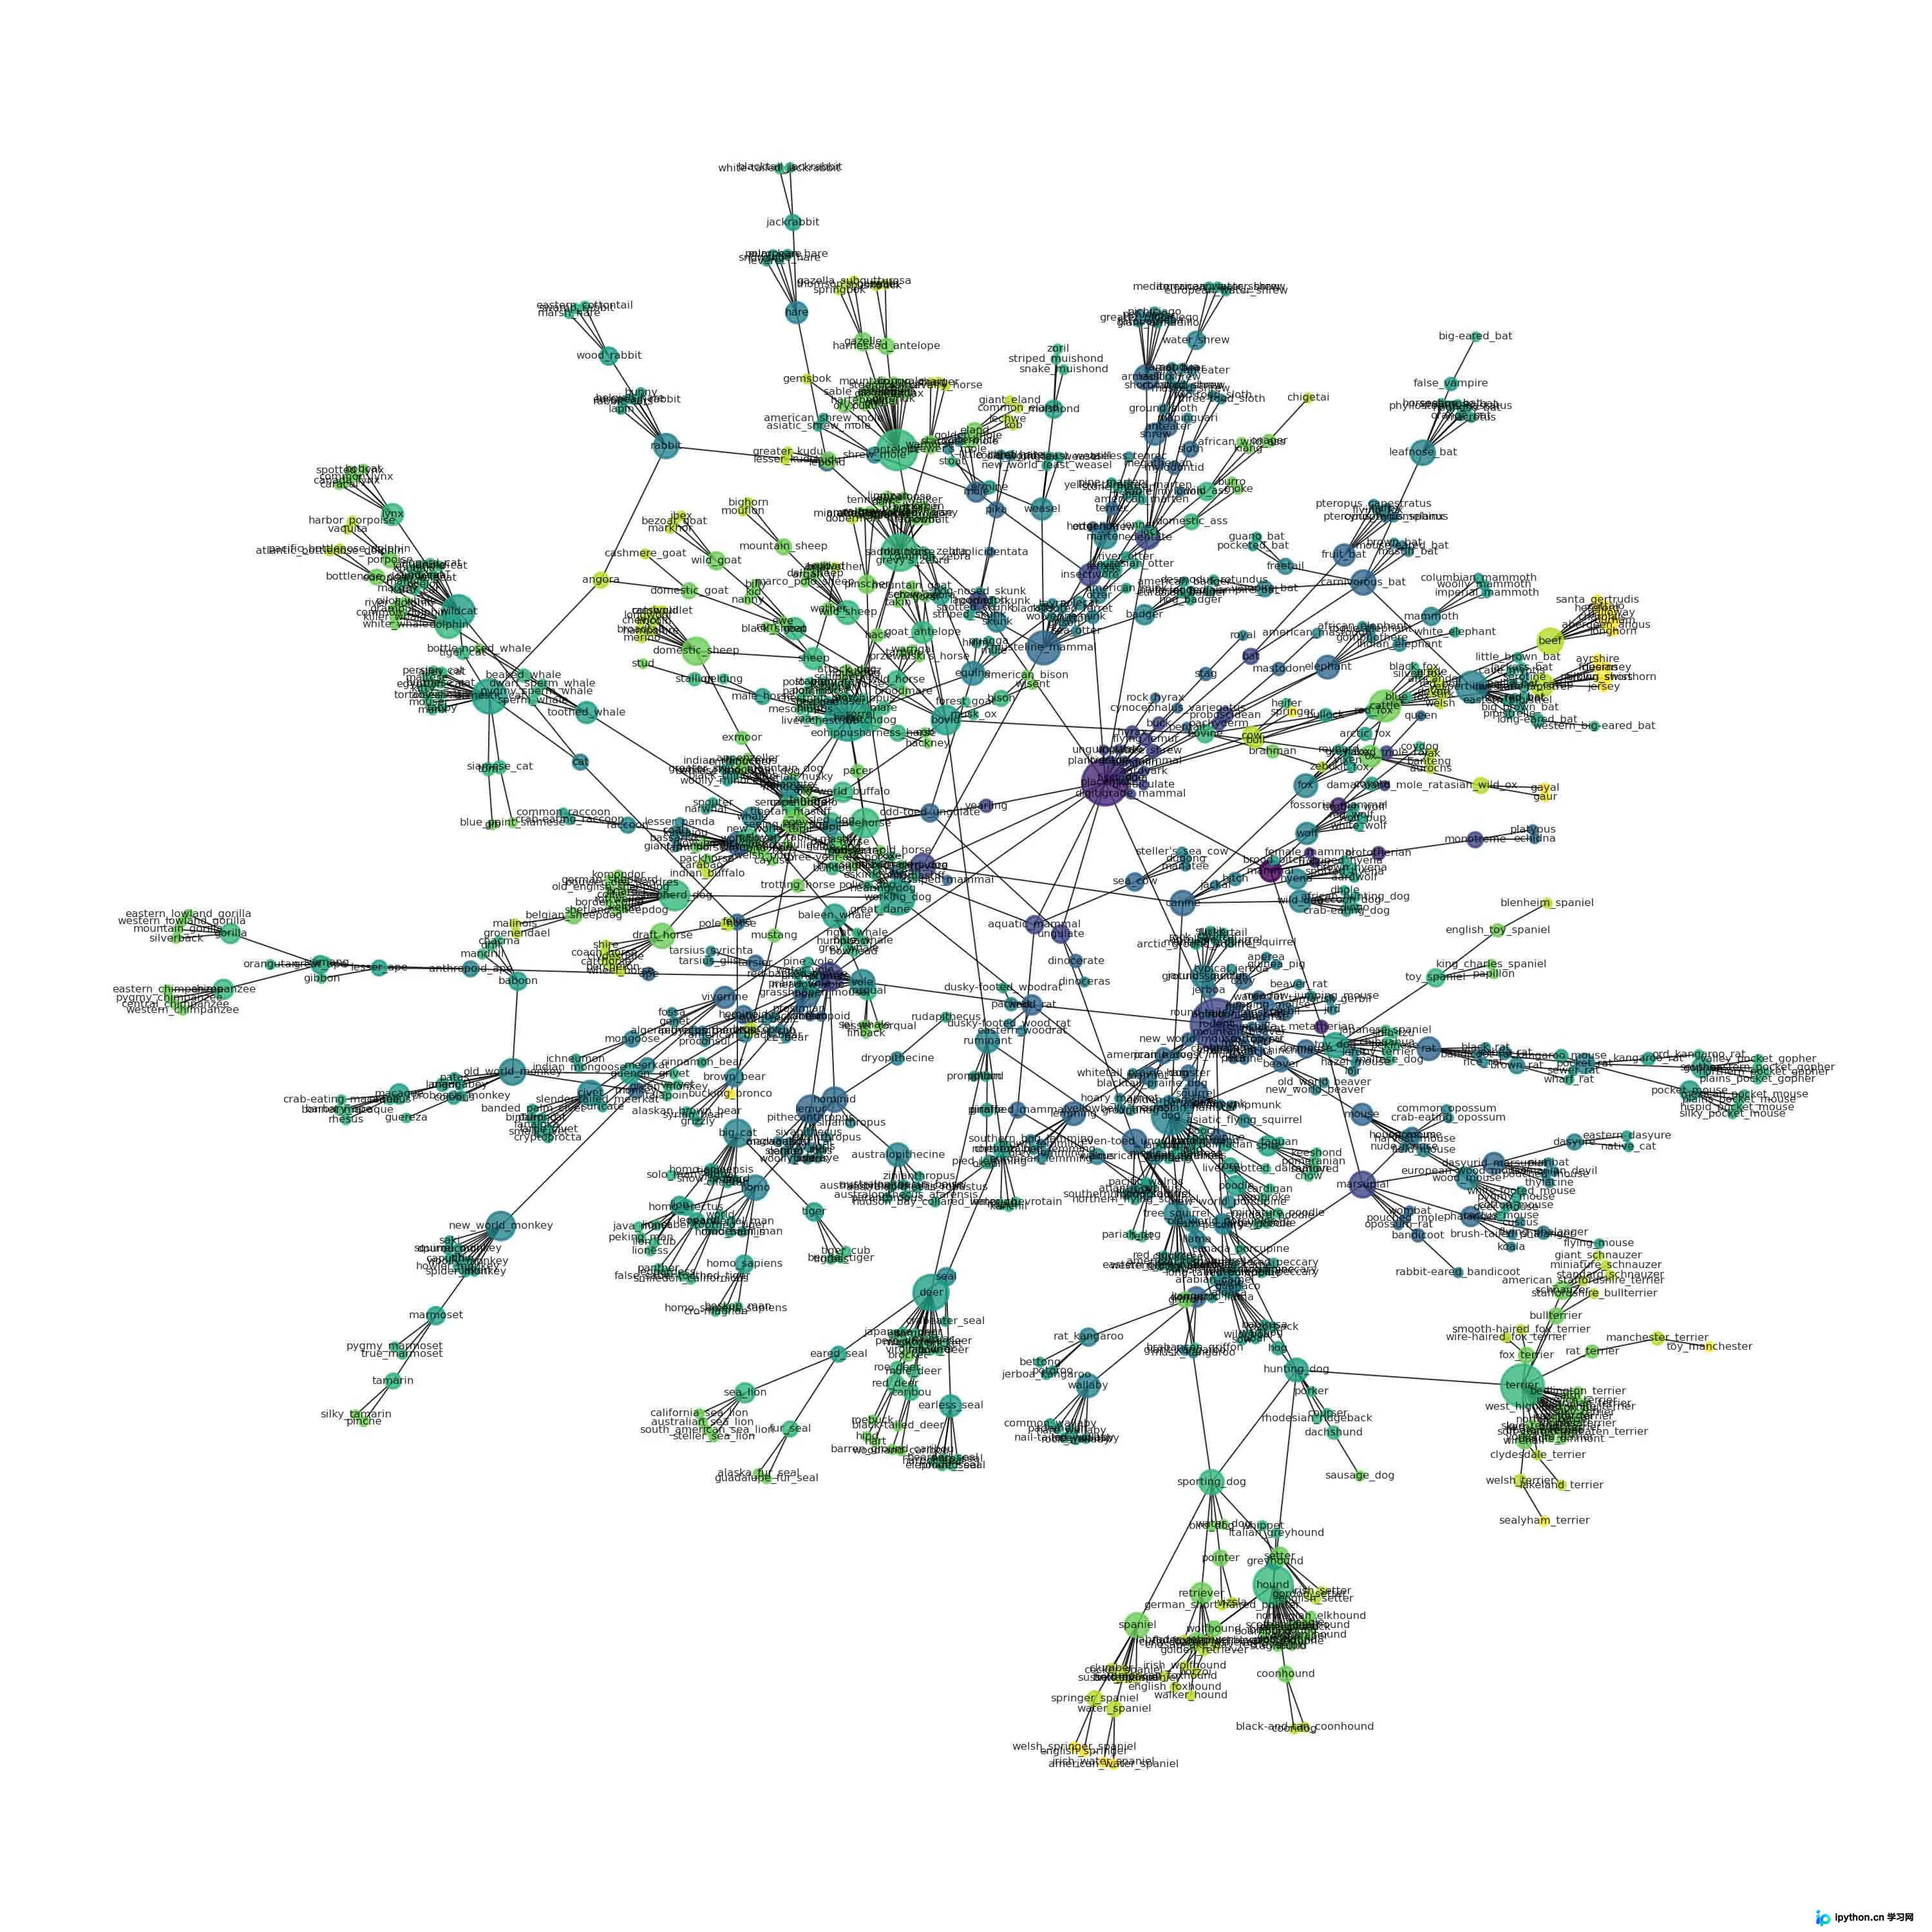
绘制出的哺乳动物(mammal)整体结构如下(此时仅包含层级信息,无空间信息,图示样式仅为展示需要):
图中颜色越深、节点越大,表示该节点层级越接近根节点(即哺乳动物)。
由于数据量较大,整体展示不够清晰。此处单独提取大象(elephant)的结构,以便进一步观察数据集的具体情况。
elephant = wn.synset('elephant.n.01')
graph = hyponym_graph(elephant)
graph_draw(graph)
后续我们将利用这份数据集,详细介绍该方法及双曲嵌入模型的训练过程。
详见:python算法学习双曲嵌入论文方法与代码解析说明
以上为python算法学习双曲嵌入论文代码实现数据集介绍的详细内容,更多关于python数据集双曲嵌入论文代码的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









