


很多人看到 PostgreSQL 15 引入 CREATE PROCEDURE,会以为终于能把事务提交、回滚都写进存储过程里,结果一上手就遇到语法错误,或者发现“过程执行成功了,数据却要等外部提交才真正生效”。这篇文章把几个最容易混淆的点拆开讲清楚:哪些事务动作能放进过程,哪些必须交给调用方,以及什么时候该用 SAVEPOINT 处理局部失败。
存储过程能做什么,不能做什么
先说结论:在 PostgreSQL 15 中,CREATE PROCEDURE 可以用于承载事务性业务逻辑,但过程体本身不能直接写 BEGIN、COMMIT、ROLLBACK 来结束或切换事务边界。
原因在于,过程默认运行在调用它时所在的事务上下文里。也就是说,过程中的所有插入、更新、删除操作,天然都归属于外层事务;过程本身没有权限脱离这个外层事务去独立提交或独立回滚。
实际开发里,常见现象通常有两类:
- 直接在过程里写
BEGIN、COMMIT或ROLLBACK,结果遇到语法错误。 - 以为某一步“已经执行完”就算落库了,实际上要等外部事务
COMMIT之后,所有变更才会真正生效。
这里还要特别区分对象类型:
- 必须使用
CREATE PROCEDURE,不能误写成CREATE FUNCTION。 - 如果过程是通过
CALL放在一个已经开启的事务中执行,它不能替调用方结束这个事务。 - 过程内部真正可用的“局部回退”手段,是
SAVEPOINT与ROLLBACK TO SAVEPOINT。
如果你看到类似错误,例如 ERROR: SAVEPOINT is not allowed in a procedure,通常要先检查是不是版本不符,或者实际上写成了 FUNCTION、调用方式也不对。
局部回滚为什么要靠 SAVEPOINT
当一个过程里包含多段操作,而你希望“前面的成功保留、后面的失败只撤销后半段”时,就不能靠整个事务直接回滚,而要在合适的位置打一个保存点,也就是 SAVEPOINT。
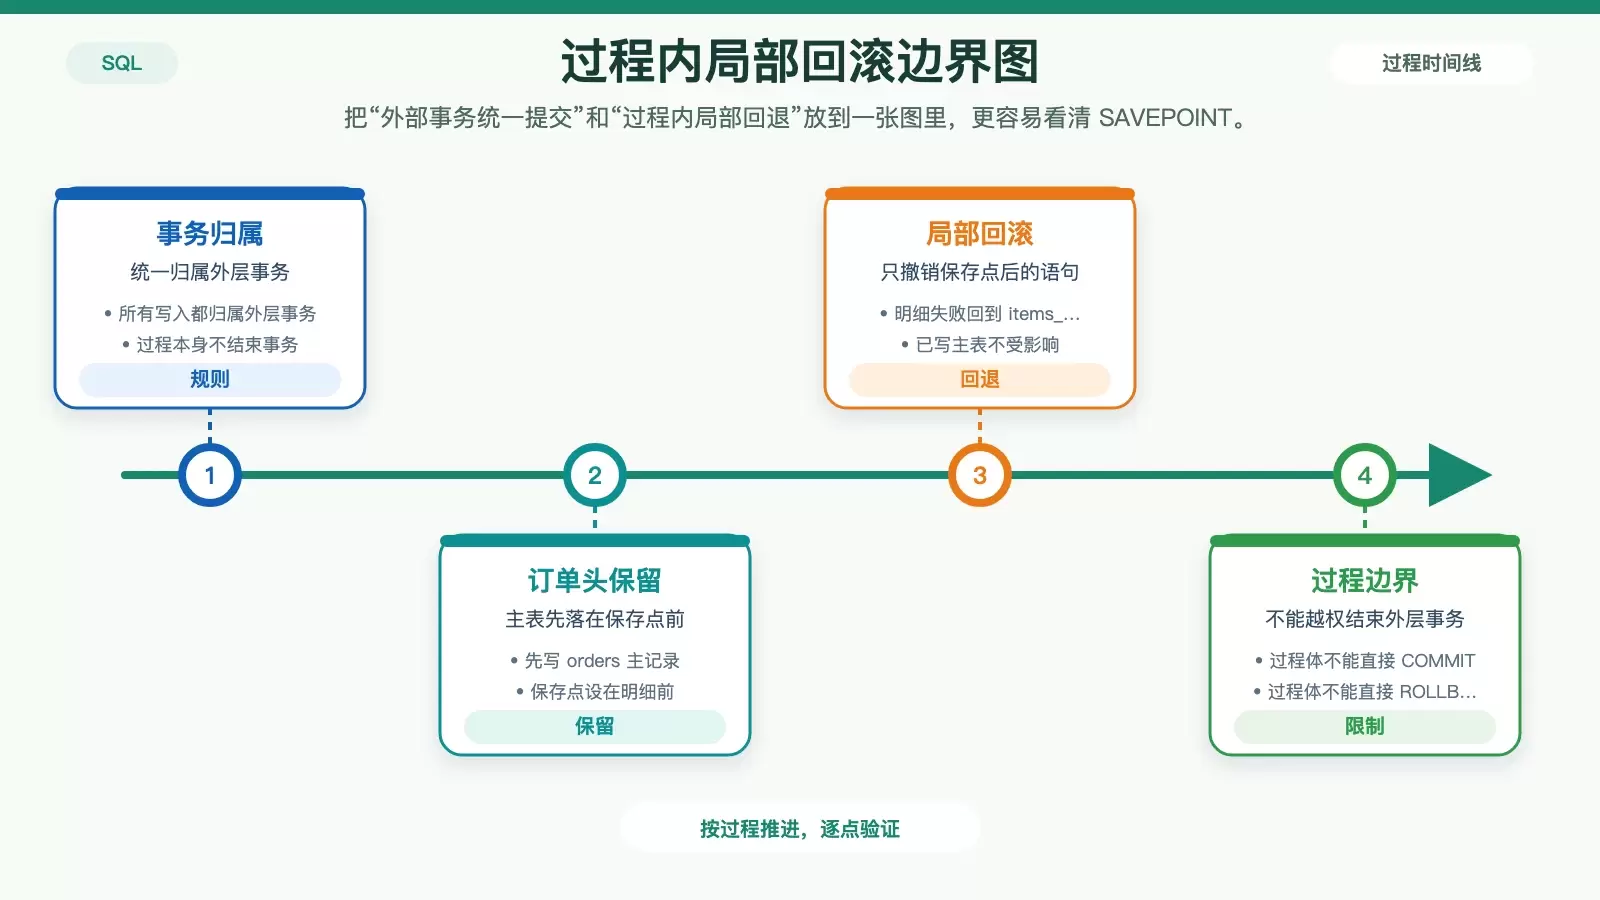
SAVEPOINT 不是独立事务,它只是外层事务中的一个中间标记。后续语句出错时,你可以通过 ROLLBACK TO SAVEPOINT 回到这个标记点,把之后的修改撤销掉,但在保存点之前已经完成的那部分仍然保留在当前事务里。
这类需求在主从表写入场景里很常见。比如先创建订单头,再批量插入订单明细;如果明细插入失败,希望保留订单头,只丢弃失败的明细数据,就适合使用保存点。
订单主表保留、明细局部回退示例
下面这个过程示例,展示的就是“先写主表,再让明细部分支持局部回滚”的思路:
CREATE OR REPLACE PROCEDURE create_order_with_items(
p_customer_id INT,
p_items TEXT[] -- 格式如 '{"item1,100","item2,200"}'
)
LANGUAGE plpgsql
AS $$
DECLARE
v_order_id INT;
BEGIN
INSERT INTO orders (customer_id) VALUES (p_customer_id) RETURNING id INTO v_order_id;

-- 设立保存点,后续操作可局部回滚
SAVEPOINT items_insert;

FOREACH item IN ARRAY p_items LOOP
INSERT INTO order_items (order_id, product, amount)
VALUES (v_order_id, split_part(item, ',', 1), split_part(item, ',', 2)::NUMERIC);
END LOOP;

EXCEPTION
WHEN OTHERS THEN
-- 仅回滚至保存点,订单头依然保留
ROLLBACK TO SAVEPOINT items_insert;
RAISE NOTICE '部分项目插入失败,订单 % 已保留', v_order_id;
END;
$$;
这段逻辑的关键点有三个:
- 订单头是在保存点之前插入的,因此明细失败后,它不会被这次局部回退影响。
ROLLBACK TO SAVEPOINT items_insert只撤销保存点之后的修改,不会终止整个过程。- 回退之后,过程仍然可以继续执行后续语句,比如
RAISE NOTICE、记录日志或返回状态。
使用 SAVEPOINT 时的几个限制
SAVEPOINT名字要唯一,避免嵌套场景下互相覆盖。- 同一过程内如果重复定义同名保存点,后一个会覆盖前一个。
- 不能对同一个保存点反复执行无效的
ROLLBACK TO SAVEPOINT,否则可能报invalid savepoint。
换句话说,保存点适合处理“过程中的某一段可能失败,但不想把前面全部撤销”的场景;它解决的是局部失败恢复,而不是让过程获得完整的事务控制权。
PROCEDURE 和 FUNCTION 的事务差异
很多事务问题,根源不在 SQL 写错,而在于一开始就把对象类型选错了。PROCEDURE 和 FUNCTION 看起来都能封装逻辑,但它们在事务模型上的边界完全不同。
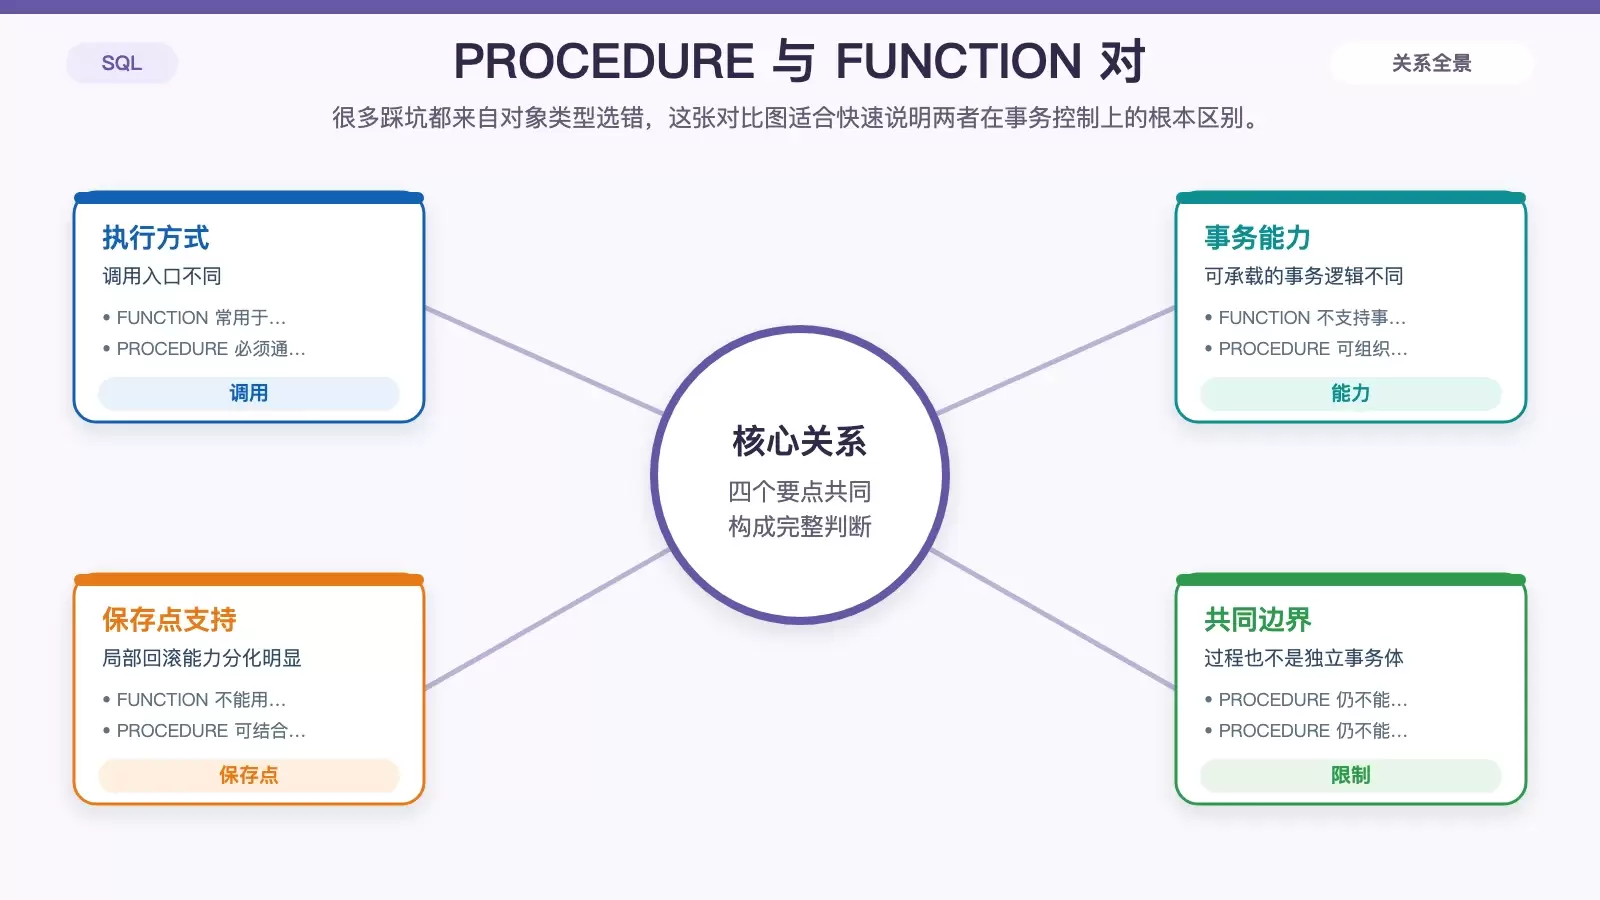
CREATE FUNCTION:运行在调用它的事务上下文中,不支持事务控制语句,连SAVEPOINT也不能作为过程化事务控制手段来用;所有数据修改都绑定在调用方事务上。CREATE PROCEDURE:更适合承载事务性操作,允许使用SAVEPOINT、RAISE、GET DIAGNOSTICS等机制处理复杂流程,但依然不能在过程体里直接COMMIT/ROLLBACK。- 调用方式也不同:函数通常用于
SELECT,过程必须通过CALL执行。
典型踩坑是把批量更新、分段容错这类逻辑写成 FUNCTION。结果一旦中间异常,你既没有保存点机制做局部回退,也不能在函数内部处理中途事务,只能把结果交给外层事务统一裁决。对复杂写入流程来说,这通常不够用。
没有显式 BEGIN 时,CALL 到底怎么提交
另一个容易误解的点是:如果直接执行 CALL my_proc(),前面没有手动写 BEGIN,PostgreSQL 仍然会为这次调用开启一个隐式事务,并在过程成功结束后自动 COMMIT。
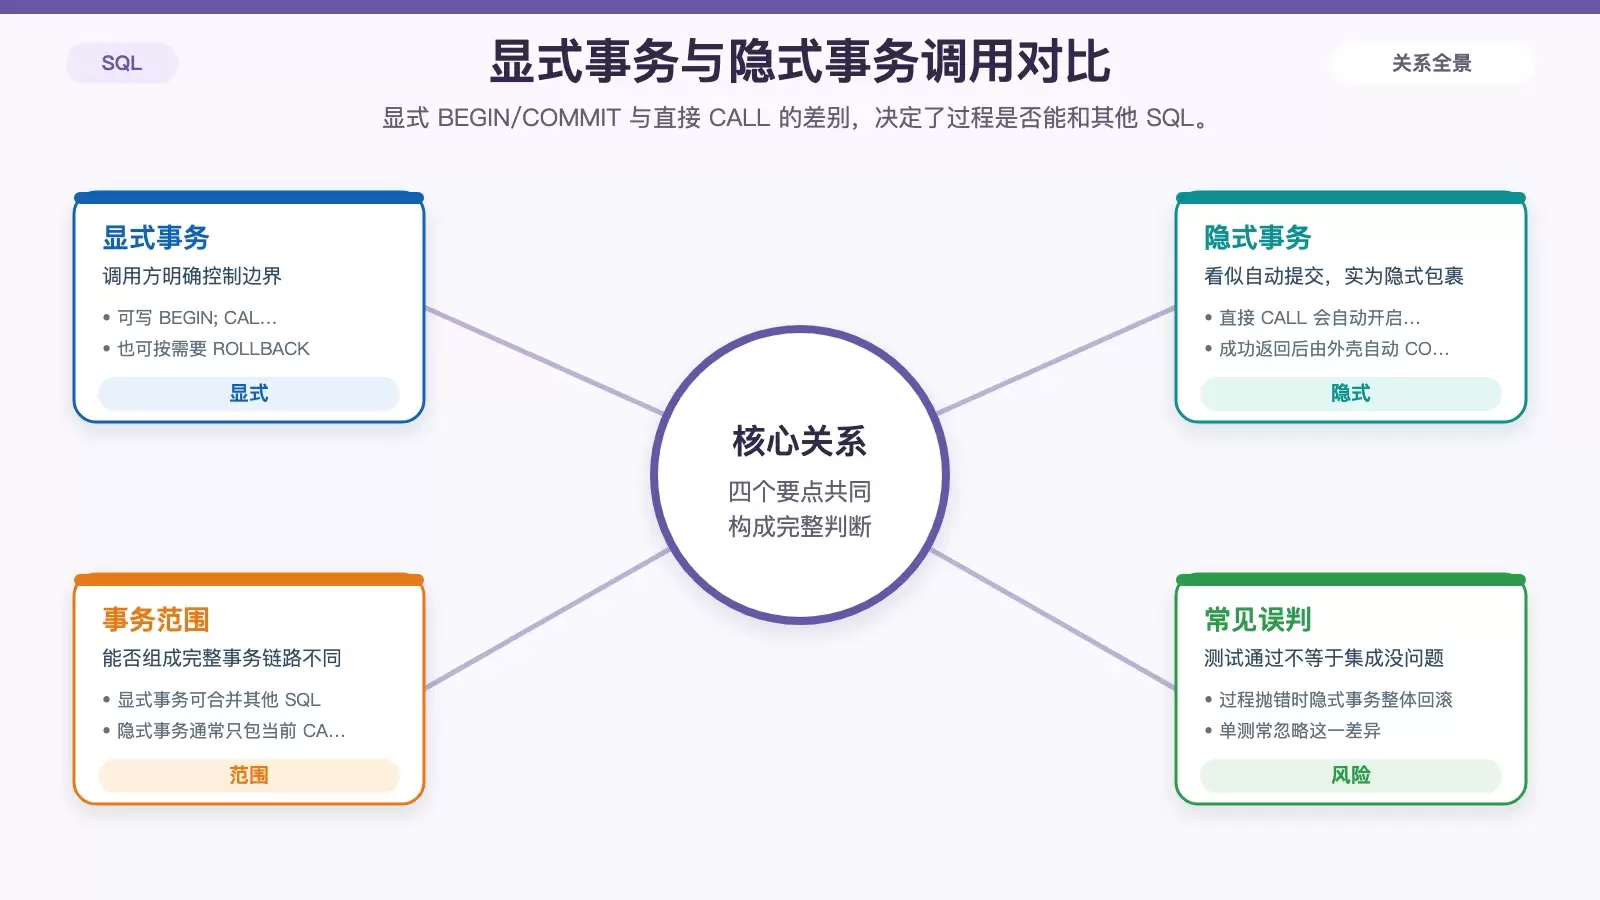
这看起来像是“过程自己提交了事务”,但其实不是。真正负责开启和提交的,是 PostgreSQL 在这次单独调用外面包了一层隐式事务。
这种行为有两个直接后果:
- 你没法在调用前后自由拼接其他 SQL,并把它们和这次
CALL放进同一个事务块里。 - 如果过程内部抛错,整个隐式事务会回滚,已经执行的语句也都会一起撤销。
因此在生产环境里,更稳妥的方式通常是显式控制事务边界,例如:
BEGIN;
CALL ...;
COMMIT;
或者:
BEGIN;
CALL ...;
ROLLBACK;
这样做的价值,不只是“写得更正式”,而是让过程调用能与其他业务 SQL 组成一个完整的事务单元,提交和回滚策略也更可控。
测试里如果只是单独跑一个过程,很容易忽略这一点,导致单测通过、集成后却出问题,因为真实业务里它往往嵌在更长的事务链路中。
异常处理与生产环境建议
最后还要补一个常被忽略的细节:过程内部的 RAISE EXCEPTION 并不会自动替你决定外层事务是否回滚。它只是把错误抛出去,至于调用方是捕获异常、继续处理,还是让整个事务失败,取决于外层有没有相应的异常处理和事务边界设计。
如果要把这类过程放进生产环境,可以优先遵循几条原则:
- 把事务边界放在调用方,而不是寄希望于过程内部“自己提交”。
- 把需要局部容错的步骤放在
SAVEPOINT之后,确保回滚范围清晰。 - 区分“主记录必须保留”和“附属记录可回退”的业务边界,再决定保存点位置。
- 关注
pg_stat_activity中state = 'idle in transaction'的会话,这通常意味着显式事务没有正确结束,是生产问题信号。
归纳起来,PostgreSQL 15 的存储过程并不是“过程内随便管事务”,而是“事务由外层统一掌控,过程内部只负责细粒度的局部回退和异常组织”。把这个边界想清楚,很多看似诡异的提交、回滚行为就都能解释通了。









