

Python实现KNN分类算法:从原理到代码实战

本文详细介绍K最近邻(KNN)分类算法的核心原理,并通过Python代码实现完整流程。内容涵盖数据预处理、利用留出法拆分训练集与测试集、构建KNN类(含距离计算与加权投票机制),以及在鸢尾花数据集上的分类实验。最终展示模型准确率及散点图可视化结果,帮助读者理解KNN在分类任务中的应用与优化方向。
一、KNN算法简介
邻近算法,即K最近邻(kNN,k-Nearest Neighbor)分类算法,是数据挖掘与分类技术中最为基础的方法之一。其核心概念“K最近邻”意指每个样本均可由其最接近的k个邻居样本进行代表性描述。
KNN算法的核心思想在于:若一个样本在特征空间中与其距离最近的k个样本中,大多数归属于某一特定类别,则该样本也应当被判定为该类别,并具备该类样本的典型特征。在确定分类决策时,该方法仅依据最邻近的一个或几个样本的类别来判定待分样本的归属。由于KNN方法主要依赖周围有限的邻近样本,而非通过判别整个类域的方法来确定所属类别,因此,对于类域交叉或重叠较多的待分样本集,KNN方法通常比其他方法更为适用。
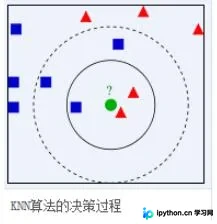
二、算法过程
1. 读取数据集
2. 处理数据集数据:进行清洗,并采用留出法(hold-out)将数据集拆分为训练集和测试集。
3. 实现KNN算法类:
1)遍历训练数据集,通过离差平方和计算各点之间的距离。
2)对计算出的各点距离数组进行排序,根据输入的k值选取对应的k个最近点。
3)在选定的k个点中,统计每个点出现的次数。此处权重设定为距离的导数(注:代码中实际使用距离倒数),取统计值最大的那个,其索引即为计算得出的判定类别。
三、代码实现及数据分析
import numpy as np
import pandas as pd

# 读取鸢尾花数据集,header参数来指定标题的行。默认为0。如果没有标题,则使用None。
data = pd.read_csv("你的目录/Iris.csv",header=0)
# 显示前n行记录。默认n的值为5。
#data.head()
# 显示末尾的n行记录。默认n的值为5。
#data.tail()
# 随机抽取样本。默认抽取一条,我们可以通过参数进行指定抽取样本的数量。
# data.sample(10)
# 将类别文本映射成为数值类型

data["Species"] = data["Species"].map({"Iris-virginica": 0, "Iris-setosa": 1, "Iris-versicolor": 2})
# 删除不需要的Id列。
data.drop("Id", axis=1, inplace=True )
data.drop_duplicates(inplace=True)
## 查看各个类别的鸢尾花具有多少条记录。
data["Species"].value_counts()
分析:首先读取数据集,具体数据展示如下图所示:
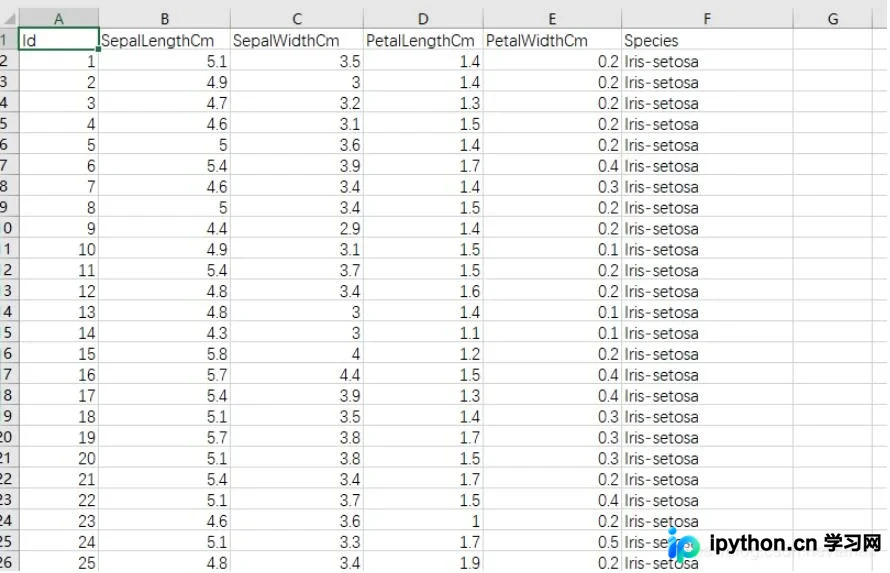
最后一列为数据集的分类名称。但在程序处理中,我们更倾向于使用0、1、2等数字来表示分类。对数据集进行相应处理后,结果如下所示:
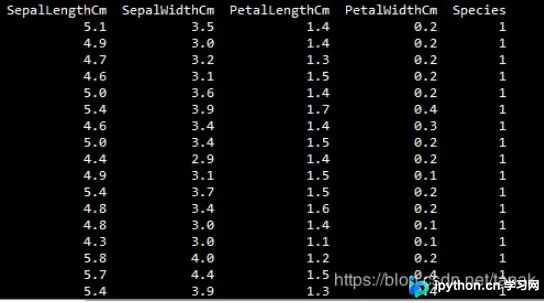
随后采用留出法对数据集进行拆分,一部分用于训练,另一部分用于测试,拆分后的数据情况如下:
#构建训练集与测试集,用于对模型进行训练与测试。
# 提取出每个类比的鸢尾花数据
t0 = data[data["Species"] == 0]
t1 = data[data["Species"] == 1]
t2 = data[data["Species"] == 2]
# 对每个类别数据进行洗牌 random_state 每次以相同的方式洗牌 保证训练集与测试集数据取样方式相同
t0 = t0.sample(len(t0), random_state=0)
t1 = t1.sample(len(t1), random_state=0)
t2 = t2.sample(len(t2), random_state=0)
# 构建训练集与测试集。
train_X = pd.concat([t0.iloc[:40, :-1], t1.iloc[:40, :-1], t2.iloc[:40, :-1]] , axis=0)#截取前40行,除最后列外的列,因为最后一列是y
train_y = pd.concat([t0.iloc[:40, -1], t1.iloc[:40, -1], t2.iloc[:40, -1]], axis=0)
test_X = pd.concat([t0.iloc[40:, :-1], t1.iloc[40:, :-1], t2.iloc[40:, :-1]], axis=0)
test_y = pd.concat([t0.iloc[40:, -1], t1.iloc[40:, -1], t2.iloc[40:, -1]], axis=0)
实现KNN算法类:
#定义KNN类,用于分类,类中定义两个预测方法,分为考虑权重不考虑权重两种情况
class KNN:
 ''' 使用Python语言实现K近邻算法。(实现分类) '''
 def __init__(self, k):
  '''初始化方法
   Parameters
   -----
   k:int 邻居的个数
  '''
  self.k = k

 def fit(self,X,y):
  '''训练方法
   Parameters
   ----
   X : 类数组类型,形状为:[样本数量, 特征数量]
   待训练的样本特征(属性)

  y : 类数组类型,形状为: [样本数量]
   每个样本的目标值(标签)。
  '''
  #将X转换成ndarray数组
  self.X = np.asarray(X)
  self.y = np.asarray(y)

 def predict(self,X):
  """根据参数传递的样本,对样本数据进行预测。

  Parameters
  -----
  X : 类数组类型,形状为:[样本数量, 特征数量]
   待训练的样本特征(属性)

  Returns
  -----
  result : 数组类型
   预测的结果。
  """
  X = np.asarray(X)
  result = []
  # 对ndarray数组进行遍历,每次取数组中的一行。
  for x in X:
   # 对于测试集中的每一个样本,依次与训练集中的所有样本求距离。
   dis = np.sqrt(np.sum((x - self.X) ** 2, axis=1))
   ## 返回数组排序后,每个元素在原数组(排序之前的数组)中的索引。
   index = dis.argsort()
   # 进行截断,只取前k个元素。【取距离最近的k个元素的索引】
   index = index[:self.k]
   # 返回数组中每个元素出现的次数。元素必须是非负的整数。【使用weights考虑权重,权重为距离的倒数。】
   count = np.bincount(self.y[index], weights= 1 / dis[index])
   # 返回ndarray数组中,值最大的元素对应的索引。该索引就是我们判定的类别。
   # 最大元素索引,就是出现次数最多的元素。
   result.append(count.argmax())
  return np.asarray(result)
#创建KNN对象,进行训练与测试。
knn = KNN(k=3)
#进行训练
knn.fit(train_X,train_y)
#进行测试
result = knn.predict(test_X)
# display(result)
# display(test_y)
display(np.sum(result == test_y))
display(np.sum(result == test_y)/ len(result))
得出计算结果:
26 0.9629629629629629
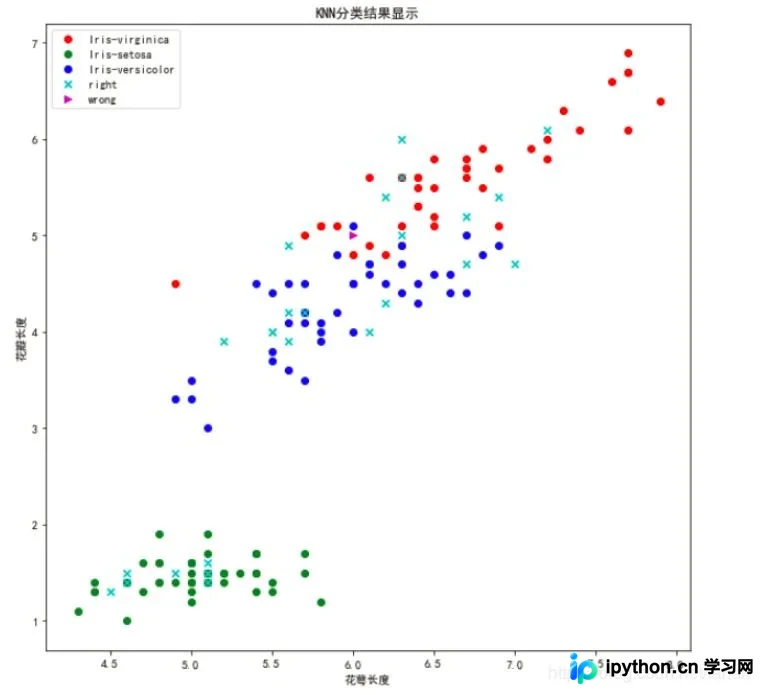
根据模型计算结果,共有26条记录与测试集标签相等,准确率达到96%。
接下来绘制散点图以直观展示分类效果:
#导入可视化所必须的库。
import matplotlib as mpl
import matplotlib.pyplot as plt
mpl.rcParams["font.family"] = "SimHei"
mpl.rcParams["axes.unicode_minus"] = False

#绘制散点图。为了能够更方便的进行可视化,这里只选择了两个维度(分别是花萼长度与花瓣长度)。
# {"Iris-virginica": 0, "Iris-setosa": 1, "Iris-versicolor": 2})
# 设置画布的大小
plt.figure(figsize=(10, 10))
# 绘制训练集数据
plt.scatter(x=t0["SepalLengthCm"][:40], y=t0["PetalLengthCm"][:40], color="r", label="Iris-virginica")
plt.scatter(x=t1["SepalLengthCm"][:40], y=t1["PetalLengthCm"][:40], color="g", label="Iris-setosa")
plt.scatter(x=t2["SepalLengthCm"][:40], y=t2["PetalLengthCm"][:40], color="b", label="Iris-versicolor")
# 绘制测试集数据
right = test_X[result == test_y]
wrong = test_X[result != test_y]
plt.scatter(x=right["SepalLengthCm"], y=right["PetalLengthCm"], color="c", marker="x", label="right")
plt.scatter(x=wrong["SepalLengthCm"], y=wrong["PetalLengthCm"], color="m", marker=">", label="wrong")
plt.xlabel("花萼长度")
plt.ylabel("花瓣长度")
plt.title("KNN分类结果显示")
plt.legend(loc="best")
plt.show()
程序运行结果如下所示:
四、思考与优化
① 尝试改变邻居的数量k值。
② 在考虑权重的情况下,修改邻居的数量。
③ 对比查看不同参数设置下结果的差异。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









