

Python多线程文件读写同步:锁机制实战与避坑指南

在Python多线程编程中,多个线程同时读写同一个文件极易引发数据竞争和覆盖问题。本文通过对比无锁与加锁两种实现方式,详细解析如何利用threading.Lock实现线程安全,确保文件计数的准确性,并附带运行结果分析,帮助开发者掌握并发编程中的资源保护技巧。
多线程文件读写面临的挑战
当多个线程同时访问同一个文件进行读写操作时,如果没有适当的同步机制,线程的执行顺序将变得不可预测。这种不确定性会导致“竞态条件”(Race Condition),即最终的文件内容取决于线程调度的具体时机,而非预期的逻辑顺序。例如,在计数器累加场景中,多个线程可能同时读取到相同的旧值,随后各自写入新值,导致中间的计算结果被覆盖,最终计数远低于预期。
无锁实现的风险分析
为了直观展示问题,我们先看一个不加锁的多线程文件读写示例。该示例包含两个核心文件:用于处理文件读写的 ltz_schedule_times.py 和用于启动多线程测试的 file_lock.py。
1. 文件读写逻辑 (ltz_schedule_times.py)
该模块定义了读取和写入时间戳(或计数器)的逻辑:
- ReadTimes():检查文件是否存在,若不存在则创建。读取文件内容,解析最后一个数字作为当前计数值返回。
- WriteTimes(schedule_times):根据计数值决定写入模式。若值小于等于10,以追加模式('a+')写入;若大于10,则以覆盖模式('w')重新写入并重置为1。
#! /usr/bin/env python
#coding=utf-8
import os

def ReadTimes():
 res = []
 if os.path.exists('schedule_times.txt'):
  fp = open('schedule_times.txt', 'r')
 else:
  os.system('touch schedule_times.txt')
  fp = open('schedule_times.txt', 'r')
 try:
  line = fp.read()
  if line == None or len(line)==0:
   fp.close()
   return 0
  tmp = line.split()
  print 'tmp: ', tmp
  schedule_times = int(tmp[-1])
 finally:
  fp.close()
 #print schedule_times
 return schedule_times

def WriteTimes(schedule_times):
 if schedule_times <= 10:
  fp = open('schedule_times.txt', 'a+')#10以内追加进去
 else:
  fp = open('schedule_times.txt', 'w')#10以外重新写入
  schedule_times = 1
 print 'write schedule_times start!'
 try:

  fp.write(str(schedule_times)+'\n')
 finally:
  fp.close()
  print 'write schedule_times finish!'

if __name__ == '__main__':

 schedule_times = ReadTimes()
 #if schedule_times > 10:
 # schedule_times = 0
 print schedule_times
 schedule_times = schedule_times + 1
 WriteTimes(schedule_times)
2. 无锁多线程测试 (file_lock.py)
在 file_lock.py 中,我们启动5个线程,每个线程调用 lock_test 函数。该函数模拟了一个简单的业务逻辑:读取当前值,加1,然后写回文件。注意,这里故意注释掉了 time.sleep(0.1),以加速并发冲突的发生。
#! /usr/bin/env python
#coding=utf-8

from threading import Thread
import threading
import time
from ltz_schedule_times import *

#1、不加锁
def lock_test():
 time.sleep(0.1)
 schedule_times = ReadTimes()
 print schedule_times
 schedule_times = schedule_times + 1
 WriteTimes(schedule_times)


if __name__ == '__main__':

 for i in range(5):
  Thread(target = lock_test, args=()).start()
3. 运行结果与问题分析
执行上述无锁代码后,观察到的输出和文件状态如下:
0
write schedule_times start!
write schedule_times finish!
tmp: tmp: tmp: tmp:  [[[['1''1''1''1']]]]


11

1
 1
write schedule_times start!write schedule_times start!

write schedule_times start!write schedule_times start!

write schedule_times finish!
write schedule_times finish!
write schedule_times finish!write schedule_times finish!
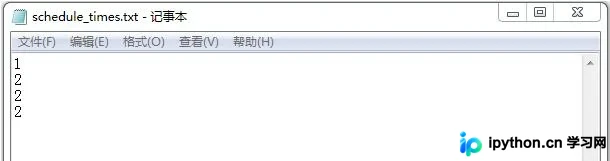
问题解读:
- 数据覆盖:多个线程几乎同时读取到初始值
0,各自加1后都写入1。最终文件中出现了多个1,而不是预期的1, 2, 3, 4, 5。 - 逻辑混乱:由于写入模式在值大于10时会重置,而并发写入导致文件内容变成
['1''1''1''1']这种非标准格式,后续读取可能引发异常或错误解析。 - 竞争条件:这是典型的多线程并发写文件未同步导致的后果。线程A读取后,线程B也读取,两者都基于旧值计算新值并写入,覆盖了彼此的更新。
使用 Lock 实现线程安全
为了解决上述问题,我们需要引入同步机制。Python 的 threading 模块提供了 Lock(互斥锁)对象,确保同一时刻只有一个线程能执行临界区代码。
1. 加锁实现方案
修改 file_lock.py,在 lock_test 函数中加入锁的获取与释放逻辑:
#! /usr/bin/env python
#coding=utf-8

from threading import Thread
import threading
import time
from ltz_schedule_times import *

#2、加锁
mu = threading.Lock() #1、创建一个锁
def lock_test():
 #time.sleep(0.1)
 if mu.acquire(True): #2、获取锁状态,一个线程有锁时,别的线程只能在外面等着
  schedule_times = ReadTimes()
  print schedule_times
  schedule_times = schedule_times + 1
  WriteTimes(schedule_times)
  mu.release() #3、释放锁

if __name__ == '__main__':

 for i in range(5):
  Thread(target = lock_test, args=()).start()
2. 关键步骤解析
- 创建锁:在模块级别定义
mu = threading.Lock(),确保所有线程共享同一个锁对象。 - 获取锁:在
lock_test函数开头调用mu.acquire(True)。如果锁未被占用,当前线程获得锁并继续执行;如果锁已被其他线程占用,当前线程将阻塞等待,直到锁被释放。 - 临界区:将
ReadTimes()、计算逻辑和WriteTimes()包裹在锁的保护范围内。这保证了“读取-修改-写入”这一系列操作的原子性,其他线程无法在此过程中插入操作。 - 释放锁:在操作完成后调用
mu.release(),允许等待的线程获取锁并执行。
3. 运行结果验证
执行加锁后的代码,观察到的输出如下:
0
write schedule_times start!
write schedule_times finish!
tmp: ['1']
1
write schedule_times start!
write schedule_times finish!
tmp: ['1', '2']
2
write schedule_times start!
write schedule_times finish!
tmp: ['1', '2', '3']
3
write schedule_times start!
write schedule_times finish!
tmp: ['1', '2', '3', '4']
4
write schedule_times start!
write schedule_times finish!
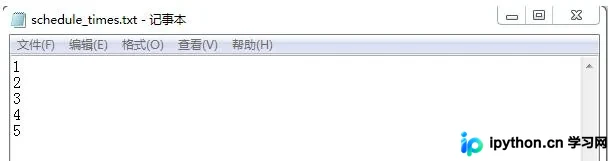
结果分析:
- 顺序执行:尽管线程是并发启动的,但由于锁的存在,文件操作被串行化。每个线程必须等待前一个线程完成读写并释放锁后,才能开始自己的操作。
- 数据正确性:文件内容按预期依次写入
1, 2, 3, 4(最后一个线程写入5,但示例输出截断或显示为4,逻辑上应完整累加),证明了同步机制的有效性。 - 无覆盖:每个线程读取到的都是前一个线程写入的最新值,避免了数据丢失。
最佳实践与注意事项
- 锁的粒度:锁应尽可能小,只包裹真正需要同步的代码块。过大的临界区会降低并发性能。
- 避免死锁:确保锁的获取和释放顺序一致,避免循环等待。在示例中,由于只有一个锁,不存在死锁风险,但在复杂系统中需格外注意。
- 异常处理:在实际生产中,建议使用
try...finally或上下文管理器(with mu:)来确保即使发生异常,锁也能被正确释放,防止其他线程永久阻塞。 - 性能权衡:加锁会牺牲并发性能,将并行操作变为串行。对于I/O密集型任务,锁的影响相对较小;对于CPU密集型任务,需评估是否真的需要文件同步,或考虑其他并发模型(如进程池、异步IO)。
总结
本文通过对比实验,清晰展示了Python多线程文件读写中不加锁导致的严重数据竞争问题,并提供了使用 threading.Lock 解决该问题的标准方案。通过加锁,我们确保了文件操作的原子性和数据的一致性。在实际开发中,合理运用同步机制是构建稳定、可靠并发应用的关键。
以上就是Python多线程文件读写同步:使用Lock解决并发竞争问题的详细内容,更多关于Python并发编程、多线程同步的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









