

Python并发编程实战:多进程、多线程与异步I/O详解

本文深入解析Python并发编程核心机制,涵盖多进程创建、多线程共享资源及锁机制,剖析GIL对多核利用的限制。通过下载文件、账户转账等实例对比单线程与并发模型的性能差异,并介绍多进程+协程的高效组合策略,帮助开发者根据计算密集或I/O密集型任务选择最优方案。
当今计算机普遍采用多CPU或多核架构,操作系统也全面支持“多任务”调度,允许用户同时运行多个程序或将单一程序拆解为多个独立子任务并发执行。这种机制不仅缩短了程序运行时间,还显著提升了用户体验。因此,掌握“并发编程”——即让程序同时执行多个任务的能力,已成为现代程序员必备的核心技能。要实现这一目标,首先需要深入理解两个基础概念:进程与线程。
概念
进程是操作系统中执行的一个程序实例。操作系统以进程为单位分配存储空间,每个进程拥有独立的地址空间、数据栈以及用于跟踪执行状态的辅助数据结构。操作系统负责管理所有进程的执行,并合理分配资源。进程可以通过fork或spawn方式创建新进程来执行其他任务,但新进程拥有独立的内存空间,因此必须通过进程间通信机制(IPC,Inter-Process Communication)来实现数据共享。常见的IPC方式包括管道、信号、套接字和共享内存区等。
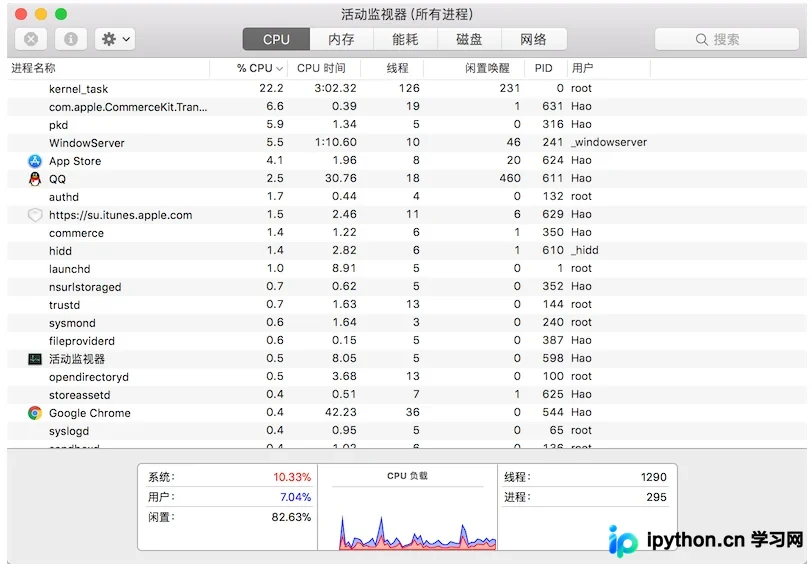
线程是进程内并发的执行线索,即拥有多个可获得CPU调度的执行单元。由于线程共享同一进程上下文,相比进程,线程间的信息共享和通信更为便捷。在单核CPU系统中,真正的并发无法实现,因为某一时刻仅有一个线程能获得CPU,多个线程需共享CPU执行时间。使用多线程实现并发编程的主要优势在于提升程序性能和改善用户体验。当前主流软件几乎都应用了多线程技术,这一点可通过系统自带的进程监控工具(如macOS的“活动监视器”或Windows的“任务管理器”)得到证实,如下图所示。
然而,多线程并非没有弊端。从其他进程的角度看,多线程程序因占用更多CPU执行时间而显得“不友好”,可能导致其他程序无法获得足够的CPU资源;从开发者角度看,编写和调试多线程程序对技术要求较高,初学者往往面临较大挑战。
Python同时支持多进程和多线程,因此实现并发编程主要有三种方式:多进程、多线程以及多进程结合多线程。
Python中的多进程
Unix和Linux操作系统提供了fork()系统调用来创建进程。调用fork()的是父进程,创建出的是子进程。子进程是父进程的拷贝,但拥有独立的PID。fork()函数具有特殊性:它返回两次,父进程通过返回值获取子进程PID,而子进程返回值始终为0。Python的os模块提供了fork()函数。由于Windows系统不支持fork调用,为实现跨平台多进程编程,可使用multiprocessing模块的Process类来创建子进程。该模块还提供了更高级的封装,例如用于批量启动进程的进程池(Pool),以及用于进程间通信的队列(Queue)和管道(Pipe)等。
以下通过一个文件下载示例,说明使用多进程与不使用多进程的差异,先查看如下代码。
from random import randint
from time import time, sleep


def download_task(filename):
 print('开始下载%s...' % filename)
 time_to_download = randint(5, 10)
 sleep(time_to_download)
 print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))


def main():
 start = time()
 download_task('Python从入门到住院.pdf')
 download_task('Peking Hot.avi')
 end = time()
 print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
 main()
以下是运行程序得到的一次运行结果。
开始下载Python从入门到住院.pdf... Python从入门到住院.pdf下载完成! 耗费了6秒 开始下载Peking Hot.avi... Peking Hot.avi下载完成! 耗费了7秒 总共耗费了13.01秒.
从上述示例可见,若代码仅按顺序执行,即使两个下载任务互不相关,也必须等待一个文件下载完成后才能开始下一个,这显然低效且不合理。接下来,我们使用多进程方式将两个下载任务分配到不同进程中,代码如下所示。
from multiprocessing import Process
from os import getpid
from random import randint
from time import time, sleep


def download_task(filename):
 print('启动下载进程,进程号[%d].' % getpid())
 print('开始下载%s...' % filename)
 time_to_download = randint(5, 10)
 sleep(time_to_download)
 print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))


def main():
 start = time()
 p1 = Process(target=download_task, args=('Python从入门到住院.pdf', ))
 p1.start()
 p2 = Process(target=download_task, args=('Peking Hot.avi', ))
 p2.start()
 p1.join()
 p2.join()
 end = time()
 print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
 main()
在上述代码中,我们通过Process类创建进程对象,通过target参数传入函数表示进程启动后执行的代码,args元组代表传递给函数的参数。Process对象的start方法用于启动进程,join方法表示等待进程执行结束。运行上述代码可明显发现两个下载任务“同时”启动,且程序执行时间大幅缩短,不再是两个任务时间的简单总和。以下是程序的一次执行结果。
启动下载进程,进程号[1530]. 开始下载Python从入门到住院.pdf... 启动下载进程,进程号[1531]. 开始下载Peking Hot.avi... Peking Hot.avi下载完成! 耗费了7秒 Python从入门到住院.pdf下载完成! 耗费了10秒 总共耗费了10.01秒.
我们也可以使用subprocess模块中的类和函数来创建和启动子进程,并通过管道与子进程通信。这些内容此处不作深入讲解,感兴趣的读者可自行查阅。接下来,我们将重点讨论如何实现两个进程间的通信。我们启动两个进程,一个输出Ping,另一个输出Pong,两个进程输出的Ping和Pong加起来一共10个。听起来简单,但若按如下方式编写则是错误的。
from multiprocessing import Process
from time import sleep

counter = 0


def sub_task(string):
 global counter
 while counter < 10:
  print(string, end='', flush=True)
  counter += 1
  sleep(0.01)


def main():
 Process(target=sub_task, args=('Ping', )).start()
 Process(target=sub_task, args=('Pong', )).start()


if __name__ == '__main__':
 main()
乍看无误,但最终结果是Ping和Pong各输出了10次。为何如此?当程序中创建进程时,子进程复制了父进程及其所有数据结构,每个子进程拥有独立的内存空间。这意味着两个子进程中各有一个counter变量,因此结果可想而知。解决此问题较简单的方法是使用multiprocessing模块中的Queue类,它是可被多个进程共享的队列,底层通过管道和信号量(semaphore)机制实现,感兴趣的读者可自行尝试。
Python中的多线程
在Python早期版本中引入了thread模块(现名为_thread)来实现多线程编程,但该模块过于底层且功能有限。目前的多线程开发推荐使用threading模块,该模块提供了更完善的面向对象封装。我们将前述下载文件的例子用多线程方式重新实现一遍。
from random import randint
from threading import Thread
from time import time, sleep


def download(filename):
 print('开始下载%s...' % filename)
 time_to_download = randint(5, 10)
 sleep(time_to_download)
 print('%s下载完成! 耗费了%d秒' % (filename, time_to_download))


def main():
 start = time()
 t1 = Thread(target=download, args=('Python从入门到住院.pdf',))
 t1.start()
 t2 = Thread(target=download, args=('Peking Hot.avi',))
 t2.start()
 t1.join()
 t2.join()
 end = time()
 print('总共耗费了%.3f秒' % (end - start))


if __name__ == '__main__':
 main()
我们可以直接使用threading模块的Thread类来创建线程。但此前我们提及一个重要概念“继承”,即可以从已有类创建新类。因此,也可通过继承Thread类的方式创建自定义线程类,再创建线程对象并启动线程。代码如下所示。
from random import randint
from threading import Thread
from time import time, sleep


class DownloadTask(Thread):

 def __init__(self, filename):
  super().__init__()
  self._filename = filename

 def run(self):
  print('开始下载%s...' % self._filename)
  time_to_download = randint(5, 10)
  sleep(time_to_download)
  print('%s下载完成! 耗费了%d秒' % (self._filename, time_to_download))


def main():
 start = time()
 t1 = DownloadTask('Python从入门到住院.pdf')
 t1.start()
 t2 = DownloadTask('Peking Hot.avi')
 t2.start()
 t1.join()
 t2.join()
 end = time()
 print('总共耗费了%.2f秒.' % (end - start))


if __name__ == '__main__':
 main()
由于多个线程可共享进程的内存空间,实现线程间通信相对简单。最直接的方法是设置一个全局变量,多个线程共享该变量即可。但当多个线程共享同一变量(通常称为“资源”)时,可能产生不可控结果,导致程序失效甚至崩溃。若一个资源被多个线程竞争使用,通常称之为“临界资源”。对“临界资源”的访问需加上保护,否则资源会处于“混乱”状态。以下示例演示了100个线程向同一银行账户转账(转入1元钱)的场景。在此例中,银行账户即为临界资源,若无保护,我们很可能得到错误结果。
from time import sleep
from threading import Thread


class Account(object):

 def __init__(self):
  self._balance = 0

 def deposit(self, money):
  # 计算存款后的余额
  new_balance = self._balance + money
  # 模拟受理存款业务需要0.01秒的时间
  sleep(0.01)
  # 修改账户余额
  self._balance = new_balance

 @property
 def balance(self):
  return self._balance


class AddMoneyThread(Thread):

 def __init__(self, account, money):
  super().__init__()
  self._account = account
  self._money = money

 def run(self):
  self._account.deposit(self._money)


def main():
 account = Account()
 threads = []
 # 创建100个存款的线程向同一个账户中存钱
 for _ in range(100):
  t = AddMoneyThread(account, 1)
  threads.append(t)
  t.start()
 # 等所有存款的线程都执行完毕
 for t in threads:
  t.join()
 print('账户余额为: ¥%d元' % account.balance)


if __name__ == '__main__':
 main()
运行上述程序,结果令人惊讶:100个线程分别向账户转入1元钱,最终余额却远小于100元。出现这种情况是因为未对银行账户这一“临界资源”加以保护。多个线程同时向账户存钱时,会同时执行到new_balance = self._balance + money这行代码。多个线程得到的账户余额均为初始状态下的0,因此都在0的基础上+1,导致结果错误。此时,“锁”便派上用场。我们可以通过“锁”来保护“临界资源”,只有获得“锁”的线程才能访问“临界资源”,其他未获得“锁”的线程将被阻塞,直到获得“锁”的线程释放“锁”,其他线程才有机会获取“锁”并访问被保护的“临界资源”。以下代码演示了如何使用“锁”保护对银行账户的操作,从而获得正确结果。
from time import sleep
from threading import Thread, Lock


class Account(object):

 def __init__(self):
  self._balance = 0
  self._lock = Lock()

 def deposit(self, money):
  # 先获取锁才能执行后续的代码
  self._lock.acquire()
  try:
   new_balance = self._balance + money
   sleep(0.01)
   self._balance = new_balance
  finally:
   # 在finally中执行释放锁的操作保证正常异常锁都能释放
   self._lock.release()

 @property
 def balance(self):
  return self._balance


class AddMoneyThread(Thread):

 def __init__(self, account, money):
  super().__init__()
  self._account = account
  self._money = money

 def run(self):
  self._account.deposit(self._money)


def main():
 account = Account()
 threads = []
 for _ in range(100):
  t = AddMoneyThread(account, 1)
  threads.append(t)
  t.start()
 for t in threads:
  t.join()
 print('账户余额为: ¥%d元' % account.balance)


if __name__ == '__main__':
 main()
遗憾的是,Python的多线程并不能充分发挥CPU的多核特性。这一点可通过启动几个执行死循环的线程得到证实。原因在于Python解释器存在“全局解释器锁”(GIL)。任何线程执行前必须先获得GIL锁,每执行100条字节码,解释器便自动释放GIL锁,让其他线程有机会执行。这是历史遗留问题,但即便如此,如前例所示,使用多线程在提升执行效率和改善用户体验方面仍具有积极意义。
多进程还是多线程
无论是多进程还是多线程,一旦数量过多,效率必然下降。打个比方:假设你正在准备中考,每晚需完成语文、数学、英语、物理、化学5科作业,每科耗时1小时。若先花1小时做语文,再做数学,依次完成,共耗时5小时,此为单任务模型。若切换至多任务模型,先做1分钟语文,再切换至数学,做1分钟,再切换至英语,依此类推。只要切换速度足够快,这种方式便与单核CPU执行多任务无异。以旁观者视角看,你似乎正在同时写5科作业。
然而,切换作业是有代价的。例如从语文切到数学,需先收拾桌上的语文书本、钢笔(称为保存现场),然后打开数学课本、找出圆规直尺(称为准备新环境),才能开始做数学作业。操作系统在切换进程或线程时同理,需先保存当前执行的现场环境(CPU寄存器状态、内存页等),然后准备新任务的执行环境(恢复上次的寄存器状态,切换内存页等),才能开始执行。此切换过程虽快,但仍需耗费时间。若有几千个任务同时进行,操作系统可能主要忙于切换任务,无暇执行任务,常见现象是硬盘狂响、窗口无响应、系统假死。因此,多任务一旦超过限度,反而会导致系统性能急剧下降,最终所有任务都无法完成。
是否采用多任务的第二点考虑是任务类型,可分为计算密集型和I/O密集型。计算密集型任务特点为进行大量计算,消耗CPU资源,如视频编码解码或格式转换等。此类任务完全依赖CPU运算能力,虽可用多任务完成,但任务越多,花在任务切换的时间就越多,CPU执行任务的效率越低。计算密集型任务因主要消耗CPU资源,用Python这类脚本语言执行效率通常较低,最能胜任此类任务的是C语言。此前我们提到Python中嵌入了C/C++代码的机制。
除计算密集型任务外,涉及网络、存储介质I/O的任务均可视为I/O密集型任务。此类任务特点是CPU消耗极少,大部分时间都在等待I/O操作完成(因I/O速度远低于CPU和内存速度)。对于I/O密集型任务,若启动多任务,可减少I/O等待时间,从而使CPU高效运转。大量任务属于I/O密集型,包括我们即将涉及的网络应用和Web应用。
说明: 上述内容和示例源自廖雪峰官方网站的《Python教程》。因对原文部分观点持有不同看法,对文字描述进行了适当调整。
单线程+异步I/O
现代操作系统对I/O操作改进中最为重要的便是支持异步I/O。若充分利用操作系统提供的异步I/O支持,可用单进程单线程模型执行多任务,这种全新模型称为事件驱动模型。Nginx便是支持异步I/O的Web服务器,它在单核CPU上采用单进程模型即可高效支持多任务。在多核CPU上,可运行多个进程(数量与CPU核心数相同),充分利用多核CPU。用Node.js开发的服务器端程序也采用了此工作模式,这也是当下实现多任务编程的一种趋势。
在Python语言中,单线程+异步I/O的编程模型称为协程。有了协程支持,即可基于事件驱动编写高效的多任务程序。协程最大优势在于极高的执行效率,因子程序切换非线程切换,而是由程序自身控制,故无线程切换开销。协程第二优势在于无需多线程的锁机制,因仅有一个线程,也不存在同时写变量冲突。在协程中控制共享资源无需加锁,只需判断状态即可,故执行效率远高于多线程。若想充分利用CPU的多核特性,最简单的方法是多进程+协程,既充分利用多核,又发挥协程的高效率,可获得极高性能。关于此部分内容,稍后将做专题讲解。
应用案例
示例1:将耗时任务放入线程中以获得更佳用户体验。 如下所示界面中,有“下载”和“关于”两个按钮。用休眠方式模拟点击“下载”按钮会联网下载文件,需耗时10秒。若不使用“多线程”,点击“下载”按钮后,整个程序其他部分将被耗时任务阻塞而无法执行,这显然是极差的用户体验,代码如下所示。
import time
import tkinter
import tkinter.messagebox


def download():
 # 模拟下载任务需要花费10秒钟时间
 time.sleep(10)
 tkinter.messagebox.showinfo('提示', '下载完成!')


def show_about():
 tkinter.messagebox.showinfo('关于', '作者: 骆昊(v1.0)')


def main():
 top = tkinter.Tk()
 top.title('单线程')
 top.geometry('200x150')
 top.wm_attributes('-topmost', True)

 panel = tkinter.Frame(top)
 button1 = tkinter.Button(panel, text='下载', command=download)
 button1.pack(side='left')
 button2 = tkinter.Button(panel, text='关于', command=show_about)
 button2.pack(side='right')
 panel.pack(side='bottom')

 tkinter.mainloop()


if __name__ == '__main__':
 main()
若使用多线程将耗时任务放入独立线程中执行,则不会因执行耗时任务而阻塞主线程。修改后的代码如下所示。
import time
import tkinter
import tkinter.messagebox
from threading import Thread


def main():

 class DownloadTaskHandler(Thread):

  def run(self):
   time.sleep(10)
   tkinter.messagebox.showinfo('提示', '下载完成!')
   # 启用下载按钮
   button1.config(state=tkinter.NORMAL)

 def download():
  # 禁用下载按钮
  button1.config(state=tkinter.DISABLED)
  # 通过daemon参数将线程设置为守护线程(主程序退出就不再保留执行)
  # 在线程中处理耗时间的下载任务
  DownloadTaskHandler(daemon=True).start()

 def show_about():
  tkinter.messagebox.showinfo('关于', '作者: 骆昊(v1.0)')

 top = tkinter.Tk()
 top.title('单线程')
 top.geometry('200x150')
 top.wm_attributes('-topmost', 1)

 panel = tkinter.Frame(top)
 button1 = tkinter.Button(panel, text='下载', command=download)
 button1.pack(side='left')
 button2 = tkinter.Button(panel, text='关于', command=show_about)
 button2.pack(side='right')
 panel.pack(side='bottom')

 tkinter.mainloop()


if __name__ == '__main__':
 main()
示例2:使用多进程对复杂任务进行“分而治之”。
我们来完成1至100000000求和的计算密集型任务。此问题本身简单,具备循环知识即可解决,代码如下所示。
from time import time


def main():
 total = 0
 number_list = [x for x in range(1, 100000001)]
 start = time()
 for number in number_list:
  total += number
 print(total)
 end = time()
 print('Execution time: %.3fs' % (end - start))


if __name__ == '__main__':
 main()
在上述代码中,我故意先创建了一个列表容器并填入100000000个数,此步骤较为耗时。为公平起见,当我们将此任务分解至8个进程中执行时,暂不考虑列表切片操作花费的时间,仅统计运算和合并运算结果的时间,代码如下所示。
from multiprocessing import Process, Queue
from random import randint
from time import time


def task_handler(curr_list, result_queue):
 total = 0
 for number in curr_list:
  total += number
 result_queue.put(total)


def main():
 processes = []
 number_list = [x for x in range(1, 100000001)]
 result_queue = Queue()
 index = 0
 # 启动8个进程将数据切片后进行运算
 for _ in range(8):
  p = Process(target=task_handler,
     args=(number_list[index:index + 12500000], result_queue))
  index += 12500000
  processes.append(p)
  p.start()
 # 开始记录所有进程执行完成花费的时间
 start = time()
 for p in processes:
  p.join()
 # 合并执行结果
 total = 0
 while not result_queue.empty():
  total += result_queue.get()
 print(total)
 end = time()
 print('Execution time: ', (end - start), 's', sep='')


if __name__ == '__main__':
 main()
比较两段代码的执行结果(在我目前使用的MacBook上,上述代码需约6秒左右时间,而下方代码仅需不到1秒时间,再次强调,我们仅比较运算时间,不考虑列表创建及切片操作花费的时间)。使用多进程后,因获得更多CPU执行时间并更好利用CPU多核特性,明显减少了程序执行时间,且计算量越大效果越显著。当然,若愿意,还可将多个进程部署在不同计算机上,做成分布式进程。具体做法是通过multiprocessing.managers模块中提供的管理器将Queue对象通过网络共享出来(注册到网络上让其他计算机可访问),这部分内容留待爬虫专题再行讲解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









