

Python怎么使用range()控制循环执行指定次数

for 循环与内置函数 range(),编写为 for _ in range(N): 或 for i in range(N):。range(N) 会生成一个从 0 开始、到 N - 1 结束的不可变整数序列,驱动循环按序迭代恰好 N 次。若循环体内无需使用索引计数值,推荐使用单下划线 _ 占位;若需感知当前轮次,则使用循环变量 i。
一、核心机制:range() 如何精确驱动循环计次
与 C、Java 等语言中使用 for (int i = 0; i < n; i++) 显式维护计数器变量的语法不同,Python 的 for 循环本质上是一个迭代器驱动机制。它通过依次从可迭代对象中取出元素来推进循环轮次,直到所有元素耗尽时正常结束。
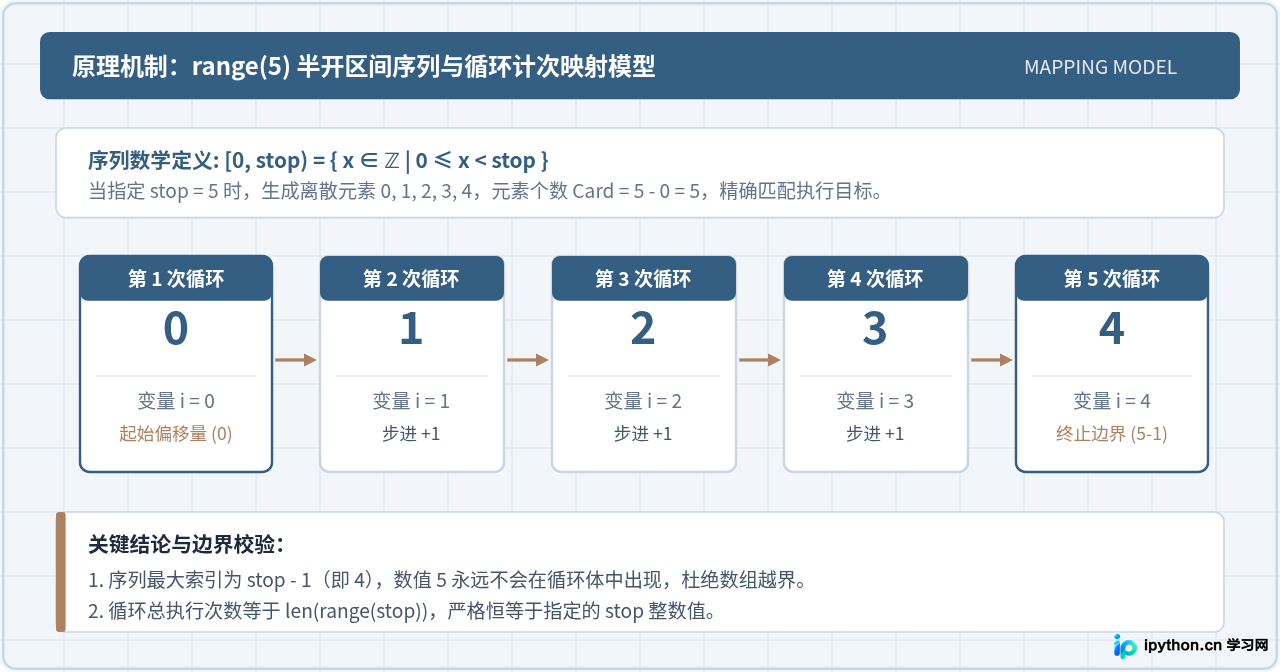
内置函数 range() 的单参数调用形式为 range(stop)。传入整数 stop 时,该函数表示生成半开区间 [0, stop) 内的所有连续整数。因为区间从 0 起步,且严格小于 stop,其包含的整数总个数恰好为 stop。这意味着将 range(stop) 置于 for 循环头部时,循环体将被执行恰好 stop 次。
# 示例 1:执行指定次数的纯操作(使用 _ 占位)
total_runs = 5
for _ in range(total_runs):
    print("正在执行心跳检测...")

# 示例 2:使用变量 i 感知当前迭代序号(0 到 4)
for i in range(5):
    print(f"当前索引为: {i},对应第 {i + 1} 次运行")
在上述示例中,range(5) 依次提供数值 0、1、2、3、4。每次取出一个数值赋给循环变量,循环体执行一次,总计执行 5 次。下方图示详细解析了 range(N) 左闭右开区间与循环迭代周期的严密映射关系。
二、标准操作步骤:构建稳定计次循环的四步流程
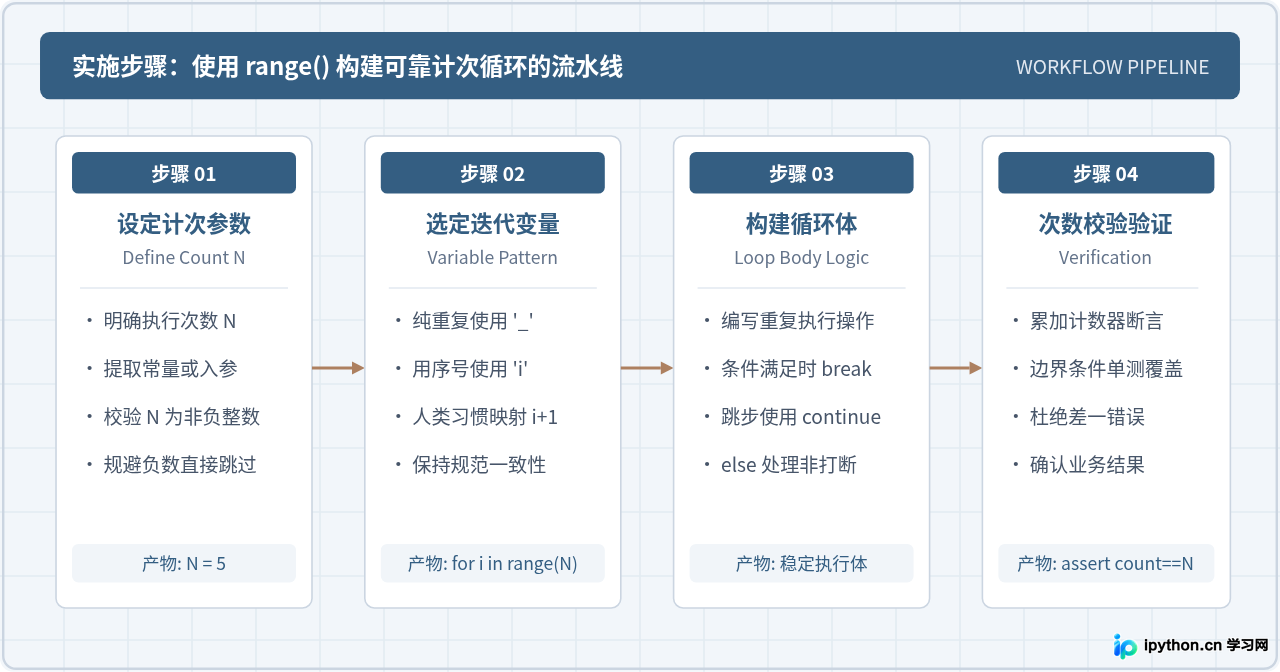
在实际工程开发中,使用 range() 控制指定次数循环不仅仅是写下一行代码,还需要根据业务场景明确边界条件、合理声明循环变量、控制异常流程并做好验证。推荐遵循以下四个标准步骤:
步骤 1:明确目标执行次数与边界参数
确定程序需要重复的绝对次数。通常建议将该数值提取为语义明确的常量或配置变量(如 MAX_RETRIES = 3 或 BATCH_COUNT = 10),而不是在代码中直接硬编码魔数。如果参数来自外部输入,需先验证其为非负整数;若传入小于或等于 0 的整数,range() 会生成空序列,循环体将直接跳过不执行。
步骤 2:选择合适的循环变量命名模式
根据循环体内是否需要读取计数值,选择变量声明风格:
- 无须索引:使用单下划线
_占位,例如for _ in range(count):。这是 Python 社区通用的代码规范,明确向代码审查者表达“本循环只关注重复频次,不关心当前是第几项”。 - 依赖索引:使用标准变量名
i、idx或step,例如for i in range(count):。需要注意i的范围是从 0 开始的。若面向用户界面输出日志,通常使用i + 1表示符合日常习惯的“第 N 轮”。
步骤 3:编写循环体逻辑与流程控制
编写需要在每次迭代中执行的具体动作。当遇到特定业务条件需要提前中断全部循环时使用 break;当需要跳过当前轮次剩余代码并立即进入下一轮计次时使用 continue。结合 else 子句,可以在循环未被 break 打断、正常跑满指定次数后执行兜底处理。
步骤 4:验证执行次数与边界测试
在单元测试或调试阶段,通过计数器累加或断言确认循环的实际执行次数与预期严格一致,防止因逻辑跳出或边界计算偏差导致少执行或多执行一次。
# 完整工程示例:带上限的接口重试机制
import time

MAX_RETRIES = 3
success = False

for attempt in range(MAX_RETRIES):
    current_round = attempt + 1
    print(f"[发起请求] 尝试第 {current_round}/{MAX_RETRIES} 次调用服务...")

    # 模拟网络调用或核心处理逻辑
    try:
        # 此处执行实际操作
        if current_round == 2:  # 假设第2次成功
            print("[请求成功] 数据已正确返回。")
            success = True
            break
    except Exception as err:
        print(f"[请求异常] 第 {current_round} 次出现错误: {err}")

    if current_round < MAX_RETRIES:
        time.sleep(1)  # 轮次间退避等待
else:
    if not success:
        print(f"[最终告警] 已达到最大重试次数 {MAX_RETRIES},操作宣告失败。")
下面通过流水线图展示从确定参数到验证循环完成的工程构建顺序:
三、多参数进阶:自定义起始值、步长与倒序计次
除了最常用的 range(stop) 形式,range() 还支持接收两个或三个参数。利用这些重载形式,可以在控制循环执行固定次数的同时,直接获得符合特定规律的数值序列,避免在循环体内额外进行数学计算。
1. 双参数模式:range(start, stop)
当传入两个参数时,第一个参数为起始值 start,第二个参数为终止边界 stop。生成的序列区间为 [start, stop),步长默认固定为 1。其总循环次数可通过下式计算:
循环次数 = max(0, stop - start)
例如,若需要执行 10 次循环,且希望索引直接对应 1 到 10 的轮次,可以直接写为 for round_num in range(1, 11):。此时 stop - start = 11 - 1 = 10,循环次数恰好为 10 次,且 round_num 在循环体内直接从 1 递增至 10。
2. 三参数模式:range(start, stop, step)
第三个参数 step 用于指定步进跨度。step 不能为 0(否则会抛出 ValueError: range() arg 3 must not be zero)。当给定正步长或负步长时,其执行次数的通用数学公式为:
循环次数 = max(0, ⌈ (stop - start) / step ⌉)
- 正步长跳跃:例如
range(0, 10, 2)生成[0, 2, 4, 6, 8],总次数为(10 - 0) / 2 = 5次。 - 负步长递减(倒计次):例如在倒计时任务中,希望从 5 倒数到 1,共执行 5 次,应写作
range(5, 0, -1)。此时start=5,stop=0,step=-1,生成的数值为 5、4、3、2、1,总次数同样为 5 次。
# 场景:倒计时 5 秒执行
import time

print("开始发射倒计时:")
for remaining in range(5, 0, -1):
    print(f"倒计时: {remaining} 秒...")
    time.sleep(1)
print("点火启动!")
下表汇总了 range() 的三种调用形式、参数约束、循环次数计算公式以及适用场景:
| 调用形式 | 参数说明 | 生成区间 | 执行次数计算公式 | 典型应用场景 |
|---|---|---|---|---|
range(stop) |
终止边界(默认起始 0,步长 1) | [0, stop) |
max(0, stop) |
固定频次重复、数组下标遍历 |
range(start, stop) |
起始值、终止边界(默认步长 1) | [start, stop) |
max(0, stop - start) |
自定义起始序号(如 1 到 N)、区间分片 |
range(start, stop, step) |
起始值、终止边界、步长(正或负) | 离散等差数列 | max(0, ⌈(stop - start) / step⌉) |
跳步抽样、倒计时循环、批量分块批处理 |
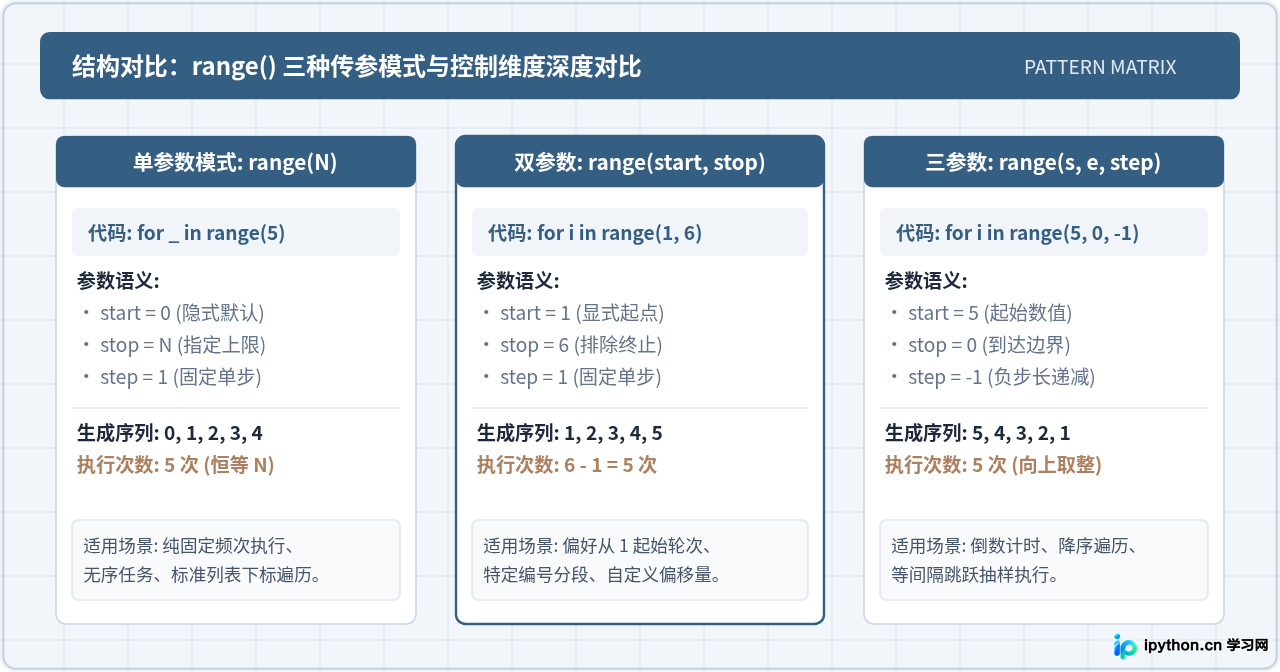
为了更清晰地理解三种模式在内存与时序上的差异,下图展示了三种调用模式的结构对比:
四、常见误区排查与性能底层机制
在编写计次循环时,开发者常因对 range() 的底层设计理解不透彻而引入隐蔽 Bug。以下剖析三个高频误区,并解释其内存运行机制。
误区 1:边界误判导致的“差一错误”(Off-by-one Error)
初学者常直觉性地认为 range(1, 10) 会执行 10 次。但根据数学定义,该序列为 [1, 10),实际产生的元素为 1 到 9,共仅执行 9 次。如果需要让序号从 1 开始且精确执行 10 次,终止边界必须设置为 1 + 10 = 11,即 range(1, 11)。
误区 2:在循环体内试图修改循环变量以改变执行次数
在部分语言中,手动修改计数器(如 i += 2)可以实现动态跳步。但在 Python 中,for i in range(5): 的工作原理是:在每一次迭代开始时,Python 解释器会自动从 range 迭代器中取出下一个预定元素强行赋值给 i。如果在循环体内部执行 i = 100,该赋值仅在当前轮次的剩余代码中生效;进入下一轮迭代时,i 会立即被迭代器中的下一个正常值(例如 1 或 2)覆盖。修改 i 不会减少也不会增加循环的总执行次数。
# 错误尝试:在循环内修改变量不会改变循环次数
for i in range(3):
    print(f"进入循环,i={i}")
    i = 999  # 手动修改变量
    print(f"修改后,i={i}")
# 运行输出:
# 进入循环,i=0 -> 修改后,i=999
# 进入循环,i=1 -> 修改后,i=999
# 进入循环,i=2 -> 修改后,i=999
# 结论:循环依然严格执行了 3 次!
误区 3:参数方向矛盾导致循环直接不执行
当 start > stop 但 step 保持默认的正数 1 时(例如 range(5, 0)),由于无法通过正向累加从 5 达到小于 0 的目标,range 会判定序列为空,返回长度为 0 的对象。此时循环体一次都不会执行,且解释器不会报错。这往往会导致逻辑被悄无声息地跳过。
range() 会在内存中直接构建一个完整的 list 列表,大数值会导致严重的内存消耗。但在 Python 3 中,range 是一个专门的不可变序列类型(Sequence Type)。它在内存中仅存储 start、stop 和 step 三个整数属性。无论计次是 10 次还是 10 亿次,它占用的内存空间都是恒定的 O(1)(通常仅几十字节),并在每次迭代时通过公式动态计算出当前数值。因此无须担心使用超大计次会引起内存溢出。
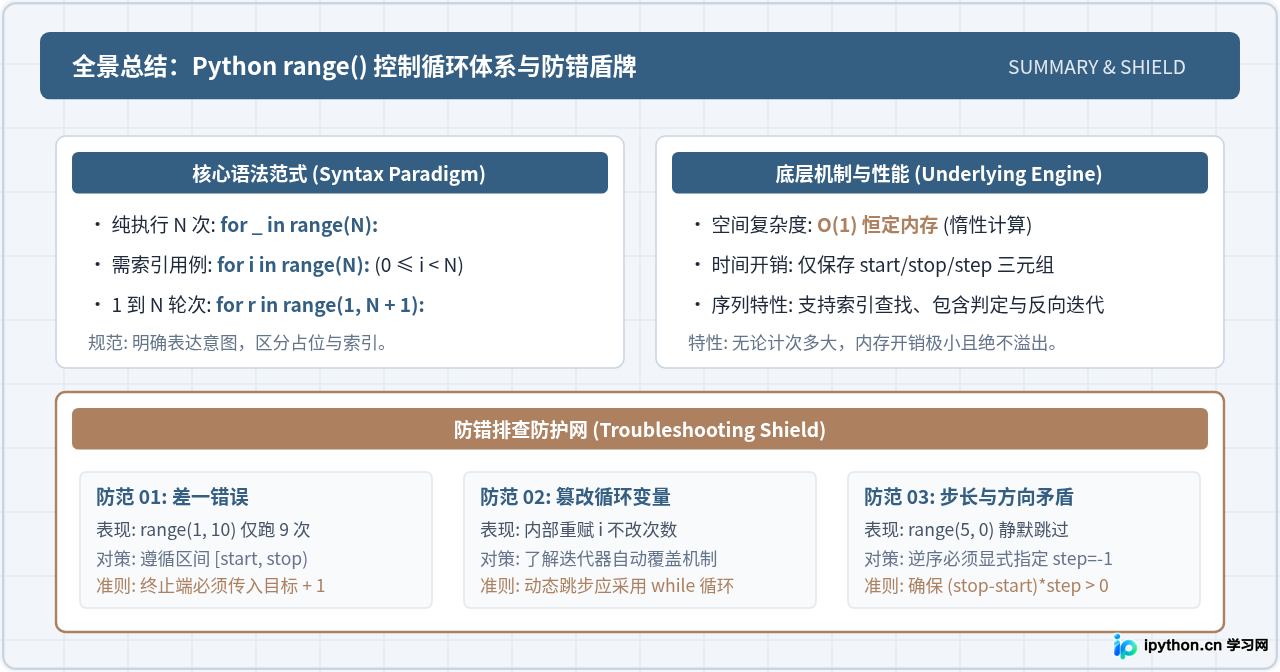
下方知识总结图梳理了使用 range() 控制指定循环次数的完整核心要素与防错指南:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









