

Python3.14的t-strings模板字符串能怎么用在数据处理?

深入解析Python 3.14引入的t-strings(PEP 750模板字符串)机制,以及它如何在数据处理领域解决动态SQL构建、ETL多维结构化日志、安全DSL解析与数据报表转义等实际工程问题。
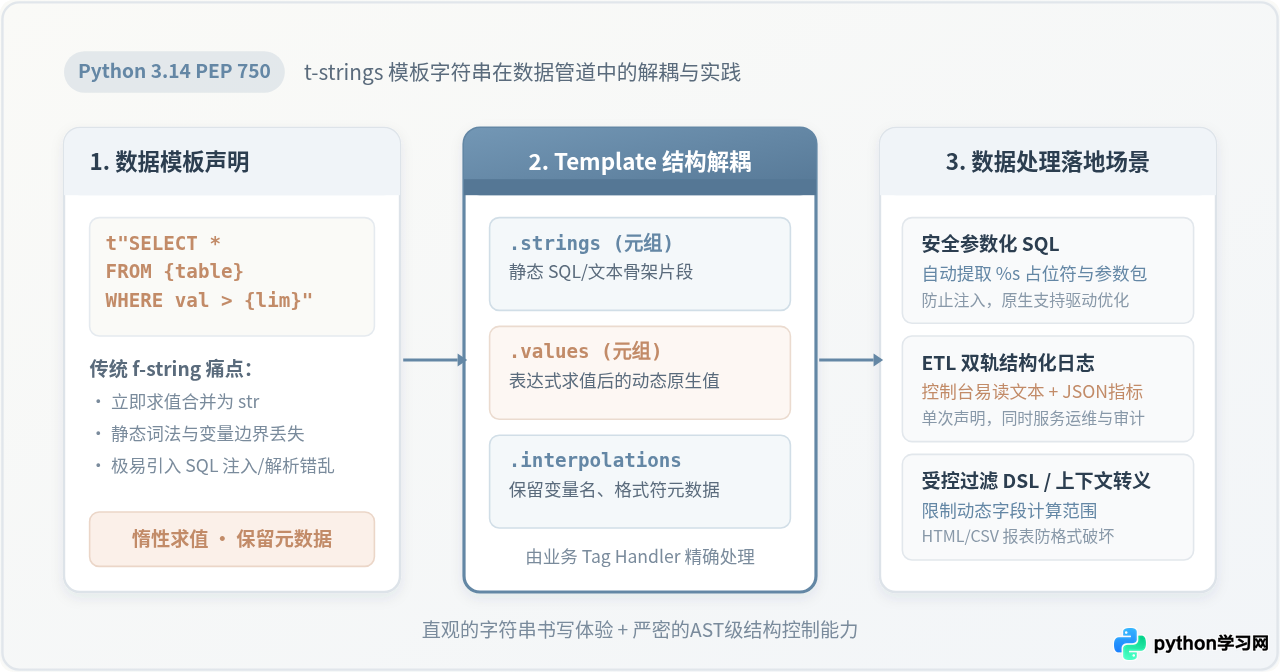
在 Python 3.14 中,PEP 750 正式引入了 t-strings(模板字符串)。不同于传统 f-strings 将表达式直接合并为普通文本,t-strings 会在运行时将字面量解析为一个保留静态语法片段与动态求值实参的 Template 结构化对象。在数据处理领域,这一设计直接击中了数据清洗、动态 SQL 拼接、ETL 流水线日志记录与表达式安全求值的长期痛点,让开发者既能享受类似 f-string 的自然编写体验,又能从底层彻底消除数据注入隐患与元数据丢失问题。
一、为什么数据处理场景急需 t-strings?
在日常的数据处理和清洗工作中,我们经常需要把动态变量组装到某种语法结构中,比如构造数据库查询条件、编写分布式计算过滤语句、格式化清洗日志或导出为特定格式的文件。长期以来,Python 开发者最常使用的工具是 f-strings。
f-strings 虽然书写简洁,但在处理外部数据时存在一个致命缺陷:立即求值(Eager Evaluation)与类型抹平。一旦 f"..." 执行完毕,Python 解释器就会将其立即渲染为一个不可逆的普通 str 对象。原本具有清晰边界的“静态模板结构”与“动态数据内容”混成了一体。
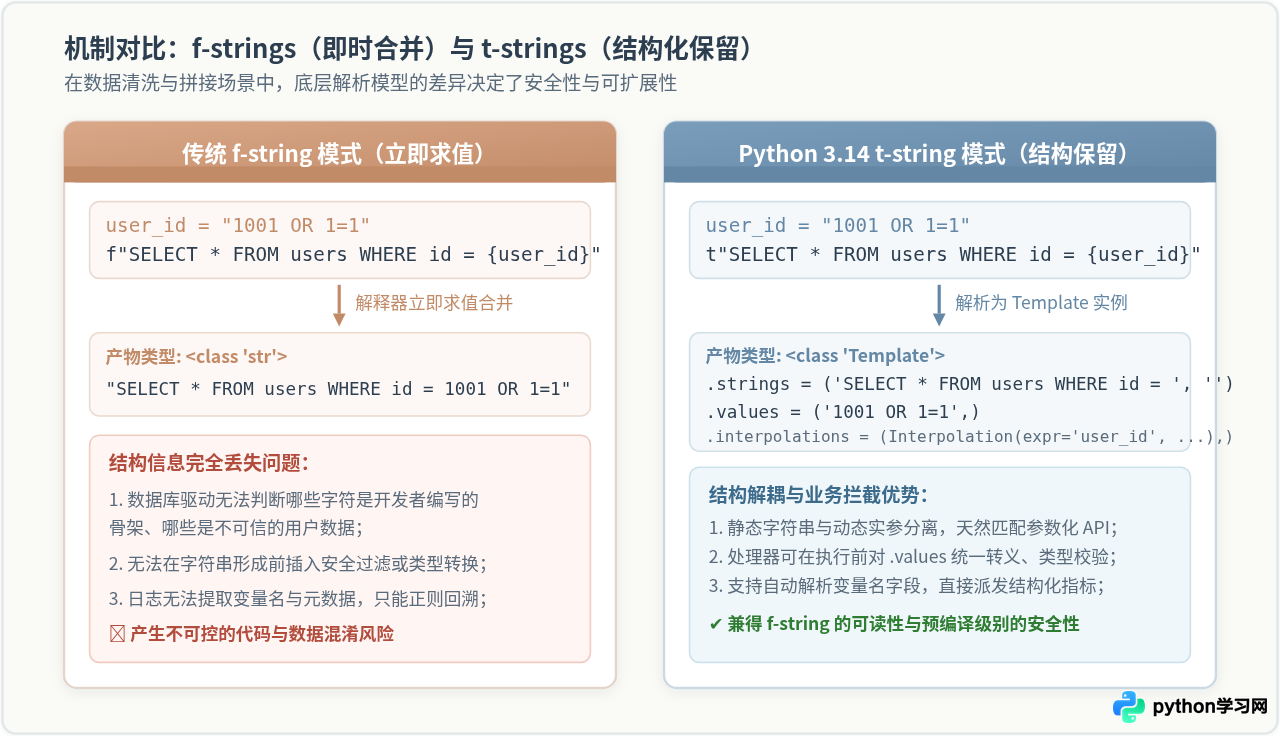
正如上图所示,当不可信数据混入普通字符串后,下游的数据库驱动、日志收集器或解析引擎根本无法分辨哪些字符是开发人员编写的业务逻辑,哪些是外部传入的脏数据或恶意指令。为了解决这个问题,以往必须依赖重型的 ORM、繁琐的参数占位符元组,或是第三方的模板解析引擎。
Python 3.14 的 t-strings 则给出了原生解法。前缀带有 t 的字符串(如 t"SELECT * FROM sales WHERE id = {val}")不会直接生成 str,而是返回 Template 实例。该实例暴露出三个核心属性:
.strings:包含静态文本片段的元组,存储着模板骨架;.values:包含花括号内表达式计算后实际值的元组,保留了原始数据类型(如int、datetime、list);.interpolations:包含每一个插值位置的元数据(如原始表达式字面量、格式化说明符与转换标志)。
二、场景一:安全构建动态 SQL 与数据库提取清洗
在批量数据提取(ELT/ETL)中,根据批次时间戳、分表名称或用户筛选条件动态构建 SQL 是最基础的操作。很多数据开发者为了图方便,直接使用 f-strings 拼接 SQL,这常常导致恶性的 SQL 注入事故;而标准库提供的 cursor.execute(sql, params) 虽然安全,但在字段繁多时,位置占位符 %s 极易与后方的参数元组顺序错位。
利用 t-strings,我们可以编写一个轻量的 SQL 标签处理器(Tag Handler),在保留变量内联编写体验的同时,自动提取占位符与独立参数元组。
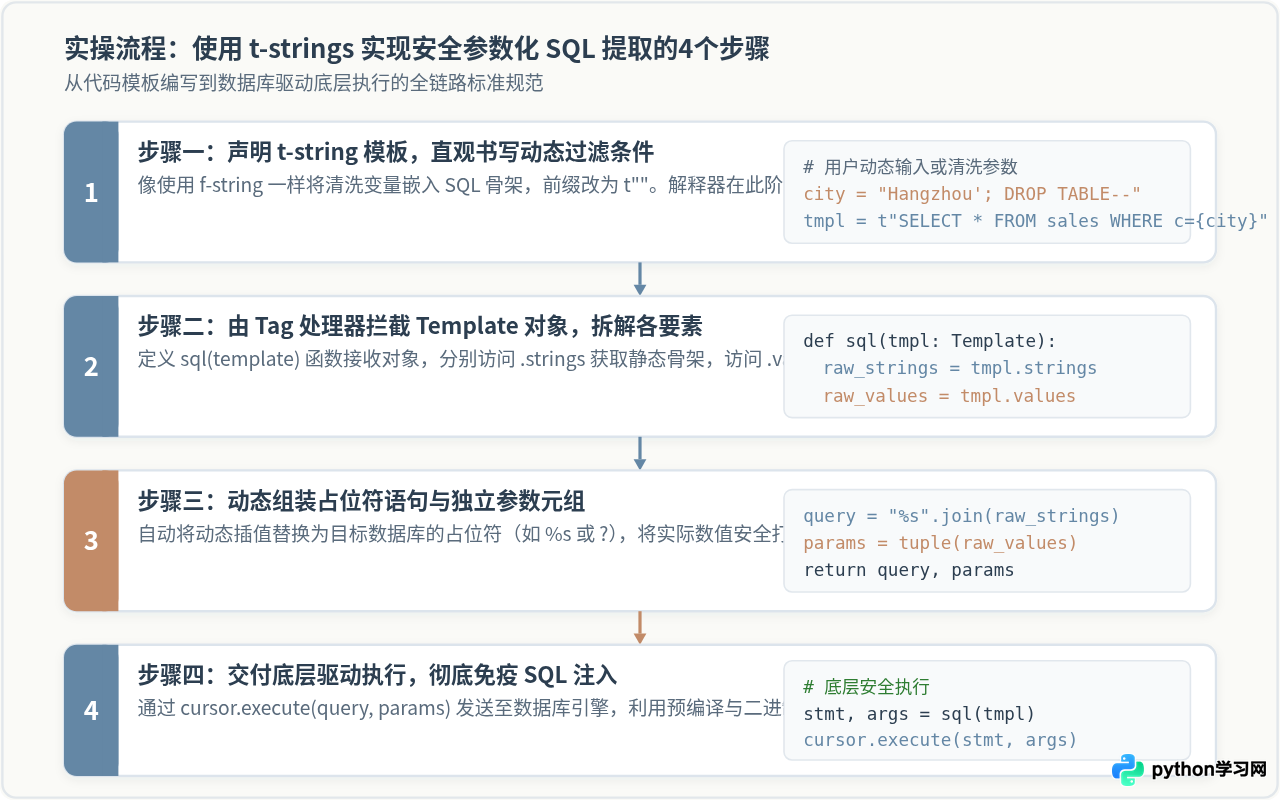
代码实现:SQL 参数化处理器
# Python 3.14 示例:动态 SQL 安全提取处理器
from string.templatelib import Template

def sql(template: Template) -> tuple[str, tuple]:
    """
    将 t-string 解析为参数化查询语句与安全的参数元组
    """
    # 使用 %s 占位符将静态字符串片段拼接
    query = "%s".join(template.strings)
    # 提取求值后的动态变量,保持原始数据类型
    params = tuple(template.values)
    return query, params

# 模拟含有特殊字符或恶意注入的数据清洗变量
user_city = "Hangzhou'; DROP TABLE sales_report; --"
min_amount = 5000

# 步骤 1:直观编写模板,如同使用 f-string
query_template = t"SELECT order_id, amount FROM orders WHERE city = {user_city} AND amount >= {min_amount}"

# 步骤 2:通过处理器拆解
safe_query, query_params = sql(query_template)

# 打印处理结果
print("安全参数化语句:", safe_query)
print("参数化实参包:", query_params)
安全参数化语句: SELECT order_id, amount FROM orders WHERE city = %s AND amount >= %s参数化实参包: ("Hangzhou'; DROP TABLE sales_report; --", 5000)
原因解释:
可以看到,恶意字符串被完整隔离在 query_params 中,送入 cursor.execute(safe_query, query_params) 时,底层数据库引擎会将其严格作为纯字面量参数绑定处理,而绝不会将其中的 DROP TABLE 识别为 SQL 指令。同时,数值 5000 保留了整型类型,无需手动进行类型转换或转义。
三、场景二:ETL 流程中的统一双轨日志与数据审计
在生产级数据流水线中,日志记录往往有相互冲突的诉求:运维工程师需要在终端或控制台看到排版整齐、直观的人类可读日志;而下游的 APM 系统、Elasticsearch 或 ClickHouse 审计系统则要求输出纯净的结构化键值(JSON 格式),且要求保留原始整型、浮点型字段以供聚合指标计算。
传统做法要么是在代码里调用两次日志接口,要么使用复杂的正则去二次提取日志中的数值。在 Python 3.14 中,t-strings 使得单一模板能够同时派生出控制台易读文本与机器结构化数据。
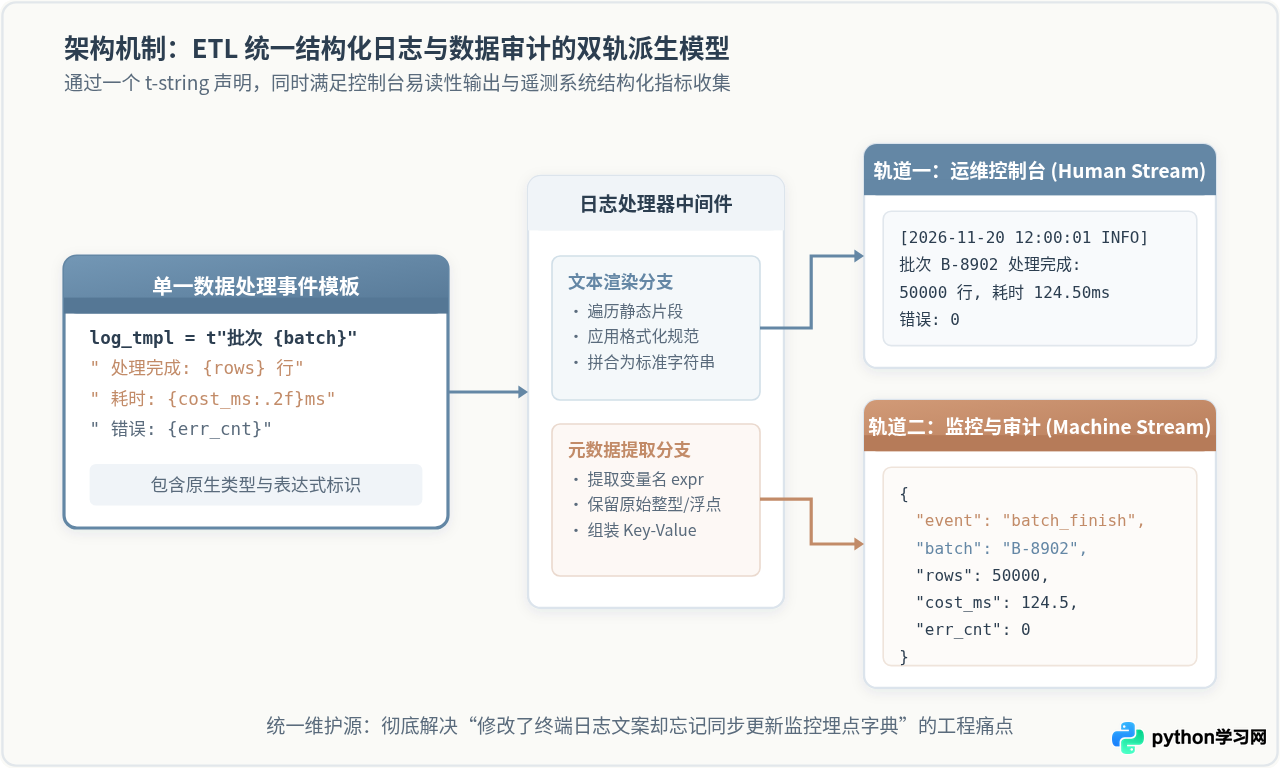
代码实现:双轨审计日志处理器
# Python 3.14 示例:统一双轨日志处理器
from string.templatelib import Template
import json

class AuditLogger:
    @staticmethod
    def emit(template: Template, event_name: str = "pipeline_event") -> dict:
        # 1. 组装人类可读文本
        rendered_text = "".join(
            f"{s}{v}" for s, v in zip(template.strings, template.values)
        ) + template.strings[-1]

        # 2. 从 interpolations 提取原始变量名与类型化数值
        metrics = {"event": event_name}
        for interp, val in zip(template.interpolations, template.values):
            # interp.expression 对应花括号内部编写的变量名称
            field_name = interp.expression.strip()
            metrics[field_name] = val

        # 控制台输出易读日志
        print(f"[CONSOLE LOG] {rendered_text}")
        # 审计系统消费结构化 JSON
        print(f"[METRIC JSON] {json.dumps(metrics, ensure_ascii=False)}")
        return metrics

# 数据处理批次执行场景
batch_id = "B-20261120-09"
processed_rows = 150000
cost_seconds = 3.42
error_count = 0

# 仅需书写一次 t-string
log_tmpl = t"数据批次 {batch_id} 处理完成: 包含 {processed_rows} 行, 耗时 {cost_seconds} 秒, 异常量 {error_count}"
audit_data = AuditLogger.emit(log_tmpl, event_name="batch_etl_success")
int/float,无须再次转换。
四、场景三:动态过滤规则与轻量受控 DSL 表达式计算
在面向报表配置或规则引擎的数据处理任务中,我们经常需要允许运营或上游规则传入动态计算条件,例如 age > 18 and score >= 90。
如果直接使用 Python 的 eval() 执行拼接后的字符串,会引发严重的远程代码执行(RCE)漏洞;如果使用第三方 AST 解析器,又会增加数十行复杂的语法树分析代码。利用 t-strings,我们可以将模板作为轻量级 DSL,直接校验被引用的变量字段是否属于允许清洗的白名单:
# 示例:通过 t-strings 实现受控的数据过滤规则
from string.templatelib import Template

ALLOWED_FIELDS = {"age", "score", "level", "vip_status"}

def validate_filter_dsl(template: Template) -> bool:
    """
    在真正执行数据过滤前,严格校验模板中引用的字段是否合法
    """
    for interp in template.interpolations:
        expr = interp.expression.strip()
        if expr not in ALLOWED_FIELDS:
            raise ValueError(f"安全违规:字段 '{expr}' 未在白名单中,禁止作为过滤键!")
    return True

# 合法的数据规则调用
age = 25
score = 88.5
rule_1 = t"{age} > 18 and {score} >= 60"
print("规则 1 校验结果:", validate_filter_dsl(rule_1))  # True

# 尝试访问系统变量或未授权属性(注入尝试)
try:
    dangerous_var = "__import__('os').system('id')"
    rule_2 = t"{dangerous_var} == 1"
    validate_filter_dsl(rule_2)
except ValueError as e:
    print("规则 2 成功拦截:", e)
通过在 template.interpolations 阶段对变量名进行前置拦截,数据处理管道获得了对表达式词法的细粒度审计能力,把外部注入风险化解在进入执行引擎之前。
五、场景四:数据报表自动化生成中的上下文敏感转义
在把数据清洗结果导出为 HTML 邮件通知、巡检报告或 CSV 文件时,如果某个字段包含特殊字符(例如公司名称含有 <script>、& 或带有英文逗号 ,),直接拼接字符串会导致排版错乱甚至 XSS 脚本执行。
传统的做法通常是引入 Jinja2 模板库,但在只需输出简单小报表的微服务或数据脚本中,Jinja2 带来了额外的依赖包和解析成本。t-strings 的标签处理器可以在拼接时自动针对动态值执行针对性转义,而保持静态 HTML 标签完好:
# 示例:HTML 报表自动化上下文转义处理器
from string.templatelib import Template
import html

def html_report(template: Template) -> str:
    """
    自动将动态插值内容进行 HTML entity 转义,保护静态标签
    """
    result = []
    for s, v in zip(template.strings, template.values):
        result.append(s)
        # 对每一个动态注入的值做安全转义
        result.append(html.escape(str(v)))
    result.append(template.strings[-1])
    return "".join(result)

# 动态待渲染数据(包含特殊符号)
client_name = "Acme Corp <alert> & Co."
abnormal_metric = "5.4% > 阈值"

# 编写报表片段
report_fragment = html_report(
    t"<tr><td>{client_name}</td><td class='warning'>{abnormal_metric}</td></tr>"
)
print("转义后安全的 HTML 片段:")
print(report_fragment)
<tr><td>Acme Corp <alert> & Co.</td><td class='warning'>5.4% > 阈值</td></tr>
静态的 <tr>、<td> 标签被原样保留,而注入的变量被自动转义为 < 和 &。整个过程零三方依赖,执行速度极快。
六、选型指南与工程最佳实践
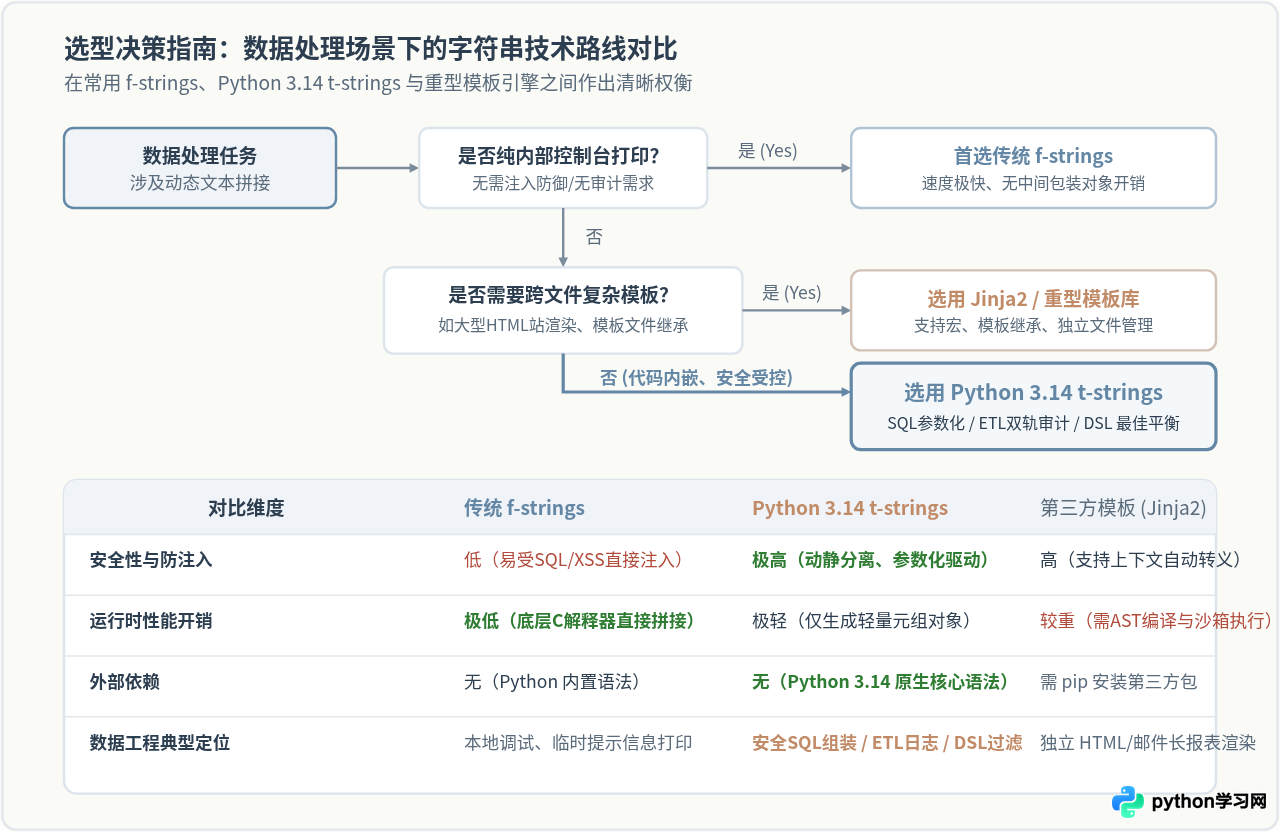
引入 t-strings 并不意味着 f-strings 将被废弃。在实际数据开发中,应根据数据来源和执行上下文合理选择字符串工具:
工程实践建议
- 本地调试与纯控制台输出仍用 f-strings:对于简单的内部
print(),不需要安全防御与结构提取,f-strings由 CPython 解释器在 C 语言层直接构建字符串,性能依然最高。 - 凡涉及外部输入与查询组装,坚决使用 t-strings:无论是编写数据库 SQL、Elasticsearch DSL 还是受控过滤表达式,凡是含有清洗参数的场景,一律使用
t-strings配合专用标签处理器。 - 避免在超高频微循环内重复创建未缓存的复杂处理器:虽然
Template对象开销极小,但在每秒处理数百万条流式记录的极高频场景中,尽量将通用的解析逻辑或 SQL 编译结果在批次层面进行复用。 - 团队沉淀通用 Tag 库:建议在团队的基础库中封装
sql()、audit_log()和safe_html()等通用处理器,使业务层代码在保持直观简洁的同时,天然具备全链路防御与可审计能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









