

pythonlambda匿名函数怎么定义
深入讲解Python中lambda匿名函数的定义语法、底层求值机制、标准def函数差异对比及高频应用场景,提供规范的工程化代码示例与避坑指南。
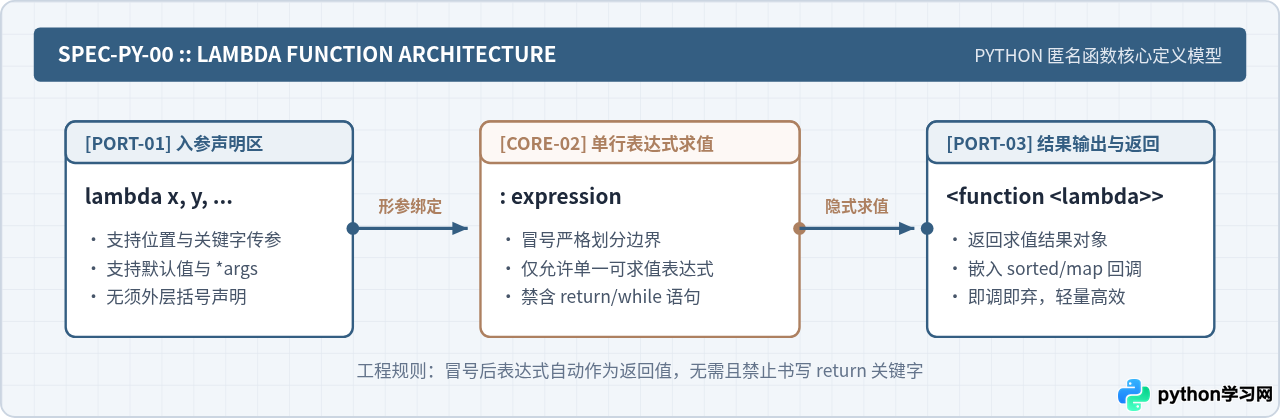
在 Python 中,定义一个匿名函数使用关键字 lambda。其基本语法结构为 lambda [参数列表]: 表达式。与常规使用 def 声明的函数不同,lambda 函数没有显式的函数名称,不需要书写代码块缩进,且冒号右侧仅允许包含一个单一表达式,该表达式的计算结果会自动作为函数的返回值。本文将详细拆解 lambda 匿名函数的定义语法、底层执行原理、工程应用场景以及核心避坑指南。
一、基本语法与要素拆解
要定义一个合法的 lambda 匿名函数,必须准确掌握其语法边界与构成要素。Python 解析器在读取到 lambda 关键字时,会在内部构造一个函数对象(类型为 types.LambdaType),并将其符号名称默认标记为 <lambda>。
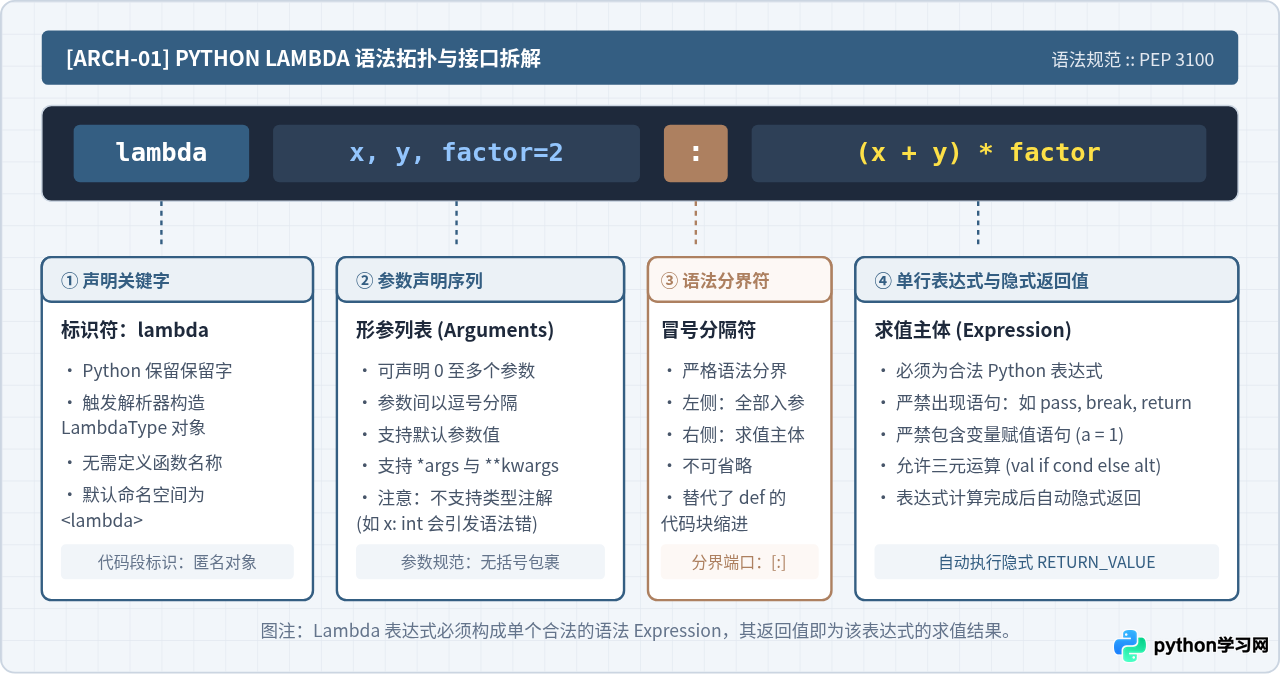
定义时各要素的具体规则如下:
- 关键字声明:以保留字
lambda开头,通知解析器开始构造匿名函数对象。 - 参数声明区:位于
lambda与冒号之间。可以不声明参数、声明单个参数,也可以声明多个参数(以逗号隔开)。支持位置参数、关键字参数、带默认值的形参以及*args与**kwargs,但不可使用类型注解(例如写lambda x: int: x * 2会抛出SyntaxError)。 - 冒号分界符:冒号
:是参数区与函数体的严格分界,起到常规函数中括号与缩进的作用。 - 单行表达式:冒号后紧随具体的计算表达式。该表达式必须可以求值,且不能包含
return、pass、assert、raise、循环或赋值等任何语句(Python 3.8+ 的海象运算符:=属于表达式,但滥用会严重破坏可读性)。计算结果将自动作为该匿名函数的返回值。
常见定义形式代码示例
在 Python 交互式环境中,可以直接定义并观察不同参数形式的 lambda 函数:
# 1. 无参数匿名函数
f_zero = lambda: "PONG"
print("无参数调用结果:", f_zero())

# 2. 单参数与多参数定义
f_double = lambda x: x * 2
f_add = lambda x, y: x + y
print("双倍结果:", f_double(5))
print("求和结果:", f_add(3, 7))

# 3. 包含默认参数与可变参数
f_poly = lambda x, scale=10, *args: x * scale + sum(args)
print("复合参数计算:", f_poly(2, 5, 1, 2, 3))双倍结果: 10
求和结果: 10
复合参数计算: 16
二、从定义到调用的四步执行流程
理解 lambda 函数如何在内存和调用栈中运作,有助于掌握其即时求值与生命周期特性。一个完整的 lambda 函数从定义到执行通常经历四个阶段:
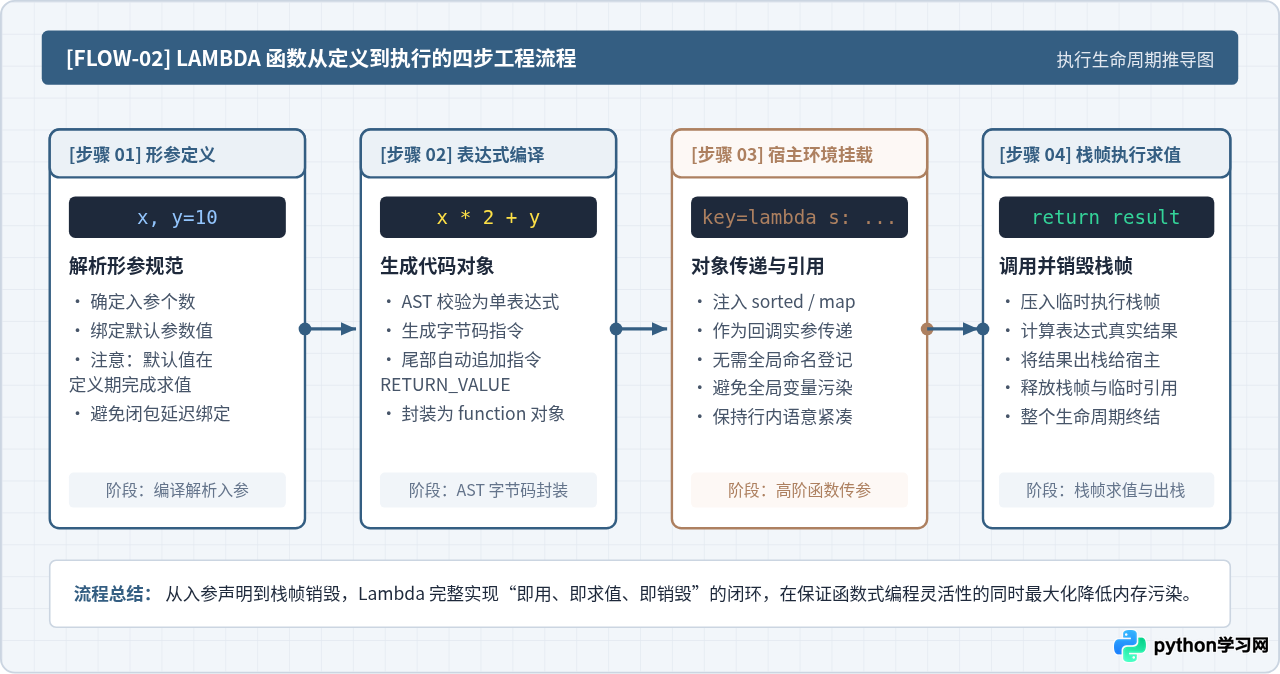
- 形参定义与默认值计算:Python 解析器在解析该行代码时,确定形参列表。如果存在默认参数(如
scale=10),默认参数表达式在定义阶段即完成求值并保存在函数对象的__defaults__元组中。 - AST 验证与字节码生成:解析器确保冒号右侧为单一抽象语法树表达式节点,并在末尾自动压入
RETURN_VALUE字节码指令,生成底层的 PyCodeObject。 - 宿主挂载与引用传递:匿名函数作为第一类对象(First-Class Object),通常直接作为实参注入高阶函数(如
sorted的key参数)或注册到事件回调中,无需在全局命名空间分配变量名。 - 栈帧推入与隐式求值:当宿主调用该函数时,解释器为其开辟独立的临时栈帧,执行单行计算指令,将计算结果出栈返回给宿主,随即销毁临时栈帧,完成生命周期。
三、典型应用场景与 def 函数的对比
在工程开发中,lambda 匿名函数并非用来取代标准 def 函数,而是专门为“行内一次性计算”而设计的轻量辅助机制。
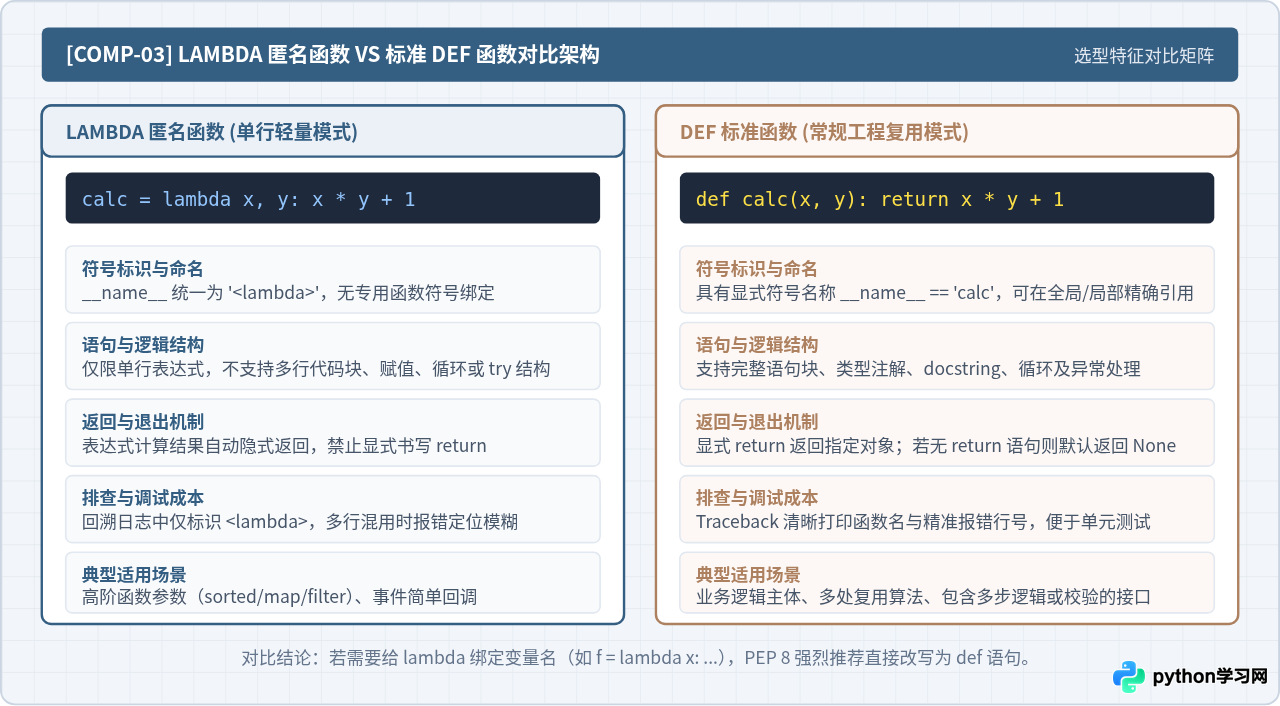
1. 集合与列表的自定义排序(最核心场景)
在对复杂字典、元组或对象列表进行排序时,sorted() 和 list.sort() 接受一个 key 函数。使用 lambda 可以直接在行内声明提取排序键的逻辑,无需在外部单独定义辅助函数:
# 学生信息列表:姓名、成绩、年龄
students = [
    {"name": "Alice", "score": 92, "age": 20},
    {"name": "Bob", "score": 85, "age": 22},
    {"name": "Charlie", "score": 92, "age": 19},
]

# 按成绩降序,若成绩相同则按年龄升序
sorted_students = sorted(students, key=lambda s: (-s["score"], s["age"]))
for item in sorted_students:
print(f"姓名: {item['name']}, 成绩: {item['score']}, 年龄: {item['age']}")姓名: Alice, 成绩: 92, 年龄: 20
姓名: Bob, 成绩: 85, 年龄: 22
2. 配合 map 与 filter 进行数据清洗
虽然现代 Python 更推荐使用列表推导式,但在流式处理或需要延迟迭代的生成器场景中,map() 与 filter() 搭配 lambda 依然非常高效:
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# 筛选偶数并计算其平方
evens_squared = list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, numbers)))
print("偶数平方列表:", evens_squared)四、定义时的关键注意事项与工程避坑
由于 lambda 函数具有隐式返回和单行限制,初学者在定义时极易踩入以下陷阱:
在循环体或列表推导中批量定义 lambda 时,如果直接捕获外部循环变量,lambda 内部记录的是该变量的名称引用而非当时的值。当循环结束时,所有函数都将读取循环变量的最终值。
# 错误示例:直接引用外部循环变量 i
funcs_err = [lambda: i for i in range(3)]
print("错误输出:", [f() for f in funcs_err])  # 输出全部为 2

# 正确做法:利用默认参数在定义时完成值绑定 (i=i)
funcs_correct = [lambda i=i: i for i in range(3)]
print("正确输出:", [f() for f in funcs_correct])正确输出: [0, 1, 2]
PEP 8 官方代码风格规范明确指出:永远不要写 f = lambda x: 2 * x 这样的语句。定义具名函数应当始终使用 def f(x): return 2 * x。显式赋值不仅违背了匿名的设计初衷,而且在异常追踪(Traceback)中会丢失函数名,增加排错成本。
lambda 函数内部不能书写 if condition: ... else: ... 语句,但可以使用 Python 的三元表达式语法 值1 if 条件 else 值2:
# 三元表达式定义安全除法
safe_div = lambda a, b: a / b if b != 0 else float("nan")
print("10 / 2 =", safe_div(10, 2))
print("10 / 0 =", safe_div(10, 0))10 / 0 = nan
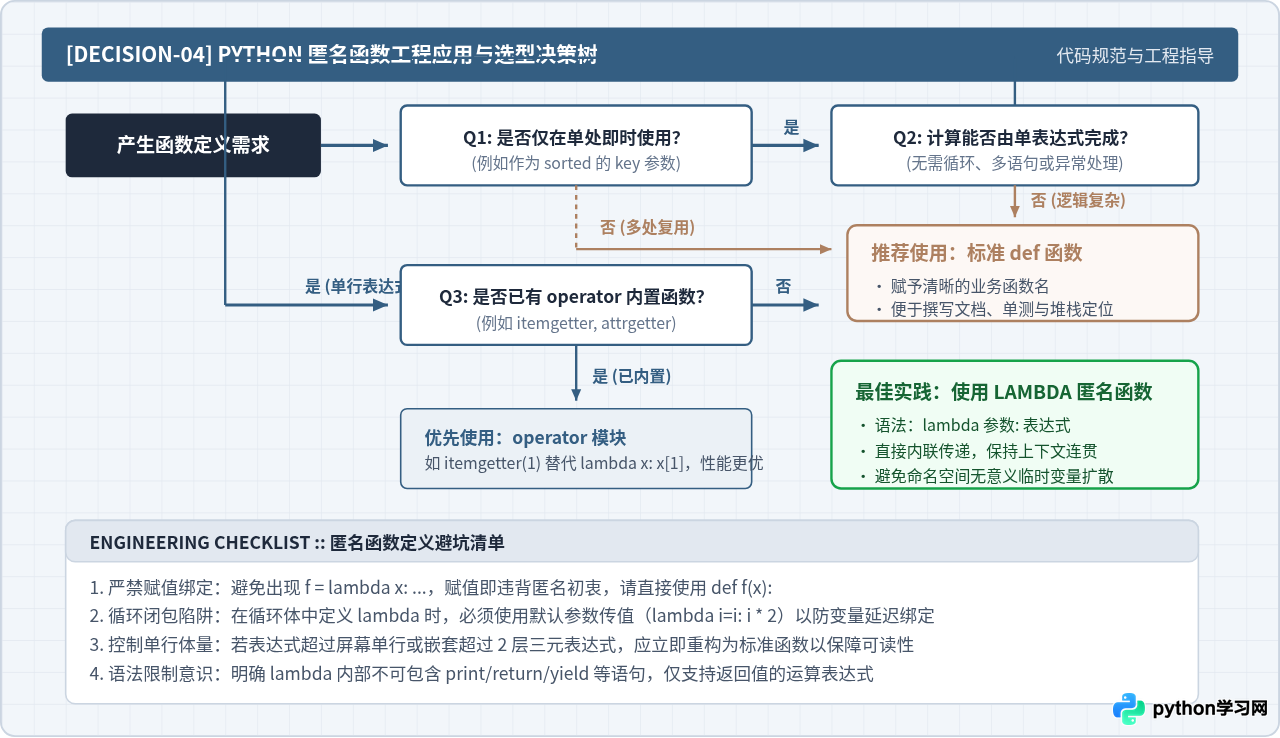
五、工程选型决策与速查总结
为了在实际开发中准确判断何时应当使用 lambda、何时应当使用 def 或 operator 模块,可以参考以下决策树:
| 对比维度 | Lambda 匿名函数 | 标准 Def 函数 | Operator 模块(如 itemgetter) |
|---|---|---|---|
| 语法形式 | lambda x: x.attr |
def get_attr(x): ... |
attrgetter('attr') |
| 代码行数 | 单行内联定义 | 多行代码块 | 单行导入并调用 |
| 执行性能 | 与 def 效率相同 | 与 lambda 效率相同 | C 语言层实现,速度更快 |
| 适用场景 | 简单单次计算、排序回调 | 业务核心逻辑、多处复用 | 字典/属性键提取、简单运算 |
总结而言,Python 中定义 lambda 匿名函数的核心是牢记 lambda 参数: 表达式 的极简结构。合理利用其行内定义、自动返回和即用即弃的特性,可以显著简化排序、映射等高阶函数调用;同时应严格遵循 PEP 8 规范,避免滥用嵌套三元表达式或显式赋值,确保代码的简洁与高可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









