

pytest Fixture机制详解:作用域、依赖注入与资源管理
深入解析 pytest Fixture 的核心运行机制,系统拆解依赖注入原理、五大作用域生命周期、yield 资源回收与工程化目录分层实践。
pytest 的 Fixture 机制是现代 Python 自动化测试体系的核心基石。它彻底改变了传统测试框架依靠继承与单一 setUp/tearDown 模板的僵化模式,通过声明式依赖注入、模块化组合与精细的作用域生命周期控制,让测试环境准备与资源清理变得高内聚、易复用且安全可靠。本文将系统剖析 Fixture 的底层运作逻辑,重点围绕依赖注入、作用域选择与生命周期管理展开,帮助读者掌握生产环境中高质量测试套件的构建范式。
一、依赖注入机制:声明式依赖与解耦
在 Python 原生 unittest 框架中,如果多个测试用例需要同一组数据或资源句柄,通常需要继承公共测试基类并在 setUp 方法中初始化实例属性。这种方式存在两个明显缺陷:一是所有测试被迫继承同一批资源,造成不必要的初始化开销;二是测试用例隐式依赖 self.xxx,难以直观辨别某个用例到底使用了哪些上下文状态。
pytest 采用了显式依赖注入(Dependency Injection)模式。定义 Fixture 时仅需使用 @pytest.fixture 装饰一个普通函数,该函数名随即成为一个可复用的依赖标识符。测试函数在声明入参时,如果参数名与已注册的 Fixture 名称一致,pytest 就会自动接管调用过程,在执行测试前运行 Fixture 并将其返回值传递给测试函数。
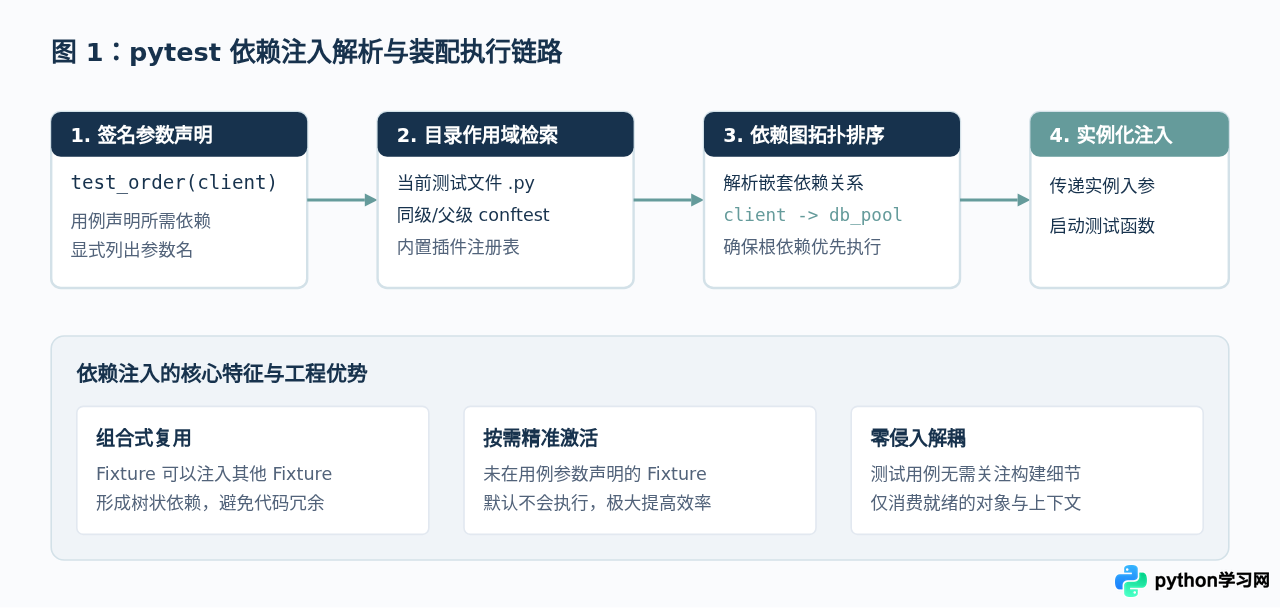
以下示例展示了基础依赖声明以及多层级 Fixture 的级联组装方式:
import pytest

# 基础 Fixture:提供测试数据
@pytest.fixture
def raw_user_data():
    return {"username": "dev_tester", "role": "admin"}

# 依赖其他 Fixture 的二级 Fixture:进行逻辑封装
@pytest.fixture
def authenticated_client(raw_user_data):
    client = FakeAuthClient()
    client.login(raw_user_data["username"], raw_user_data["role"])
    return client

# 测试函数仅需声明最终依赖项
def test_access_dashboard(authenticated_client):
    response = authenticated_client.get("/dashboard")
    assert response.status_code == 200
    assert response.json()["role"] == "admin"
在解析执行期间,pytest 构建了 test_access_dashboard -> authenticated_client -> raw_user_data 的有向无环图(DAG),并以拓扑倒序先计算底层数据,再生成业务客户端,最后把组装好的对象传给测试用例。
二、Fixture 的五大作用域与共享边界
并非所有资源都需要在每次运行测试函数时都从头构建一次。例如启动一个真实的 Docker 容器或加载一个大型深度学习模型需要数秒甚至数分钟,如果在每个 test_xxx 执行前都重建一遍,测试套件将变得极其缓慢。为此,pytest 提供了 scope 参数来精细定义资源的存在周期。
pytest 支持 5 种不同粒度的作用域:
function(默认):每个测试函数运行前后各执行一次。环境完全隔离,安全性最高。class:每个测试类执行前后各执行一次。类中全部测试方法共享同一个 Fixture 实例。module:每个 Python 模块(即.py测试文件)开始和结束时各执行一次。package:每个 Python 包(含__init__.py的测试目录)跨文件执行一次。session:整个测试进程生命周期内只执行一次,全局所有测试共享。
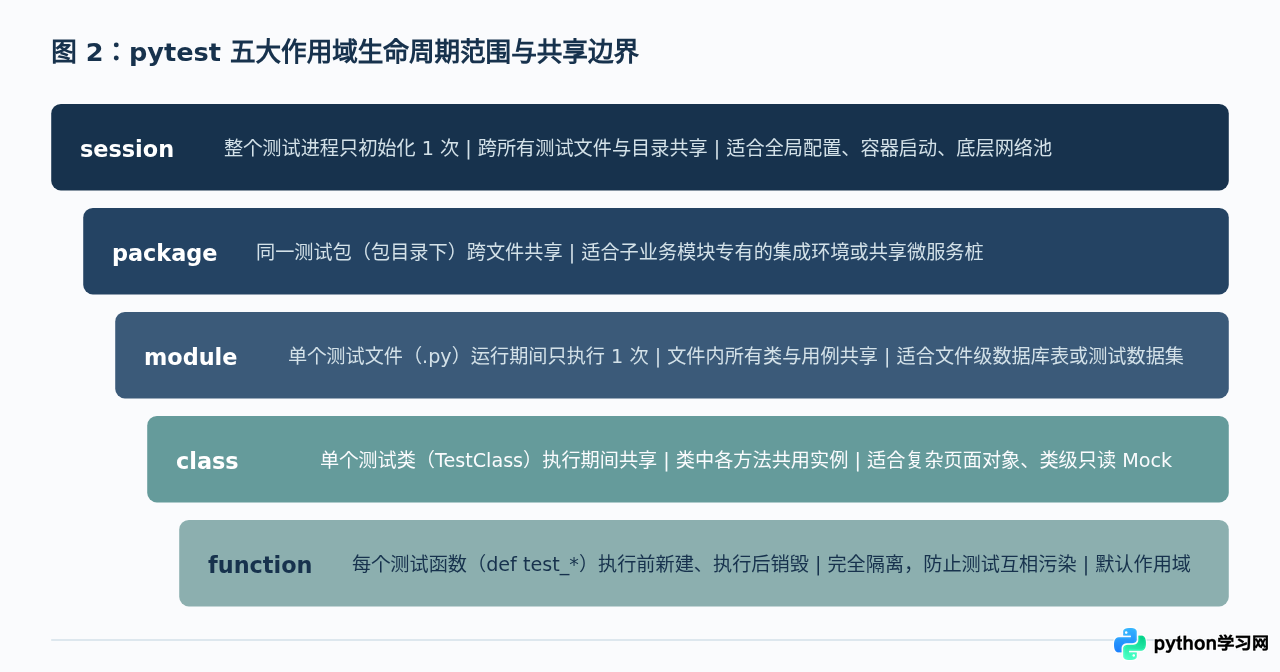
作用域选择权衡与约束规则
| 作用域级别 | 生命周期与复用次数 | 隔离性 | 典型使用场景 |
|---|---|---|---|
session |
整个测试阶段执行 1 次 | 无(全局共享) | 全局配置加载、远程服务连接池、Docker 启动 |
package |
当前目录包内共享 1 次 | 包级隔离 | 业务线级别的公共基础设施初始状态设置 |
module |
单个测试文件内共享 1 次 | 文件级隔离 | 静态测试用例解析、模块专属只读内存数据库 |
class |
单个测试类内共享 1 次 | 类级隔离 | UI 自动化中的浏览器页面打开与公共组件载入 |
function |
每个测试用例独立运行 1 次 | 完全隔离 | 易变数据记录、具有写入状态的独立业务事务 |
作用域依赖约束原则(Scope Mismatch):较宽作用域的 Fixture 绝对不能直接依赖较窄作用域的 Fixture。例如,声明为 scope="session" 的 Fixture 不能依赖 scope="function" 的 Fixture,否则在构建阶段 pytest 会直接抛出 ScopeMismatch 异常。原因在于 session 级别的对象在用例尚未实例化时就需要完成构造,无法消费随时被销毁的短生命周期对象。
三、资源管理与善后清理:yield 语句与上下文安全
在自动化测试中,资源的“申请”与“释放”必须形成严格闭环。如果测试用例中途发生断言失败或未捕获的运行时异常,分配的数据库连接、临时文件句柄或网络端口必须能够被稳定回收,否则会导致后续测试资源耗尽。
pytest 提供了极其优雅的 yield 语法,无需编写繁杂的清理回调。当 Fixture 函数内部遇到 yield 时:
yield之前的代码在测试执行前运行(即 Setup 阶段)。yield产出的对象会被注入到测试函数中作为实参。- 测试用例执行完成后,代码自动从
yield下一行继续执行(即 Teardown 阶段)。
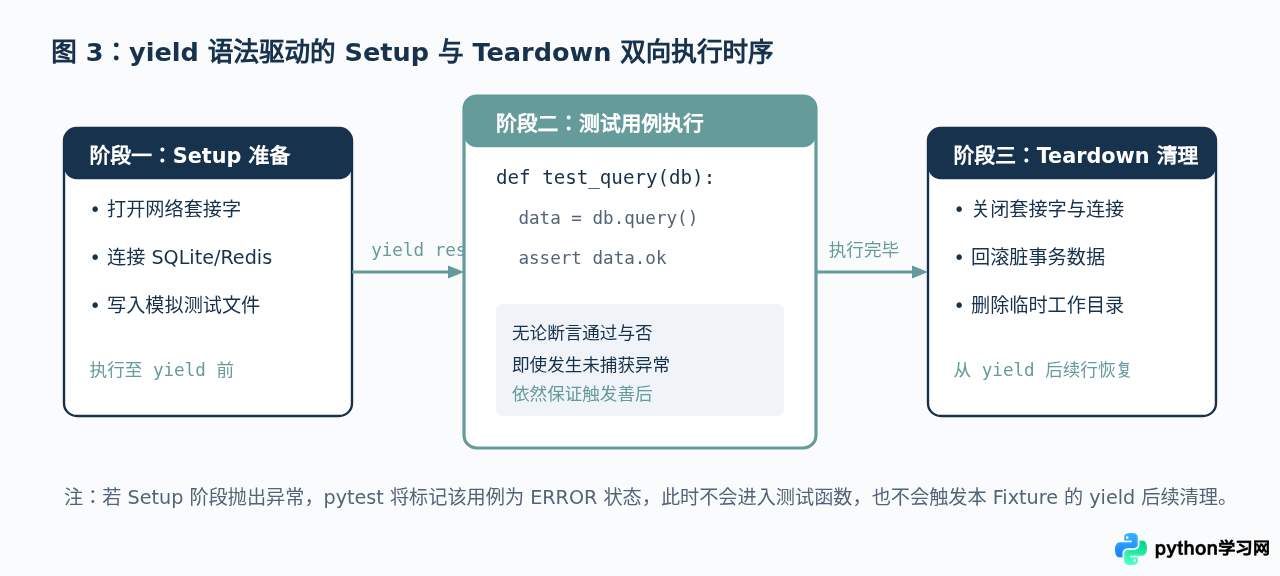
以下是管理数据库连接事务回滚与临时存储的完整实践代码:
import sqlite3
import tempfile
import shutil
from pathlib import Path
import pytest

@pytest.fixture(scope="function")
def db_session():
    # --- [Setup 准备工作] ---
    temp_dir = tempfile.mkdtemp()
    db_path = Path(temp_dir) / "test.db"
    conn = sqlite3.connect(str(db_path))
    cursor = conn.cursor()
    cursor.execute("CREATE TABLE users (id INTEGER PRIMARY KEY, name TEXT)")
    conn.commit()

    # --- [Yield 暴露资源] ---
    try:
        yield conn
    finally:
        # --- [Teardown 清理回收] ---
        conn.close()
        shutil.rmtree(temp_dir, ignore_errors=True)

def test_insert_user(db_session):
    cursor = db_session.cursor()
    cursor.execute("INSERT INTO users (name) VALUES ('alice')")
    db_session.commit()

    cursor.execute("SELECT name FROM users WHERE id = 1")
    row = cursor.fetchone()
    assert row[0] == "alice"
工程规范建议:虽然 pytest 会确保测试执行完毕后返回 yield 之后执行清理,但如果在 yield 之前有多个可能抛出异常的步骤,建议使用 try...finally 块或通过 request.addfinalizer 注册终结清理函数。addfinalizer 的优势在于它支持在 Fixture 运行逻辑中的任何点动态注册清理逻辑,已注册的 finalizer 即使在后续步骤报错时也能得到执行。
四、工程化组织与进阶特性
1. 全局配置与目录层级:conftest.py 的发现机制
大型工程中,测试用例不应在每个 .py 文件中重复定义通用的 Fixture。pytest 提供了根基文件 conftest.py。存放在 conftest.py 中的 Fixture 会自动向当前目录及其所有子目录下的所有测试文件公开,完全不需要显式 import 导入。
如果子目录中存在专有的 conftest.py,子目录会继承上级的所有 Fixture,并可根据需要覆盖上层同名的定义,实现层次化、模块化的环境定制。
2. autouse=True:无侵入式自动装配
在某些场景下,我们希望某种操作在每个用例前都执行(例如清空全局缓存、重置模拟时钟或打印用例耗时),但又不想在每个测试函数签名里冗长地声明该参数。此时可指定 @pytest.fixture(autouse=True)。
@pytest.fixture(autouse=True)
def reset_app_state():
    # 所有测试用例执行前自动执行,无需显式入参
    GlobalCache.clear()
    yield
    # 用例结束后自动执行清理
    GlobalCache.clear()
注意:避免过度滥用 autouse=True。因为隐式执行会降低测试的透明度,使得新加入项目的开发者难以定位某些副作用的来源,建议只用于纯粹的通用状态重置或度量收集。
3. params 参数化:一条 Fixture 衍生多组测试矩阵
Fixture 自身支持参数化执行。通过为 @pytest.fixture(params=[...]) 提供列表,pytest 会将依赖该 Fixture 的每个测试用例根据参数列表拆分为多个独立的执行项:
@pytest.fixture(params=["sqlite", "mysql", "postgres"])
def database_engine(request):
    engine = create_engine_by_type(request.param)
    yield engine
    engine.dispose()

# 该用例会自动执行 3 次,分别传入 3 种数据库引擎
def test_table_creation(database_engine):
    assert database_engine.check_health() is True
五、架构设计决策与排错总结
构建稳健测试框架的核心在于平衡“执行速度”与“测试独立性”。在设计具体的 Fixture 时,可以参考以下决策路径:
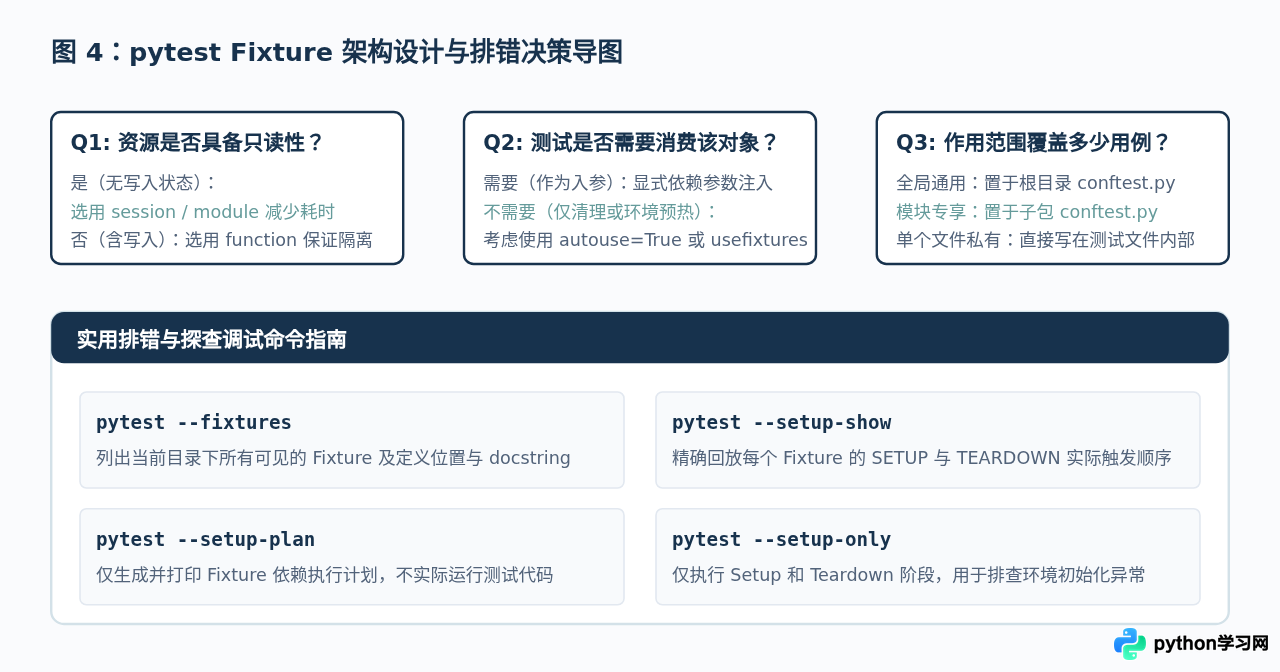
掌握了依赖注入、作用域控制和 yield 上下文清理这三大核心要点后,我们便能够以高度模块化、易维护的方式编排测试套件,彻底告别脆弱的全局变量与杂乱的继承层级,构建出高效、稳健的 Python 自动化测试体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









