

为什么统计学背景的人更倾向R语言而程序员首选Python
深入对比R语言与Python在统计学分析与软件工程两个不同阵营中的技术根基、设计哲学与应用场景差异,帮助读者根据团队背景与业务需求做出精准选型。
典型业务场景:一家科技公司的业务部门提出需求:“请分析过去半年新上线促销策略对用户续费率的实际影响,并验证策略是否带来统计显著的提升”。
团队里的统计学家打开了 RStudio,载入数据后写下三行代码完成数据框切片、方差分析(ANOVA)与逻辑回归拟合,两分钟内便调出了包含标准误、t值、p值及置信区间的学术级推断报告;而同组的软件工程师打开了 VS Code,建立了虚拟环境并配置 Poetry,开始思考如何用 Pydantic 校验输入字段、如何把 Pandas 处理步骤拆分成流水线函数、如何编写单元测试,以及将来这个分析模块怎样封装为 FastAPI 接口放进 Docker 镜像。
统计学家偏好 R 语言,而软件工程师首选 Python,这一现象并不是因为两者之间存在简单的“优劣之分”,而是由它们各自底层的设计基因、心智模型与终极交付目标所决定的。R 语言本质上是一个专为数据探索与统计推断设计的交互式计算环境;而 Python 则是一门设计用于构建通用软件系统、并通过丰富的外部库顺带支持科学计算的工程级编程语言。
一、设计基因的分水岭:统计交互环境 vs 通用软件工程
要理解两个群体的选择差异,首先需要追溯两门语言的诞生初衷与设计哲学。
R 语言诞生于 1993 年,由统计学家 Ross Ihaka 和 Robert Gentleman 在新西兰奥克兰大学基于贝尔实验室的 S 语言开发。S 语言的核心设计理念是“探索性数据分析”(Exploratory Data Analysis, EDA)。它从诞生第一天起,就是为了让研究人员在一个交互式终端(REPL)中直接同数据对话:随时载入数据表、随时计算统计量、随时绘制图形,而无需事先声明变量类型、编写复杂的项目骨架或考虑高并发服务集成。
Python 则由 Guido van Rossum 于 1989 年为了克服 ABC 语言的缺陷而设计。它的哲学高度凝聚在《Python之禅》中:“优美胜于丑陋,明了胜于晦涩,简洁胜于复合”。Python 是一门纯粹的通用高级面向对象编程语言,其核心关注点在于语法的一致性、代码的可读性、庞大软件系统的模块化解耦以及完备的系统级标准库支持。
这种起源基因的差异,直接投射到了统计推断与工程预测的不同关注点上:
- 统计学关注“因果与机理”:核心是解释自变量对因变量的影响程度是否真实存在。分析师需要严密检验多重共线性、异方差性、残差正态性,关注 p 值、F 统计量与置信区间。R 的基础函数库默认将这套统计学规范融入骨髓。
- 软件工程关注“泛化与可用”:核心是给定一组特征能否以极高吞吐率、极低延迟预测出未知样本的结果。工程师更关心损失函数收敛速度、AUC/ROC 指标、并发瓶颈、内存泄漏防范与异常捕获。Python 及其 Scikit-Learn 生态完美适配了这一目标。
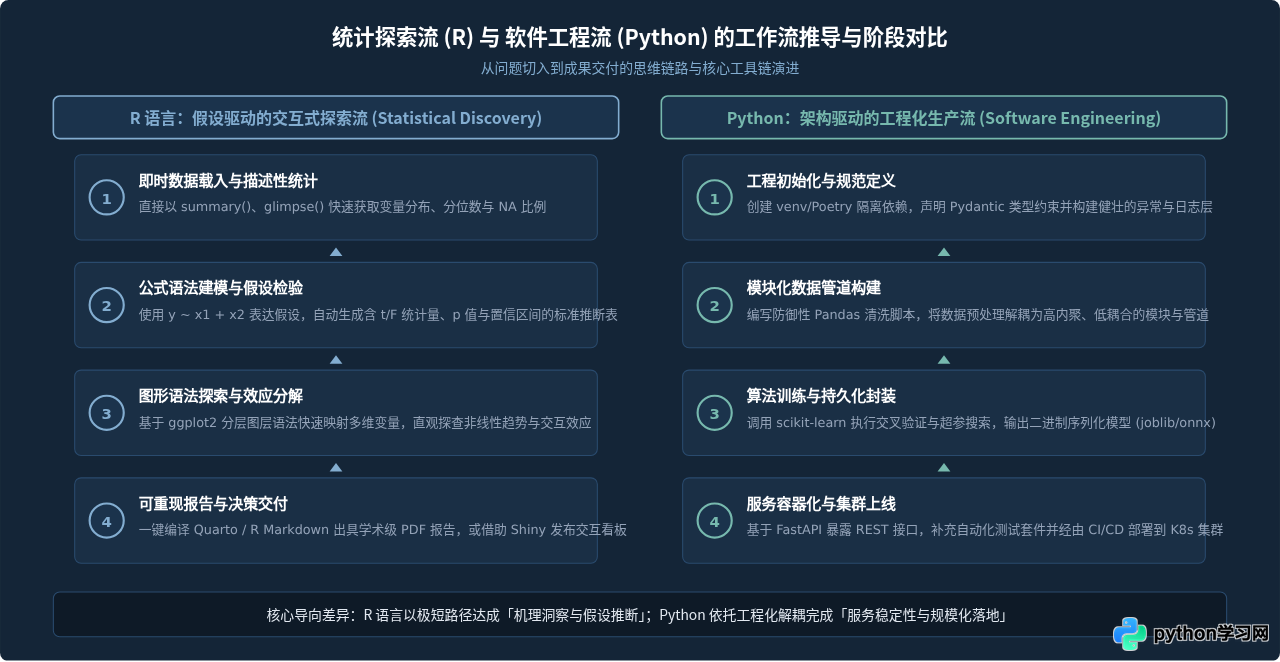
二、数据结构抽象与心智模型:以统计推断为核心 vs 以通用对象为基石
当一个程序员和一个统计学家同时观察一组数据时,他们大脑中的抽象实体是完全不同的。这导致了两者在选择工具时会产生天然的心智共鸣或排斥。
1. 向量化一等公民与因子类型
在 R 语言中,根本不存在“单精度标量”这种孤立概念。任何数字(例如 42)在底层都是长度为 1 的数值型向量(Vector)。这意味着所有的基础运算天然支持向量化广播,并且无需导入外部科学计算库。此外,R 原生内置了**因子(Factor)**数据类型。统计学家进行实验设计时,处理的不仅仅是单纯的字符串,而是包含水平(Levels)与基准对照组(Reference Level)的分类变量。当你在 R 线性模型中放入一个因子变量时,R 会自动进行虚拟变量编码(Dummy Coding / Contrast),并在输出表中清晰列出每个分水平的回归系数与参考组的差异。
而在 Python 纯原生环境中,基础数据结构是 list、dict 和 set。若要在 Python 中实现类似功能,必须依赖第三方库 Pandas 的 Categorical 类型,或借助 Scikit-Learn 的 OneHotEncoder 显式转换。对于程序员来说,这种显式分层非常清晰;但对于统计学背景的人而言,本应是语言底层常识的概念却变成了层层嵌套的工程转换步骤,增加了认知负担。
2. 缺失值的严谨模型:NA 与 NaN 的本质区分
在统计推断中,缺失数据包含极其重要的信息。R 严格区分了两种缺失概念:
NA(Not Available):表示客观存在的真实值未能被观测到(例如病人未参加复诊测试)。NaN(Not a Number):表示数学上无定义的非法计算结果(如0 / 0或负数开偶数次方)。
在 R 中,基础统计函数(如 mean()、sd())只要遇到一个 NA,默认返回值必然是 NA。它强制要求分析师意识到缺失值的存在,显式声明 na.rm = TRUE 或使用多重插补(Multiple Imputation),避免静默计算掩盖偏差。而在原生 Python 及早期科学栈中,None 与 np.nan 常产生混淆,浮点型 NaN 甚至会导致整型列被迫隐式升级为浮点型,容易让没有工程防护意识的研究人员掉入类型陷阱。
3. 公式语法(Formula Interface)的优雅表达
统计建模极为依赖自变量之间关系的灵活设定。R 的公式接口堪称领域专用语言(DSL)的典范:
短短两行代码,不仅自动完成变量扩展、正交多项式构造与交互项相乘,还能在 summary() 打印中输出残差分布、多重判定系数 R²、调整后 R²、F 检验值以及各参数的双尾 t 检验 p 值。而如果在 Python 中使用主流的机器学习库 Scikit-Learn,完成相同工作需要调用 PolynomialFeatures 构造多项式矩阵,再通过 ColumnTransformer 拼接,最后训练出的模型对象默认**不会**计算任何 p 值或置信区间——因为 Scikit-Learn 的定位是模式识别与预测,它甚至没有内置计算参数标准误的底层方法。
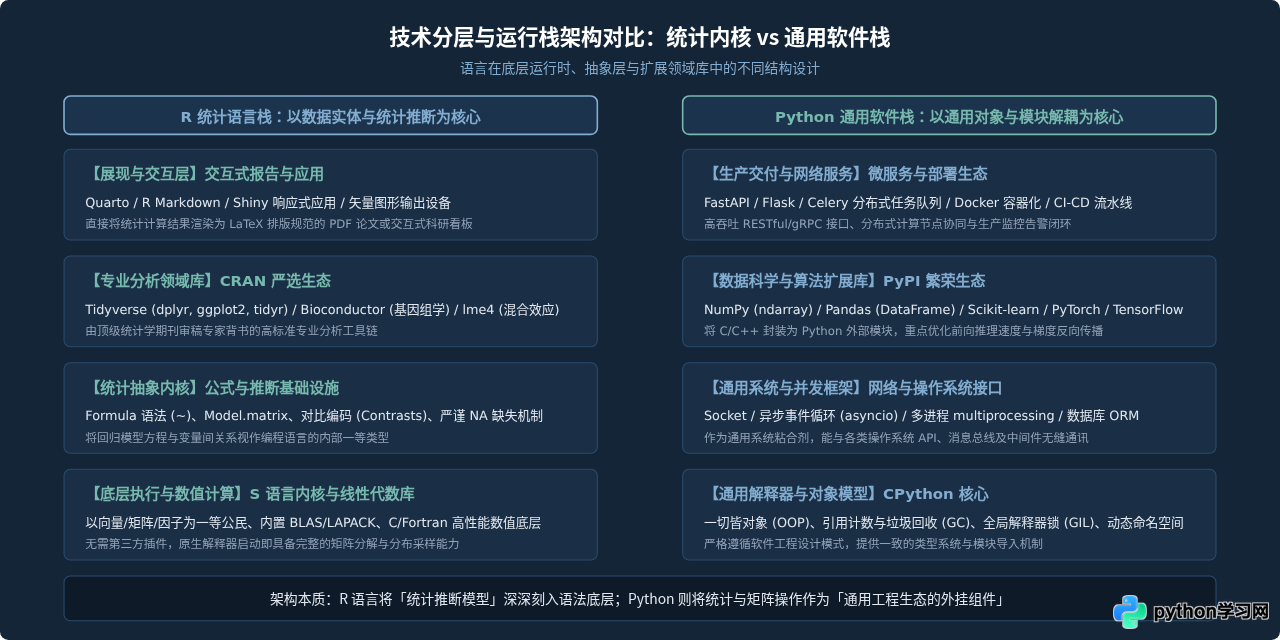
三、生态治理与包发布机制:CRAN 学术审查 vs PyPI 工业集市
除了语言语法与数据结构外,生态系统的发布机制深刻塑造了使用者对代码库的信任模式。
1. CRAN 的严苛准入与跨平台可重现性
R 语言的核心包管理器 CRAN(The Comprehensive R Archive Network)以其接近苛刻的审核政策而闻名:
- 所有提交至 CRAN 的扩展包,必须在 Windows、macOS 以及多个 Linux 发行版(包含旧版本 R 环境)上通过全量单元测试与示例编译。
- 函数文档必须严格覆盖每一个参数,且示例代码不能包含任何外部不可控的网络请求或执行报错。
- 一旦新版本改动破坏了下游其他包的兼容性,包作者会被通知限期修复,否则其包将面临下架归档。
这种高度中心化、学术同行评审式的包管理机制,使得 CRAN 几乎成为前沿统计学方法、生物信息学(Bioconductor)以及计量经济学研究成果的首发阵地。统计学家写出一篇顶级论文后,往往会同步在 CRAN 发布配套的 R 包,供同行学者进行 100% 相同数据的复现验证。因此,在临床试验、流行病学调查、金融计量等强调合规与责任认定的领域,R 具备天然的信任壁垒。
2. PyPI 的开放繁荣与工程工具链
相比之下,Python 的官方仓库 PyPI(Python Package Index)则是一个完全去中心化的开放自由集市。任何开发者注册账号后,都可以在几分钟内将代码打包发布。这种低门槛释放了全球开源社区的无穷创造力,孕育出了诸如 Django、FastAPI、Requests、PyTorch、HuggingFace 等改变软件行业的伟大项目。
但对于统计分析而言,开放集市也带来了代价:包质量参差不齐、API 频繁弃用、依赖冲突(Dependency Hell)频发。在 Python 中,如果一个非计算机专业的分析师半年后重新安装同一套脚本所需的依赖,很可能会因为某个子依赖库的版本升级而导致脚本无法运行。工程师早已习惯了使用虚拟环境、锁文件(Poetry/Pipenv lock)和 Docker 镜像来驯服依赖,但这对统计学研究人员而言,无疑增加了与核心研究无关的工程杂耗。
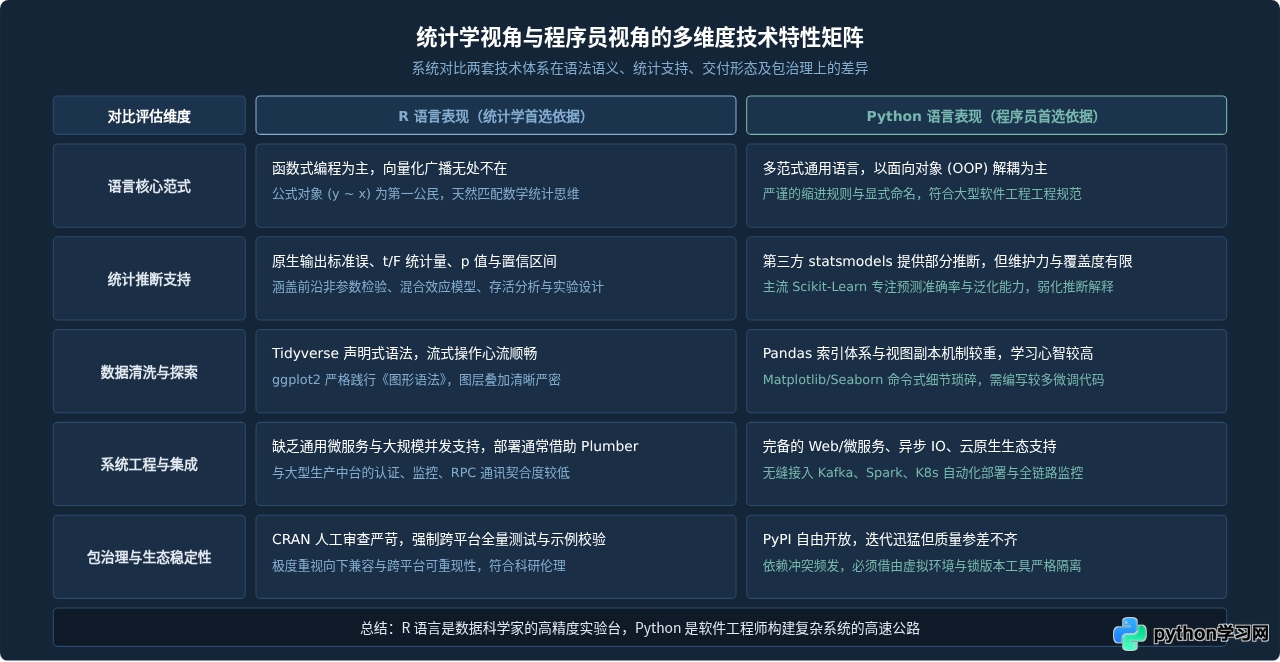
四、交付形态的终点:写给“人”看 vs 写给“机器”运行
另一个决定工具偏好的根本驱动力,是两个群体日常交付产物的形态。
1. R 的最终交付目标通常是“人”:同行、学者、监管层与商业决策者
统计学家的最终产出通常是一份严谨的学术论文、一份 FDA 临床试验申报材料、或一份供公司高管决断的因果推断总结报告。在这一诉求下,R 提供了无与伦比的“文学化编程”(Literate Programming)体验:
- Quarto 与 R Markdown:代码、LaTeX 数学公式、动态执行生成的交互图表与分析文字共存同一文档,一键排版导出为顶刊排版标准的 PDF、Word 或学术网页。
- Shiny 应用框架:纯粹使用 R 语言,无需编写前端 HTML、CSS 或 JavaScript,就能在半天之内把统计模型封装为一个响应式 Web 看板,供医生、投资人或业务分析师动态拖动滑块查看敏感性分析。
2. Python 的最终交付目标通常是“机器”:持续集成系统、服务器与云原生集群
软件工程师编写的数据与算法逻辑,最终往往需要进入庞大的自动化体系:
- 微服务与系统内嵌:模型需要被封装成低延迟、高并发的 HTTP/gRPC 服务接口(如通过 FastAPI),部署在 Kubernetes 容器集群中,接受前端 App 或后端网关每秒数万次的实时请求。
- 全栈与工程协同:一个完整的业务系统需要数据库操作(SQLAlchemy)、网络通信、多线程异步任务(Celery)、身份鉴权与自动化测试(pytest)。Python 的通用性使得团队可以用同一门语言完成从爬虫抓取、数据加工、模型训练到生产接口发布的全部闭环,极大降低了团队多语言维护的沟通成本。
五、选型决策指南与现代协同实践
在实际工业与科研实践中,我们应当如何根据具体任务与团队背景进行理性选型?
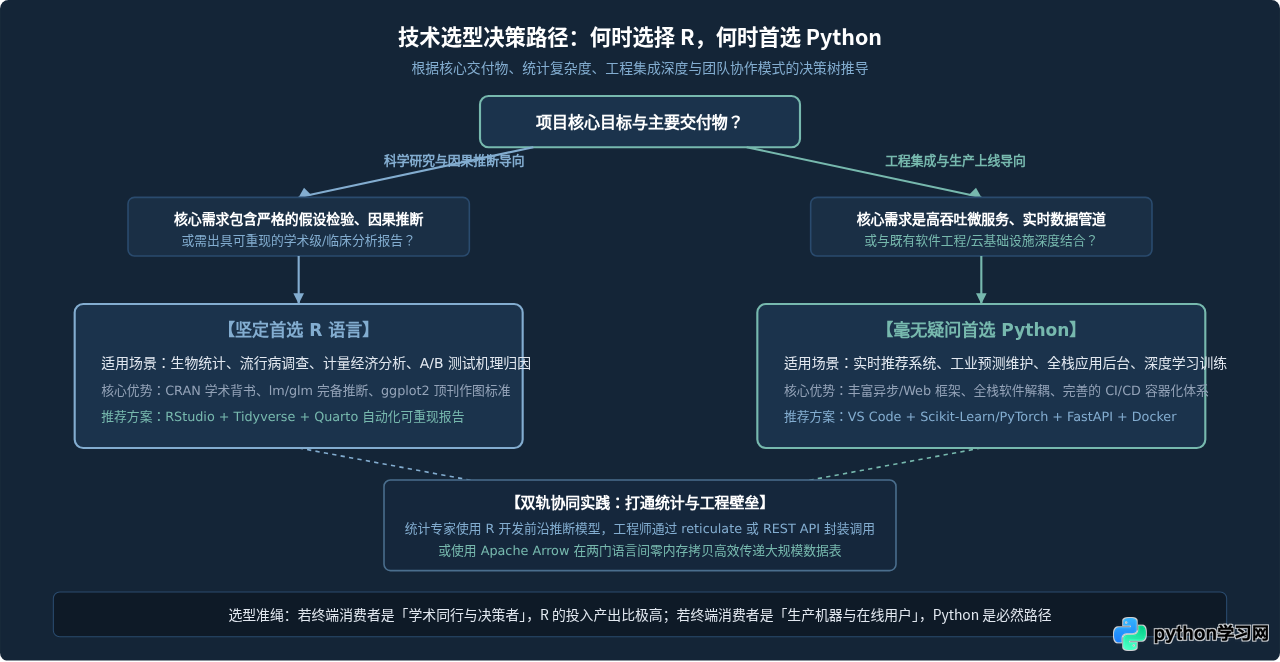
为了进一步明确在不同业务场景下的技术路线,以下清单总结了具体的决策准则:
| 场景与需求特征 | 推荐工具 | 关键考量与原因 |
|---|---|---|
| 临床试验数据分析、流行病学调查、统计年鉴编制 | R 语言 | CRAN 严格的审核流程、经过数十年检验的基础统计包、符合 FDA 严苛审计的重现性标准。 |
| 高频交易后台、实时反欺诈风控服务、Web 全栈集成 | Python | 需要毫秒级低延迟响应、高并发异步网络通信,以及成熟的微服务接入生态。 |
| 企业级因果推断实验(A/B Testing 效应分解) | R 语言 (或 Python statsmodels) | R 原生提供双重差分法(DID)、倾向评分匹配(PSM)与复杂方差分解的顶流扩展包。 |
| 计算机视觉、自然语言处理(大语言模型微调与部署) | Python | PyTorch、TensorFlow、Transformers 等现代深度学习基础设施几乎全由 Python 一统天下。 |
| 中小型团队跨角色协作(统计学家研发,工程师部署) | R + Python 混合架构 | 利用 reticulate 允许在 R 脚本中调用 Python 模型,或通过 Plumber/FastAPI 以标准 REST 接口实现跨语言微服务交互。 |
六、结语
统计学家偏好 R 语言,不是因为他们排斥现代软件工程,而是因为 R 语言的语法与设计深度尊重了人类进行统计思考、假设检验与探索性分析的自然心流;程序员首选 Python,也不是因为他们轻视统计严密性,而是因为软件工程的首要任务是在不确定性中建立稳定、解耦、可维护且能承受高并发冲击的生产系统。
工具本身并无高低之别,关键在于认清当前任务的本质——是需要在一个下午内向决策层揭示数据背后的深层因果,还是需要在三个月内为成百上千万用户搭建一套坚不可摧的智能服务。理解这种底层诉求的差异,才能帮助技术团队在选型时超越门户之见,做出最符合业务价值的理性决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









