

Python序列解包基础:怎么将列表或元组赋值给多个变量
详细讲解Python序列解包基础原理与实用操作,包括如何将列表或元组按顺序赋值给多个独立变量、解决ValueError数量不匹配问题、使用星号表达式捕获剩余元素及嵌套解包技巧。
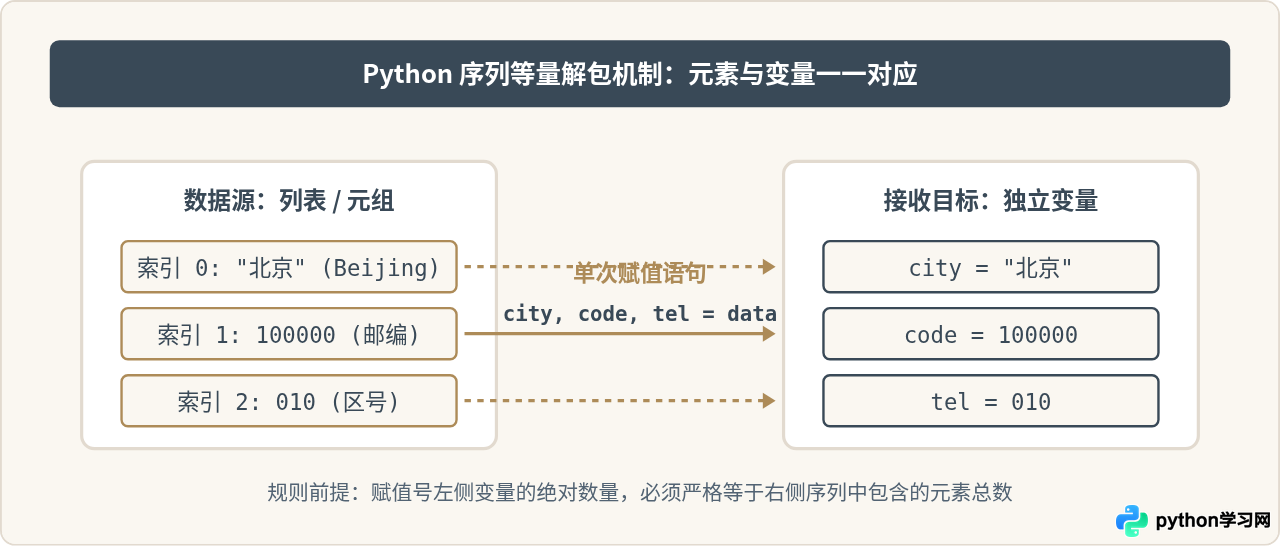
在 Python 中,想要把列表或元组中的数据按顺序分别提取给多个独立变量,最直接的方法是使用序列解包(Sequence Unpacking)。只需在赋值符号左侧写出多个用逗号分隔的变量名,右侧放上对应容器,Python 就会在一条语句内将容器内的元素按位置一一拆解并完成赋值。
一、什么是序列解包:单行代码拆解容器
在编写数据处理逻辑或解析函数返回结果时,我们经常会得到包含多个元素的列表(List)或元组(Tuple)。传统做法通常是通过索引逐个提取元素,例如写三行 x = data[0]、y = data[1]、z = data[2]。这种写法冗长且容易因下标写错产生手误。
Python 提供了语法层面的序列解包机制。解包语句的语法非常直观:左侧是接收变量构成的序列结构,右侧是待解构的数据源。Python 解释器在执行时,会自动遍历右侧序列的每一项,并将其精准投递给左侧对应位置上的变量。
二、标准解包语法与代码示例
无论是列表还是元组,解包的语法形式是完全一致的。下面通过基础示例演示具体的使用步骤:
1. 解包元组(Tuple)
# 定义包含三个坐标值的元组
point = (10, 20, 30)

# 通过解包同时赋值给三个变量
x, y, z = point

print("x 坐标:", x)  # 输出示例: x 坐标: 10
print("y 坐标:", y)  # 输出示例: y 坐标: 20
print("z 坐标:", z)  # 输出示例: z 坐标: 30
2. 解包列表(List)
列表的解包方式与元组相同,变量名之间使用半角逗号隔开:
# 定义包含学生基本信息的列表
student = ["张伟", 19, "计算机科学"]

# 解包赋值
name, age, major = student

print("姓名:", name)   # 输出示例: 姓名: 张伟
print("年龄:", age)   # 输出示例: 年龄: 19
print("专业:", major) # 输出示例: 专业: 计算机科学
在语法形式上,左侧也可以用括号包裹,例如 (x, y, z) = point 或 [name, age, major] = student。但在 Python 编码规范(PEP 8)中,通常推荐直接省略外层括号,书写为更简洁的 a, b, c = data。
三、核心限制与报错排查:数量不匹配异常
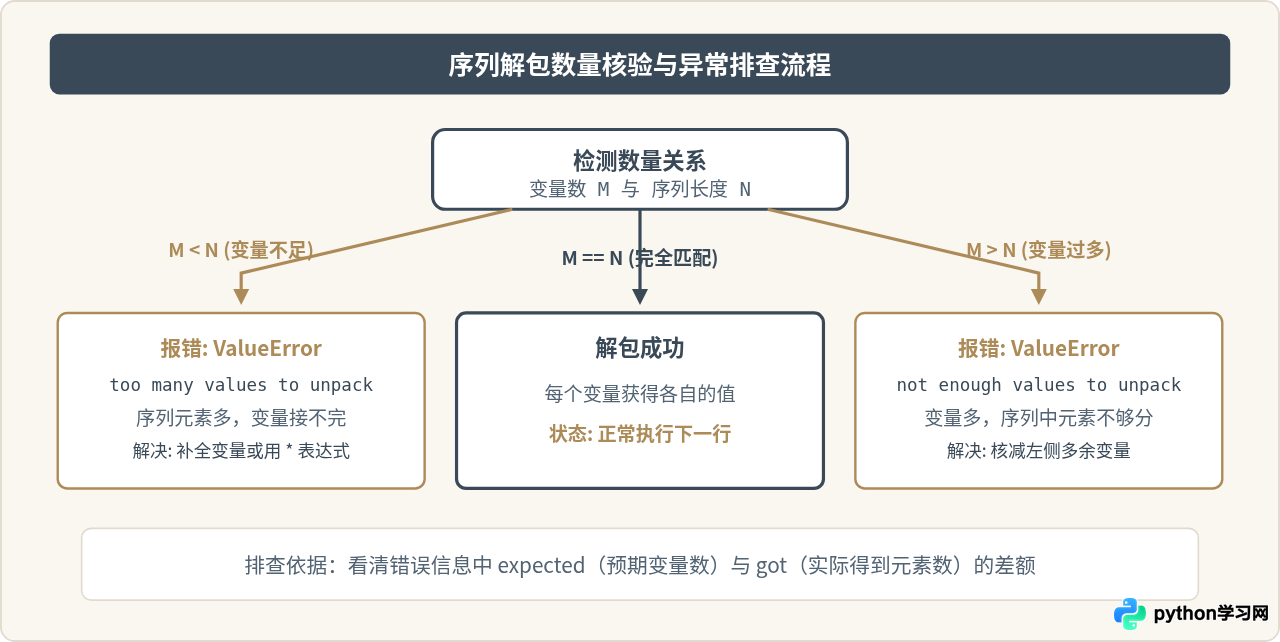
标准解包最严格的前提条件是:左侧接收变量的个数必须完全等于右侧序列的长度。当二者数量不一致时,Python 会立即中断执行并抛出 ValueError。
具体报错场景示例
场景一:序列元素过多(变量不足)
items = [1, 2, 3]
a, b = items
# 抛出异常: ValueError: too many values to unpack (expected 2)
解释:列表 items 含有 3 个元素,但左侧只提供了两个变量 a 和 b,Python 无法决定剩余的元素 3 归属,因此报错。
场景二:序列元素不足(变量过多)
coords = (100, 200)
x, y, z = coords
# 抛出异常: ValueError: not enough values to unpack (expected 3, got 2)
解释:左侧期待 3 个变量被赋值,但右侧元组仅包含 2 个值,无法填满全部变量。
四、扩展用法:使用星号(*)收集剩余元素
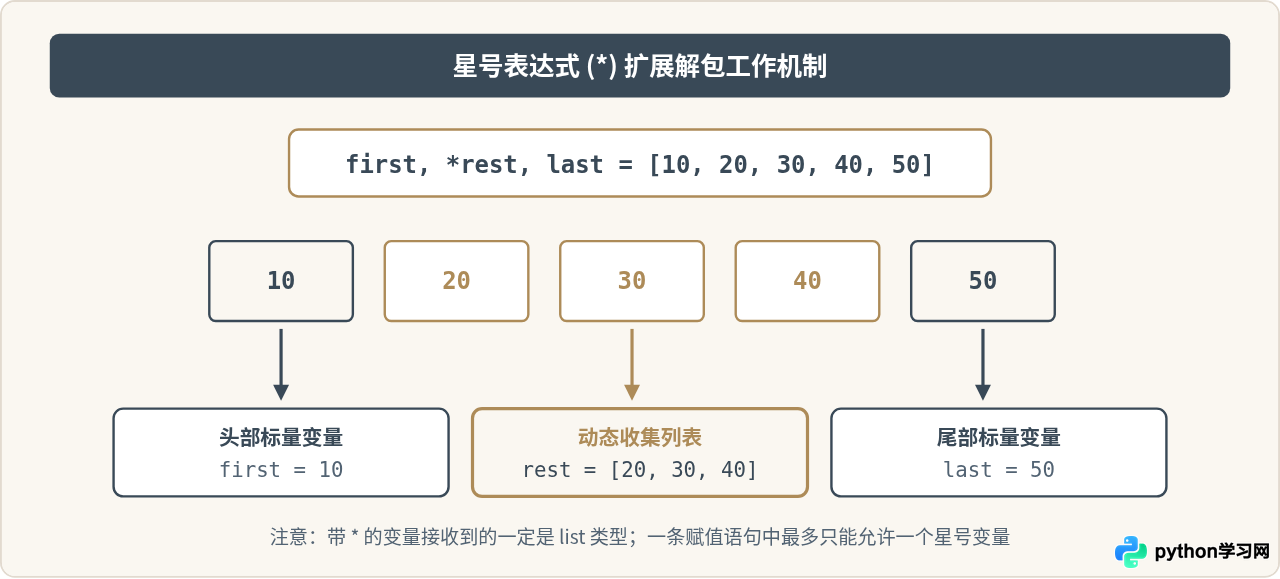
很多时候,序列的长度是不固定的(例如处理文件行、日志记录或不定长入参),或者我们只关心前几个或最后几个元素。在 Python 3 中,可以使用星号表达式(Extended Iterable Unpacking)来捕获不确定数量的剩余数据。
1. 捕获尾部所有多余元素
scores = [98, 85, 77, 92, 60]

# 提取最高分,其余分数收集到 others 中
top_score, *others = scores

print("最高分:", top_score)  # 输出: 最高分: 98
print("其他分数:", others)    # 输出: 其他分数: [85, 77, 92, 60]
2. 提取首尾,收集中间切片
log_record = ["2026-10-19", "WARNING", "DiskUsage", "High", "Server-01"]

# 提取时间与服务器编号,中间所有参数打包
date, *info, server = log_record

print("记录时间:", date)   # 输出: 2026-10-19
print("详情信息:", info)   # 输出: ['WARNING', 'DiskUsage', 'High']
print("所属节点:", server) # 输出: Server-01- 即使右侧没有多余的元素分给带星号的变量,它也不会报错,而是会被赋予一个空列表
[]。 - 同一层解包赋值语句中,只能有一个带
*的变量。如果写了两个星号变量(例如*a, *b = items),Python 将无法确定两者的分界线,会报SyntaxError: multiple starred expressions in assignment。
五、进阶与实用场景技巧
1. 使用下划线 _ 忽略不需要的字段
在实际开发中,我们经常遇到只关心部分字段的情况。按照惯例,可以使用单个下划线 _ 作为占位符,用来明确告诉阅读代码的人“这个变量的值在此处被丢弃”:
user_data = ("张三", "男", 28, "北京市海淀区")

# 只提取姓名与年龄,忽略性别和地址
name, _, age, _ = user_data

print(name, age)  # 输出: 张三 28
若需要忽略中间连续多个值,还可以结合星号使用 *_:
# 只需要第一个和最后一个元素,其余全部丢弃
first, *_, last = [1, 2, 3, 4, 5, 6]
2. 嵌套结构的多层解包
如果列表或元组内部还嵌套着列表或元组,左侧只需保持完全相同的嵌套结构,即可实现一步到位的递归解包:
# 嵌套结构:员工信息及附带的经纬度坐标
employee = ("李雷", "开发部", (116.397, 39.908))

# 嵌套解包
name, dept, (longitude, latitude) = employee

print("姓名:", name)        # 输出: 李雷
print("经度:", longitude)   # 输出: 116.397
print("纬度:", latitude)    # 输出: 39.908
3. 变量互换值的底层机制
在 Python 中交换两个变量的值非常优雅,无需定义临时中间变量:
a = 100
b = 200

# 一行实现变量值互换
a, b = b, a

print("a =", a, "b =", b)  # 输出: a = 200 b = 100
这行语句的底层逻辑正是序列解包:右侧的 b, a 隐式构造了一个包含 (200, 100) 的元组,接着左侧的 a, b 执行解包赋值,分别接收元组的第一项和第二项。
六、核心规则与避坑总结
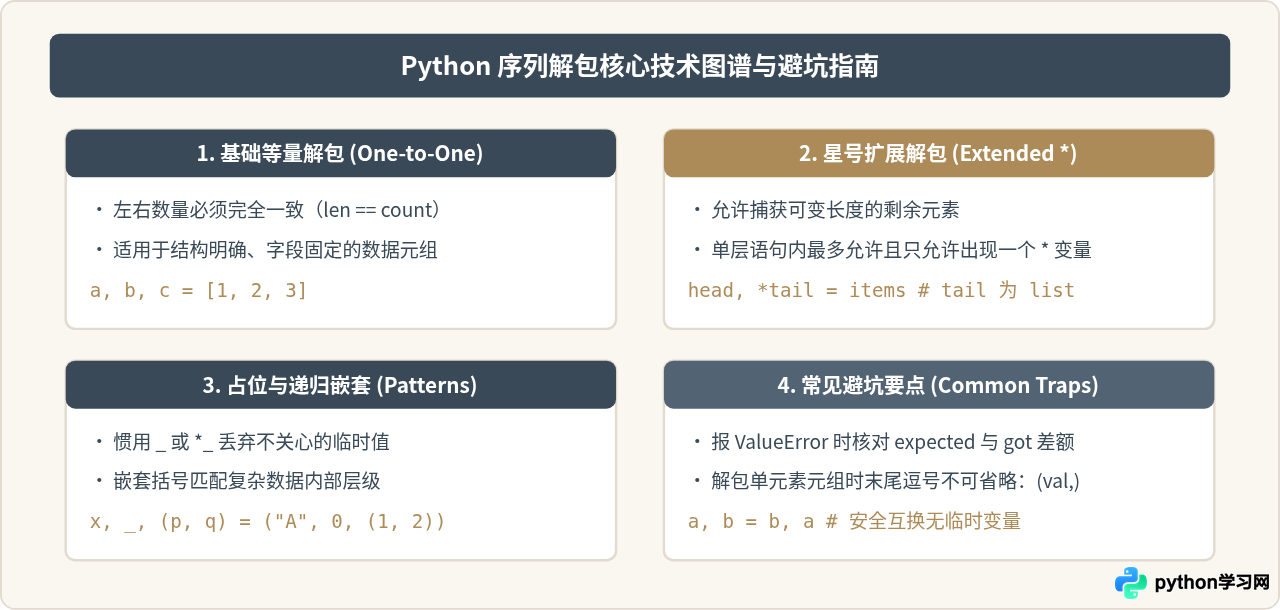
掌握序列解包后,可以大幅精简循环与函数返回值解析的代码。以下表格整理了日常开发中最常用的解包写法与核心关注点:
| 场景需求 | 代码示例 | 关键特性 / 注意事项 |
|---|---|---|
| 标准定长解包 | a, b, c = [1, 2, 3] |
变量数必须严格等于序列长度,否则触发 ValueError |
| 切取头部与剩余 | first, *rest = items |
rest 始终返回列表,无剩余时为 [] |
| 切取尾部与剩余 | *others, last = items |
可精准提取末尾元素,无需手写负索引 [-1] |
| 截取两端忽略中间 | start, *_, end = items |
利用 *_ 占位符忽略中间任意数量的非关键字段 |
| 两变量无缝交换 | x, y = y, x |
Pythonic 的标准交换语法,无需第三方中间变量 |
在日常编写 Python 代码时,建议优先使用序列解包替代繁琐的手动索引取值。对于固定长度的数据直接使用基础解包,遇到长度变化或只需局部数据的场景适时引入星号表达式,可以让代码逻辑更加清晰易读。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









