

python必背源代码numpy数组运算代码
全面解析Python数据科学与科学计算必背的NumPy数组运算核心源代码,包含逐元素算术、广播机制维度对齐、多维轴向聚合归约、布尔条件筛选及矩阵乘法,配以详细代码示例、运行输出与架构图解。
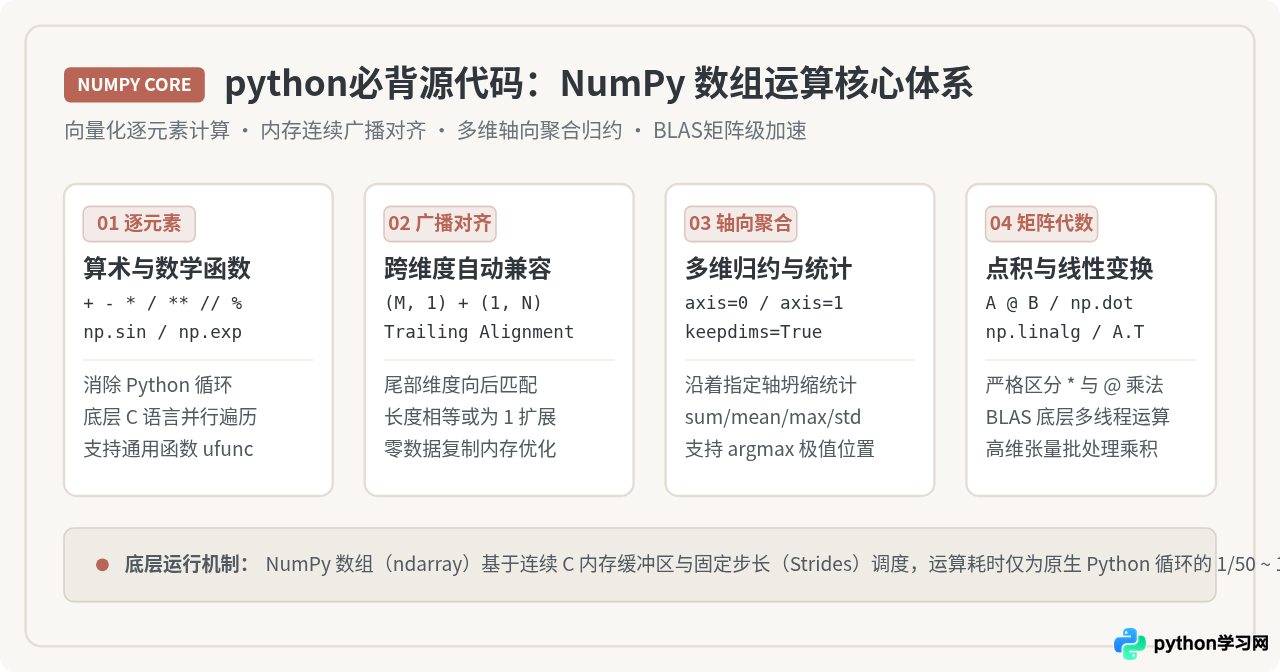
缩略图:NumPy 数组运算核心体系架构(包含四大计算范式与底层 C 内存调度机制)
掌握 NumPy 数组运算的核心在于理解向量化(Vectorization)与广播机制(Broadcasting)。通过将多维数组交由底层的连续 C 语言内存缓冲区与硬件 BLAS/SIMD 向量流水线进行处理,NumPy 能够彻底消除 Python 原生 for 循环带来的解释器开销,将海量数据的批量算术、多维轴向统计以及线性代数变换提升数十倍至上百倍的执行效率。本文整理了在工程与科研实战中必须熟记的典型源代码范式与核心避坑准则。
一、基础逐元素算术运算代码
逐元素运算(Element-wise Operations)是 NumPy 最直观的操作模式。只要两个数组的维度形状完全相同(或满足广播条件),所有标准算术运算符(+、-、*、/、**、//、%)均会按元素位置对应计算,直接返回相同形状的新数组。
import numpy as np

# 1. 基础数组构建(形状均为 2x3)
a = np.array([[10.0, 20.0, 30.0],
              [40.0, 50.0, 60.0]], dtype=np.float64)
b = np.array([[2.0, 4.0, 5.0],
              [8.0, 5.0, 4.0]], dtype=np.float64)

# 2. 核心逐元素四则与幂次运算
add_res = a + b       # 加法等价于 np.add(a, b)
sub_res = a - b       # 减法等价于 np.subtract(a, b)
mul_res = a * b       # 逐元素相乘等价于 np.multiply(a, b)(注意:不是矩阵乘法)
div_res = a / b       # 浮点除法等价于 np.divide(a, b)
pow_res = b ** 2      # 逐元素平方
mod_res = a % b       # 取模运算

print("逐元素乘积 a * b:
", mul_res)
print("逐元素除法 a / b:
", div_res)
除了四则运算符外,NumPy 提供了丰富的通用函数(Universal Functions,简称 ufunc),它们能在底层 C 语言级别以极高吞吐处理数学变换:
# 常用数学变换 ufunc 源码
x = np.array([-1.5, 0.0, 1.5, 3.0])

exp_val = np.exp(x)         # 指数运算 e^x
log_val = np.log(x[x > 0])  # 自然对数 ln(x),仅对正数计算
sin_val = np.sin(x)         # 三角正弦函数
abs_val = np.abs(x)         # 绝对值计算
sqrt_val = np.sqrt(abs_val) # 开平方根

print("自然指数 np.exp(x):
", np.round(exp_val, 4))
print("绝对值 np.abs(x):
", abs_val)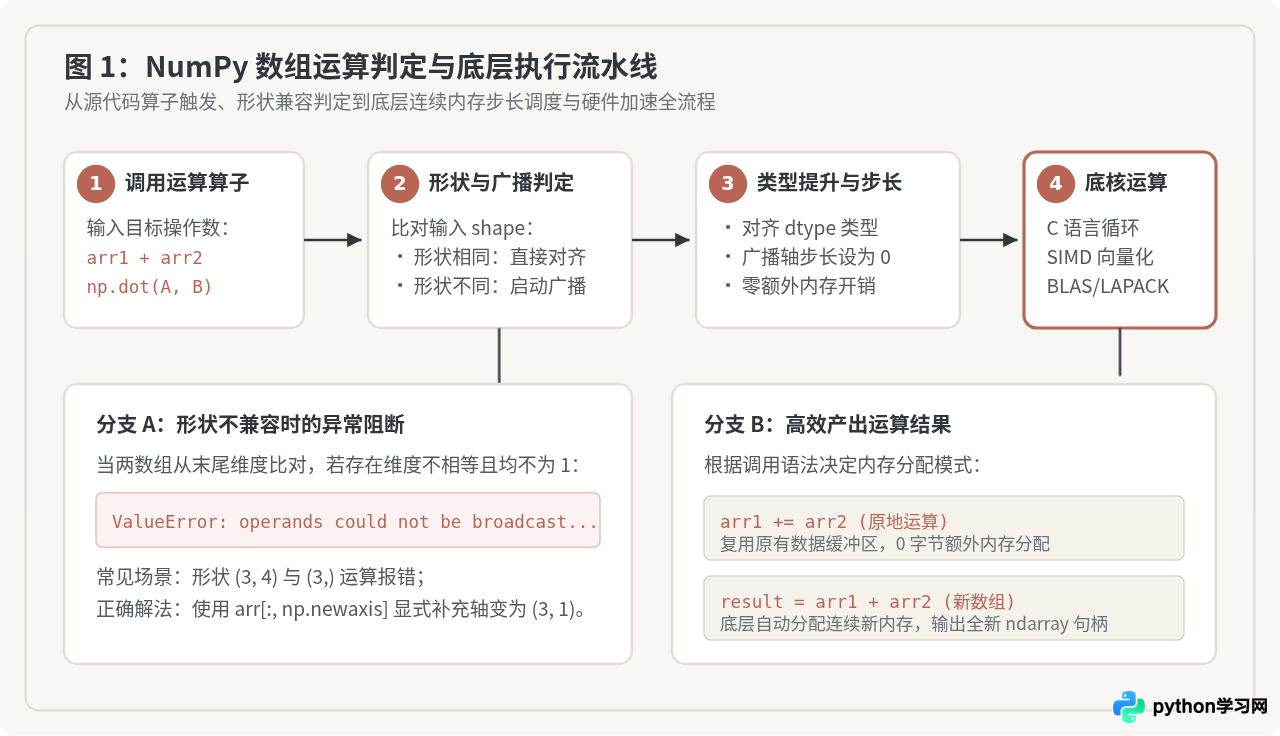
图 1:NumPy 数组运算执行路径与底层判定流程图(涵盖算子分发、广播判定、步长调度与内存产出)
二、广播机制(Broadcasting)核心规则与运算代码
广播是 NumPy 优雅处理不同形状数组混合运算的核心机制。它允许较小的数组在不进行物理内存复制的前提下,“虚拟拉伸”至较大数组的维度,从而完成算术对齐。
1. 广播的两大核心准则
- 从尾部维度开始右对齐:比较两个数组的形状时,从最后一个维度(右侧)逐个向前对比。如果维数不同,较少维度的数组在左侧自动补 1。
- 维度兼容条件:在每个比对的维度上,两个数组的长度必须完全相等,或者其中一个长度为 1。当长度为 1 时,该数组会在该维度上进行虚拟延伸。
import numpy as np

# 场景 1:二维矩阵与一维向量相加
# A 形状: (3, 3),B 形状: (3,) -> B 自动补充为 (1, 3),并沿第 0 轴虚拟扩展为 (3, 3)
A = np.array([[1, 2, 3],
              [4, 5, 6],
              [7, 8, 9]])
B = np.array([10, 20, 30])
res_1 = A + B

# 场景 2:列向量与行向量相加形成网格(外和)
# col_vec 形状: (3, 1),row_vec 形状: (1, 4)
# 广播后输出形状: (3, 4)
col_vec = np.array([[10], [20], [30]])      # shape: (3, 1)
row_vec = np.array([[1, 2, 3, 4]])          # shape: (1, 4)
res_grid = col_vec + row_vec

print("矩阵加一维行向量 A + B:
", res_1)
print("
列向量加行向量网格 (3, 1) + (1, 4):
", res_grid)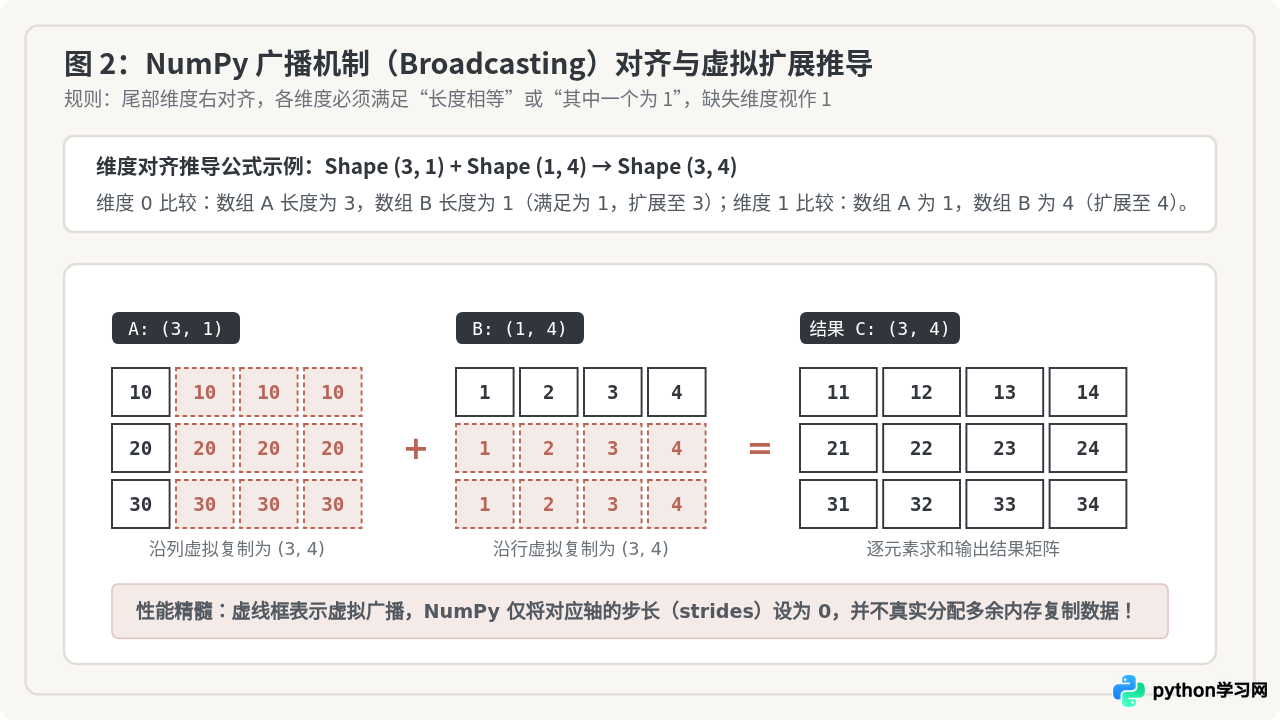
图 2:NumPy 广播机制(Broadcasting)维度对齐与虚拟扩展推导图解
(3, 4) 的矩阵与一个长度为 3 的一维向量 (3,) 直接相加,NumPy 会抛出 ValueError: operands could not be broadcast together with shapes (3,4) (3,)。原因在于尾部对齐时 4 与 3 既不相等且均不为 1。正确的做法是使用 vec[:, np.newaxis] 将其显式升维为 (3, 1)。
三、多维数组统计与聚合归约运算
聚合运算(Reduction)将高维数组按指定维度进行归约汇总。掌握 axis 参数是编写高效统计代码的关键。
axis=None(默认):将整个数组拉平成一维后计算全局总标量。axis=0:跨越行方向(纵向)坍缩,保留各列的统计值,结果形状由(M, N)变为(N,)。axis=1:跨越列方向(横向)坍缩,保留各行的统计值,结果形状由(M, N)变为(M,)。keepdims=True:保留原有维度数量(长度变为 1),防止维度降维,便于后续直接进行广播操作。
import numpy as np

data = np.array([[12, 18, 25, 30],
                 [15, 22, 19, 28],
                 [10, 14, 32, 24]], dtype=np.float64)

# 1. 常用聚合统计函数
total_sum = np.sum(data)             # 全局总和
col_mean  = np.mean(data, axis=0)    # 按列计算均值,shape: (4,)
row_max   = np.max(data, axis=1)     # 按行计算最大值,shape: (3,)
row_argmax = np.argmax(data, axis=1) # 按行获取最大值所在列索引
std_dev   = np.std(data, axis=0)     # 按列计算标准差

# 2. keepdims=True 在特征归一化(Z-score 标准化)中的必背范式
mean_keep = np.mean(data, axis=0, keepdims=True)  # shape: (1, 4)
std_keep  = np.std(data, axis=0, keepdims=True)   # shape: (1, 4)
standardized_data = (data - mean_keep) / std_keep

print("各列均值 col_mean (axis=0):", np.round(col_mean, 2))
print("各行最大值 row_max (axis=1):", row_max)
print("各行最大值所在列索引 row_argmax:", row_argmax)
print("
标准化后矩阵 (前 2 行):
", np.round(standardized_data[:2], 3))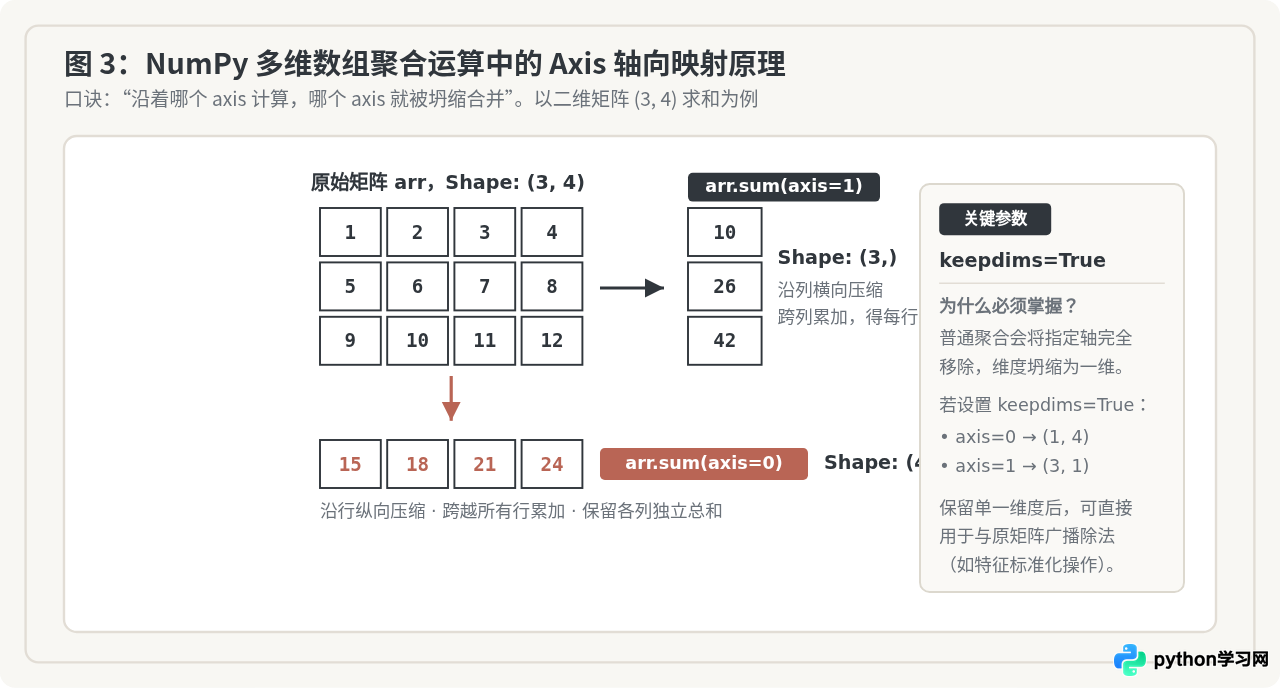
图 3:NumPy 多维数组聚合运算中的 Axis 轴向映射与 keepdims 机制原理图
四、线性代数与矩阵乘法代码
在科学计算、机器学习与图像处理领域,必须严格区分逐元素乘积与线性代数矩阵乘积。混淆两者是初学者最常犯的错误之一。
| 运算类型 | 调用代码 | 数学含义 | 形状约束条件 |
|---|---|---|---|
| 逐元素乘积 | A * B 或 np.multiply(A, B) |
Hadamard 乘积,对应坐标相乘 | 形状完全相同,或满足广播规则 |
| 矩阵乘法(点积) | A @ B 或 np.matmul(A, B) |
行向量与列向量内积求和 | A 的尾维度必须等于 B 的倒数第二维度 |
| 向量内积 | np.dot(u, v) |
标量点积 \(\sum u_i v_i\) | 两向量长度必须相等 |
| 矩阵转置 | A.T 或 A.transpose() |
交换行列轴向 | 二维数组行列反转,(M, N) 变为 (N, M) |
import numpy as np

# 矩阵定义
W = np.array([[1.0, 2.0, 3.0],
              [4.0, 5.0, 6.0]])  # 形状: (2, 3)
x = np.array([0.5, 1.0, -0.5])   # 形状: (3,)

# 1. 矩阵与向量点乘 (2, 3) @ (3,) -> (2,)
y = W @ x

# 2. 矩阵与矩阵乘法 (2, 3) @ (3, 2) -> (2, 2)
V = np.array([[1.0, 0.0],
              [0.0, 1.0],
              [1.0, 1.0]])       # 形状: (3, 2)
M = W @ V

# 3. 矩阵转置与行列式计算
W_transpose = W.T                # 形状变为 (3, 2)
square_mat = np.array([[2.0, 1.0],
                       [1.0, 3.0]])
det_val = np.linalg.det(square_mat)       # 计算行列式
inv_mat = np.linalg.inv(square_mat)       # 矩阵求逆

print("线性仿射变换 y = W @ x:
", y)
print("
矩阵乘积 W @ V:
", M)
print("
矩阵逆 np.linalg.inv:
", np.round(inv_mat, 4))五、条件布尔筛选与掩码运算
在不写循环的情况下完成条件过滤与数组元素修改,依赖的是布尔掩码(Boolean Masking)和条件通用函数。
import numpy as np

arr = np.array([[15, -4, 28],
                [-9, 32, -1],
                [45, 18, -6]])

# 1. 条件比较生成布尔掩码(Boolean Mask)
pos_mask = arr > 0
print("布尔掩码 (arr > 0):
", pos_mask)

# 2. 复合条件筛选(必须使用位运算符 &、|、~,每个条件必须用括号包围)
filtered_vals = arr[(arr > 10) & (arr < 40)]
print("
大于10且小于40的元素:
", filtered_vals)

# 3. np.where 条件赋值:np.where(condition, x, y)
# 若大于 0 保留原值,否则替换为 0(ReLU 激活函数原型)
relu_res = np.where(arr > 0, arr, 0)
print("
np.where 条件赋值:
", relu_res)

# 4. np.clip 数值边界截断限制
clipped_res = np.clip(arr, a_min=0, a_max=25)
print("
数值截断 np.clip [0, 25]:
", clipped_res)六、内存机制、高频避坑与性能优化准则
NumPy 之所以高效,关键在于其内存结构设计:底层数据保存在一段连续的内存块(Data Buffer)中,外层由形状(shape)、数据类型(dtype)以及步长(strides)构成的元数据来控制寻址。在日常编码中,如果不注意内存机制,容易写出隐蔽的逻辑 Bug 或造成内存暴增。
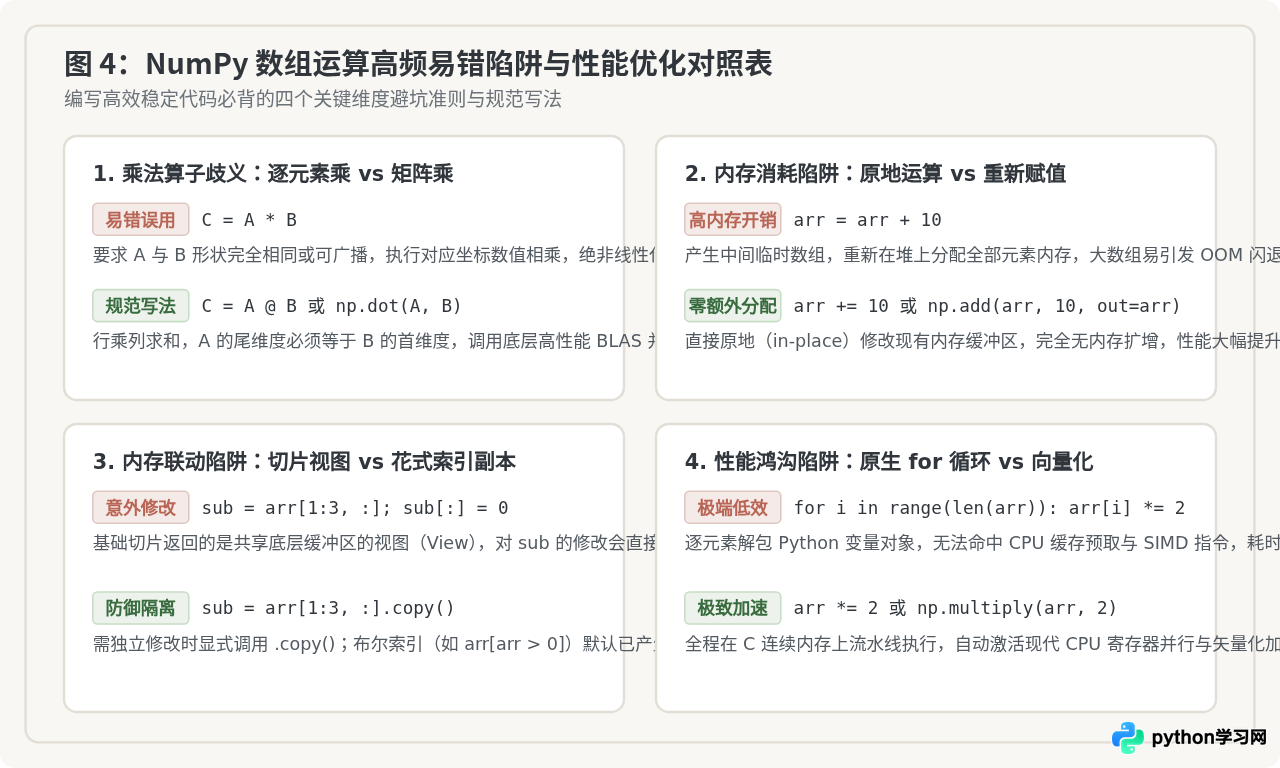
图 4:NumPy 数组运算核心代码避坑与性能优化对照清单
- 优先采用原地运算(In-place Operations):对于大规模数据,使用
arr += 5或np.add(arr, 5, out=arr),避免arr = arr + 5生成临时数组导致内存溢出(OOM)。 - 警惕切片视图与独立副本的界限:普通下标切片(如
view = arr[1:5])仅返回视图,修改view会同步修改arr。如果需要隔离数据,必须显式调用arr[1:5].copy()。花式索引(如arr[[1, 3]])则自动创建副本。 - 防御整数溢出绕回:NumPy 的整型(如
int8、int32)在运算溢出时不会抛出异常,而是会静默回绕(Wrap-around)。例如np.array([127], dtype=np.int8) + 1的结果为-128。涉及大数累加时必须预先指定dtype=np.int64或np.float64。
通过熟练运用逐元素算术、广播补齐、轴向聚合归约、矩阵点乘与布尔掩码这五大核心源码范式,开发者可以在完全告别低效嵌套循环的同时,写出兼具可读性、数学优雅度与极致性能的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









