

Python3.13引入的实验性JIT对NumPy计算有帮助吗?
深入剖析 Python 3.13 实验性 JIT 编译器(PEP 744)对 NumPy 数值计算的实际影响。解析 Copy-and-patch JIT 与 C 扩展运行机制,说明不同代码模式下的性能表现及科学计算加速方案选型。
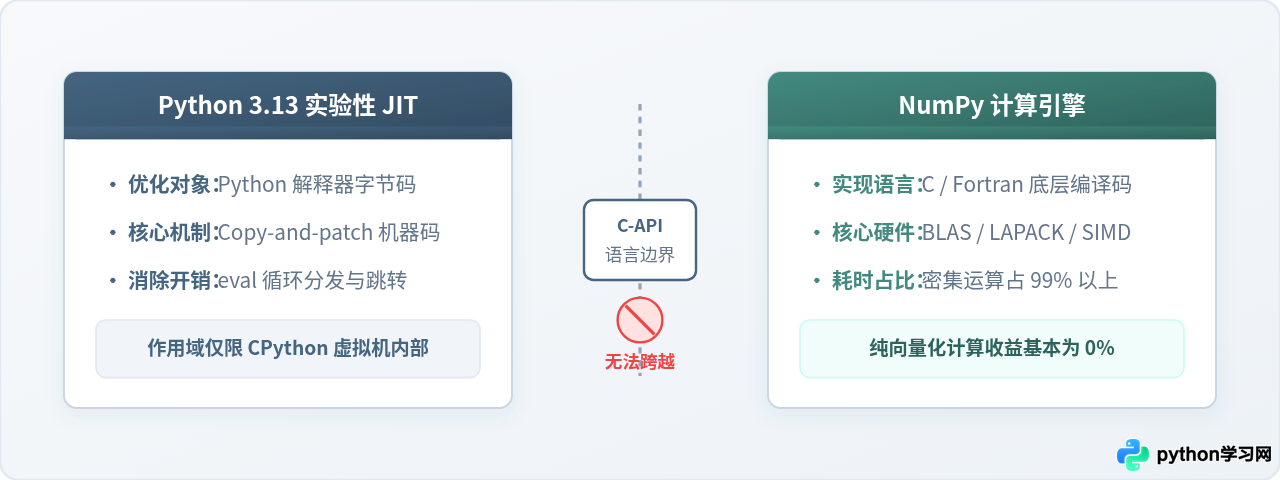
核心结论:对于规范编写的 NumPy 向量化计算,Python 3.13 引入的实验性 JIT 几乎没有任何帮助。NumPy 的密集运算瓶颈发生在底层已编译的 C 语言内核与 BLAS/LAPACK 汇编库中,而 Python 3.13 的 Copy-and-patch JIT 仅用于优化 Python 虚拟机自身的字节码分发开销,无法跨越 C-API 边界去优化底层数组指令。
1. 核心机制剖析:为什么 JIT 无法加速 NumPy?
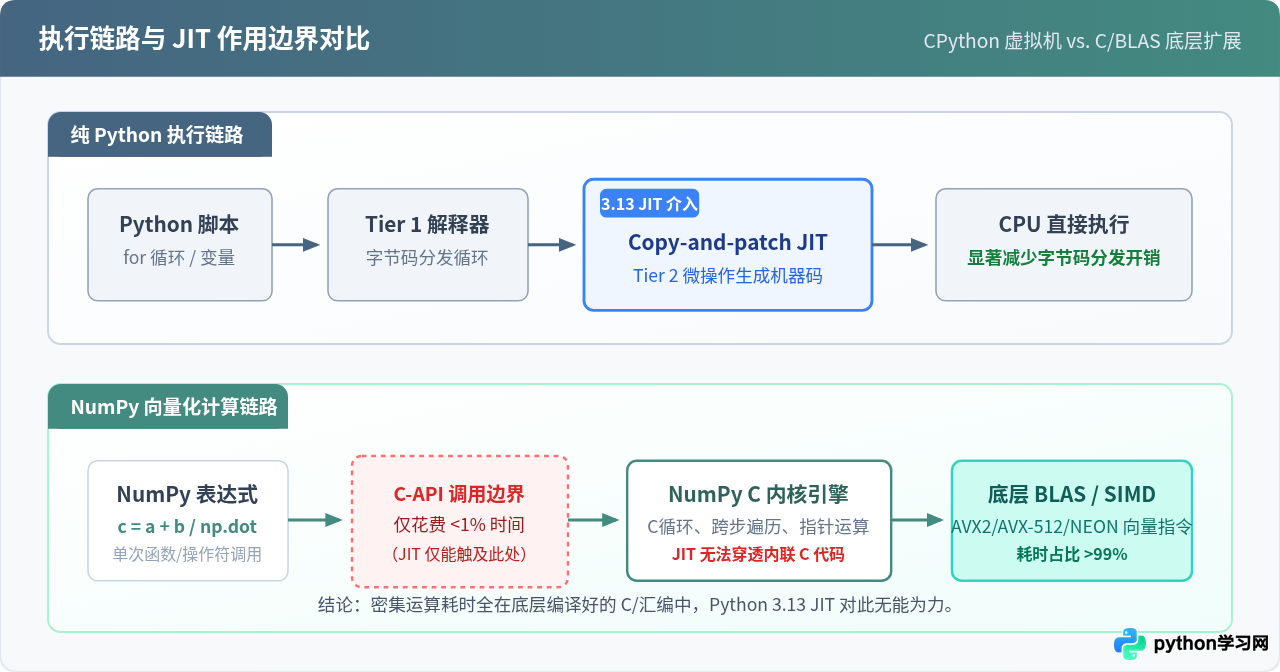
要理解 Python 3.13 的 JIT 为什么无法提升 NumPy 的性能,必须先看清二者的底层职责边界。Python 3.13 引入的实验性 JIT(基于 PEP 744 提出的 Copy-and-patch 架构)针对的是 CPython 虚拟机的字节码解释过程。在传统的 Python 执行模型中,解释器通过一个庞大的循环(eval loop)逐条读取字节码并跳转执行,指令分发和局部变量寻址占据了显著的时间开销。JIT 编译器的任务是在运行时将高频执行的字节码跟踪特化(Tier 2),直接拼接出对应的本地机器指令,从而消除字节码分发的开销。
然而,NumPy 的执行模型完全不同。当我们在 Python 中执行形如 c = a + b 或 np.dot(matrix_a, matrix_b) 这样的向量化表达式时,Python 层面实际只做了一件事:把数组对象的指针作为参数,通过 C-API 移交给 NumPy 预先编译好的 C 扩展模块。进入 C 语言之后,连续内存寻址、广播计算、多线程调度以及 AVX2/AVX-512 等 SIMD 指令的执行,完全由编译好的本地动态链接库接管。
在一次典型的 NumPy 密集矩阵运算中,99% 以上的耗时发生在底层的 C/BLAS 库中,Python 字节码层面的执行时间占比不足 1%。即使 Python 3.13 的 JIT 将这 1% 的解释开销压缩至极限,对于整体运行时间的改变依然在统计误差范围之内。
2. 场景分析:不同代码模式下的实际表现
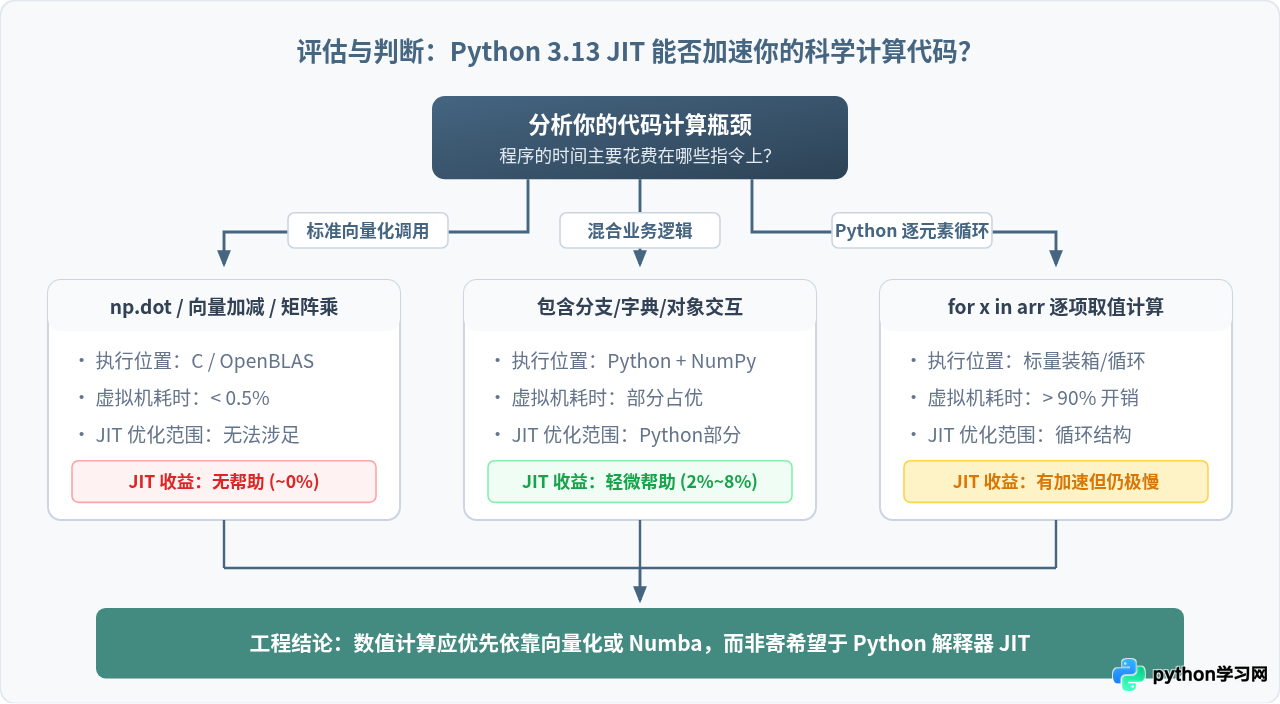
在实际代码中,Python 与 NumPy 的结合方式各不相同。根据计算逻辑的组织方式,Python 3.13 的 JIT 会展现出三种截然不同的表现:
场景 A:标准向量化与通用函数(无实质改善)
这是编写科学计算代码的推荐模式。所有计算都以数组为粒度进行,例如切片加法、矩阵乘法或 np.sin()。在这个场景中,Python 解释器在整个运算期间只被唤醒少数几次。JIT 介入后,加速的仅仅是这几次函数调用的指令准备,因此测试结果显示其性能与未开启 JIT 的 Python 3.13 几乎持平,差异通常在 ±1% 以内。
场景 B:显式 Python 循环遍历数组元素(加速有限且依旧极慢)
这是一种常见的反模式:开发者使用 Python 原生的 for 循环逐个取出 NumPy 数组中的元素进行标量计算。例如:
# 低效的反模式:在 Python 循环中逐项累加
def slow_sum(arr):
    total = 0.0
    for x in arr:
        total += float(x)
    return total
在这种代码中,耗时大头变成了 Python 虚拟机层面的循环迭代、迭代器取值以及将 NumPy 标量解包为 Python 浮点数。Python 3.13 的 JIT 能够识别这个热点循环,并生成优化的机器码,使这段循环的执行速度提升约 10% 到 25%。然而,由于每次取值依然存在标量封箱与对象协议开销,即便利索了 20%,它的总耗时仍然比直接调用 np.sum(arr) 慢几十倍甚至上百倍。依靠 JIT 来拯救这类低效循环并不是合理的解决途径。
场景 C:混合控制流与复杂业务逻辑(轻微收益)
在部分数据预处理代码中,既有 NumPy 运算,又夹杂着大量的 Python 条件分支、字典查找和对象属性访问。此时,JIT 能够有效改善外围 Python 业务代码的吞吐量,但对于其中内嵌的 NumPy 数组计算部分,耗时依然保持原样。
3. 实操步骤:在 Python 3.13 中开启并验证实验性 JIT
如果你需要在本地环境中验证 JIT 的具体效果,可以按照以下步骤完成配置与基准对比。
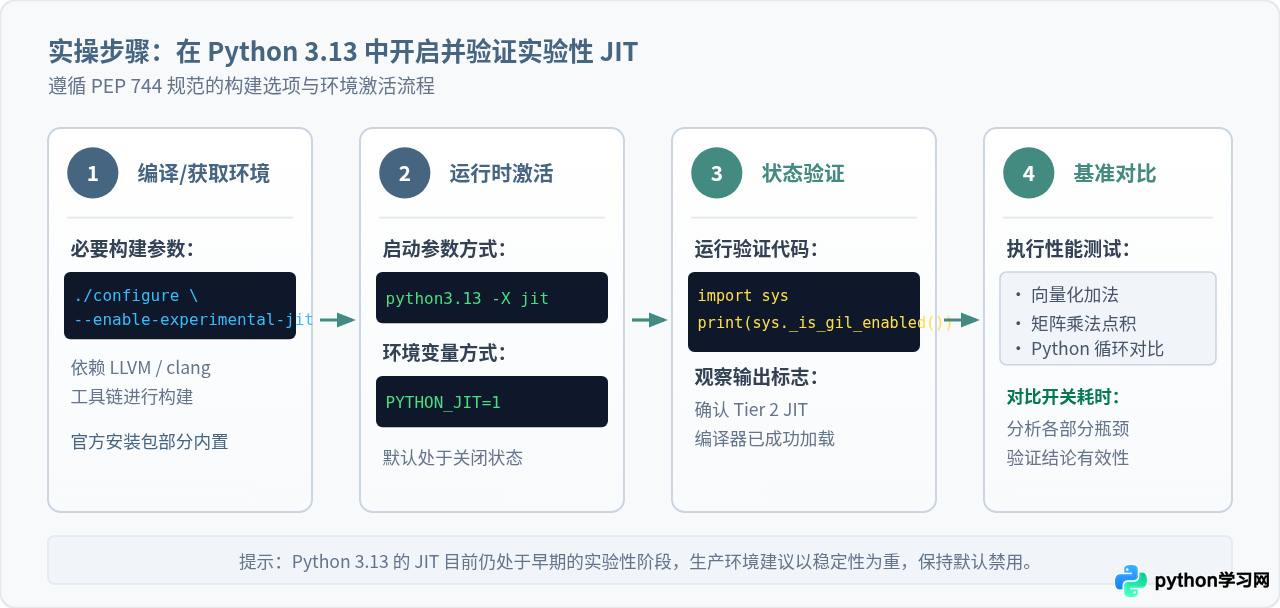
步骤一:确认支持 JIT 的构建版本
Python 3.13 的 JIT 在编译期需要 LLVM/Clang 工具链支持。如果从源码编译,必须在配置时显式传入构建标志:
./configure --enable-experimental-jit
make -j$(nproc)
部分官方二进制发行版已包含该特性,但由于仍属于实验性功能,它在默认启动状态下是禁用的。
步骤二:激活 JIT 运行时
启用 JIT 有两种直接途径:
- 命令行参数:通过
-X jit选项启动脚本。 - 环境变量:在执行前导出
PYTHON_JIT=1。
# 方式 1:使用命令行参数
python3.13 -X jit benchmark.py

# 方式 2:使用环境变量
export PYTHON_JIT=1
python3.13 benchmark.py
步骤三:编写对比基准测试脚本
通过对比测试脚本,可以直观观察到开启 JIT 前后不同计算模式的耗时差异:
import sys
import time
import numpy as np

def benchmark_numpy_vectorized(size=10_000_000):
    a = np.ones(size, dtype=np.float64)
    b = np.full(size, 2.5, dtype=np.float64)
    start = time.perf_counter()
    c = a * 1.5 + b  # 纯向量化操作
    end = time.perf_counter()
    return end - start

def benchmark_numpy_loop(size=200_000):
    a = np.ones(size, dtype=np.float64)
    start = time.perf_counter()
    total = 0.0
    for val in a:     # 反模式:Python 标量迭代
        total += val
    end = time.perf_counter()
    return end - start

if __name__ == "__main__":
    print(f"Python 版本: {sys.version.split()[0]}")
    vec_time = benchmark_numpy_vectorized()
    loop_time = benchmark_numpy_loop()
    print(f"向量化计算耗时: {vec_time * 1000:.2f} ms")
    print(f"标量循环耗时:   {loop_time * 1000:.2f} ms")
关闭 JIT 运行:python3.13 benchmark.py
向量化计算耗时: 18.42 ms | 标量循环耗时: 16.20 ms (20万次迭代)
开启 JIT 运行:python3.13 -X jit benchmark.py
向量化计算耗时: 18.39 ms (变化幅度 < 0.5%,无收益) | 标量循环耗时: 13.80 ms (循环控制流提升约 15%)
4. 延伸对比:为什么数值计算需要专用 JIT?
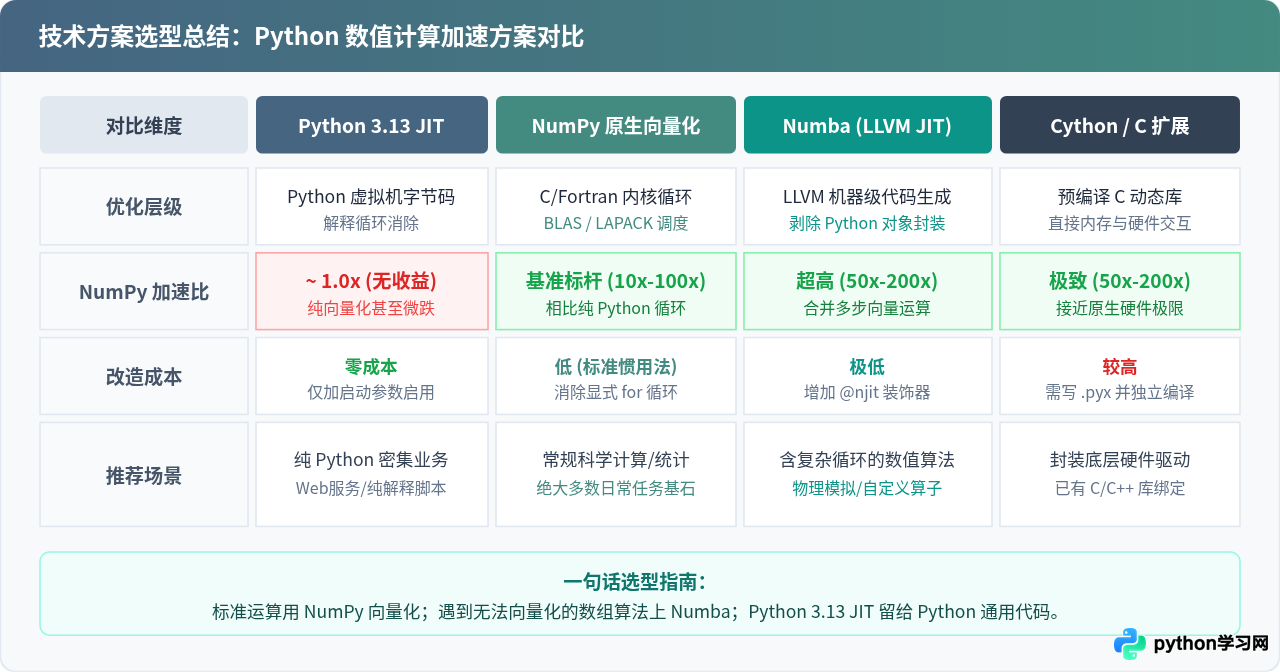
很多开发者容易将 Python 3.13 的 JIT 与科学计算中常用的 Numba 混淆。这两者在设计目标与实现机制上有着根本不同:
- 通用解释器 JIT(Python 3.13):必须严格保证与标准 CPython 语义 100% 兼容。每一个变量依然是
PyObject,每一次操作必须顾及动态类型检查和引用计数。它无法对连续内存做激进的结构重组。 - 数值专用 JIT(Numba / Julia / JAX):针对数值数组进行了特化。在
nopython模式下,Numba 直接解开 Python 对象的包装,提取裸指针和内存跨步信息,交给 LLVM 进行机器级优化。它不仅能自动生成单指令多数据流(SIMD)代码,还能将多步连续的数组循环融合(Loop Fusion)为一个单趟循环,避免创建中间临时数组。
5. 总结与实践建议
综合以上分析,对于关心数值计算性能的工程师,可以得出明确的工程建议:
- 不要把计算加速寄希望于 Python 3.13 JIT:对于正规的 NumPy、SciPy、PyTorch 等基于 C/C++ 扩展的库,该 JIT 无法带来可感知的速度提升。
- 保持向量化核心原则:消除显式 Python 循环、充分利用广播机制与内置通用函数(ufunc),依然是提升 NumPy 效率最稳妥、成本最低的方式。
- 针对无法向量化的复杂算子选用 Numba:如果算法中包含状态依赖强烈的循环(如自定义动态规划、特定差分网格更新),使用 Numba 的
@njit或编写 Cython 模块是成熟的高性能方案。 - 生产环境保持审慎:Python 3.13 的 JIT 仍被官方明确标记为“实验性”(Experimental)。在没有严格基准测试支撑的前提下,不建议在生产环境中盲目开启。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









