

Python经典编程题中的常见陷阱与调试技巧
深入剖析Python经典编程题与面试题中的典型语法与逻辑陷阱,包括可变默认参数、闭包延迟绑定、迭代中修改容器及浅拷贝混叠,并提供系统化的断点调试与排查技巧。
在解答算法题或面试编程题时,很多逻辑看似无懈可击的代码却频繁出现输出异常。这类问题往往不是解题算法本身的缺陷,而是触碰了 Python 底层的对象模型、作用域与执行时机陷阱。本文系统梳理四类最高频的语言陷阱,对比错误与正确方案的底层差异,并提供一套可落地的调试排查流程,帮助读者建立稳固的防御性编码习惯。
陷阱一:可变对象作为函数默认参数
在编写递归树遍历、图搜索或回溯算法时,开发者常习惯在辅助函数中声明一个默认列表用于收集路径或结果。例如下面的写法:
def collect_path(val, path=[]):
    path.append(val)
    return path

# 连续调用测试
print(collect_path(1))  # 预期输出: [1],实际输出: [1]
print(collect_path(2)) # 预期输出: [2],实际输出: [1, 2]第二次调用并没有如预期那样从空列表开始,而是保留了上一次调用的累加结果。这一现象的根本原因在于:Python 中的默认参数是在函数定义(编译并创建函数对象)时求值并初始化的,而不是在每次调用时重新生成。
当默认参数是一个可变对象(如 list、dict 或 set)时,所有未显式传入该参数的调用,都会共享同一个堆内存中的对象引用。
错误做法:可变默认参数
函数对象的 __defaults__ 元组永久绑定单个列表对象,多次调用不断追加污染,产生状态残留。
标准做法:使用 None 哨兵值
以不可变对象 None 作为默认值,在函数体运行时动态判断并新建实例,保证各次调用相互独立。
def collect_path(val, path=None):
    if path is None:
        path = []
    path.append(val)
    return path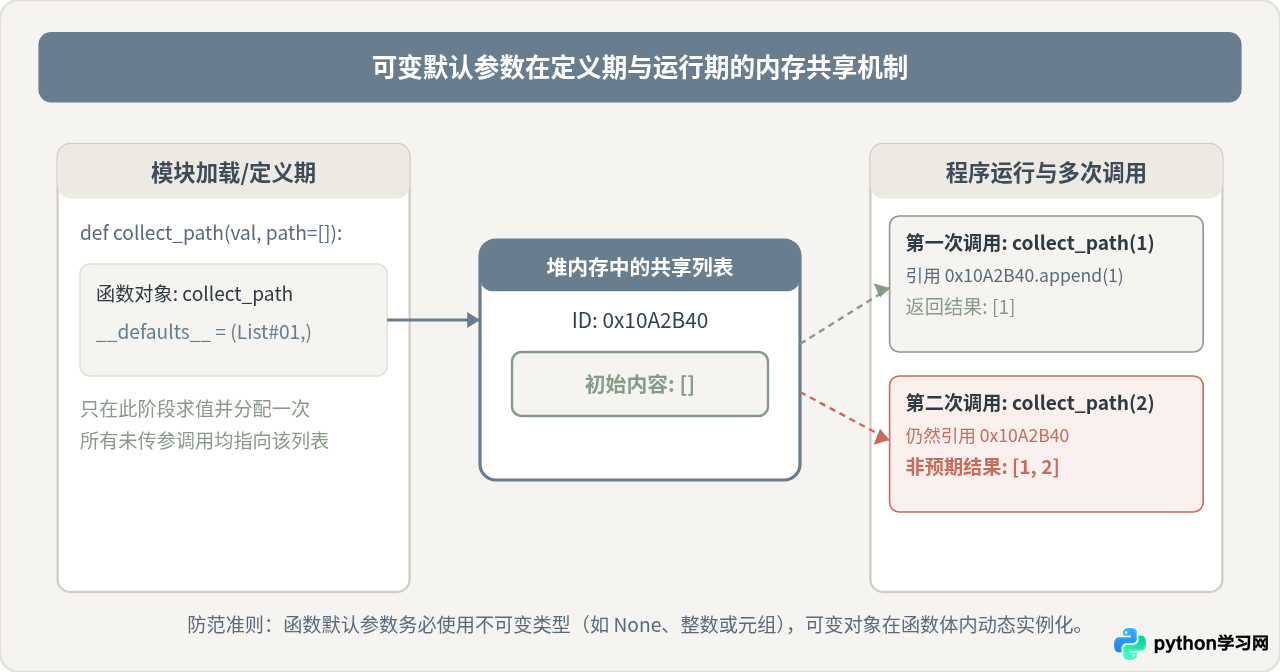
陷阱二:循环闭包中的变量延迟绑定
在构建回调函数列表、配置规则映射或生成算子管道时,常在循环内部生成 lambda 或局部函数。这类场景极易出现全量覆盖的隐蔽 Bug:
operations = [lambda x: x + i for i in range(3)]

# 执行每个算子,期望输入 10 分别得到 10+0=10, 10+1=11, 10+2=12
results = [op(10) for op in operations]
print(results)  # 实际输出: [12, 12, 12]
出现全为 12 的原因是:Python 的闭包查找变量遵循词法作用域的延迟绑定(Late Binding)原则。 闭包内部并不在定义时拷贝外层变量的当前值,而是在真正执行调用时,去外部作用域按名称查找该变量的最新值。当列表推导式或循环完成时,变量 i 的最终值已固定为 2,后续所有函数的执行自然都会读取到 2。
默认机制:延迟查找
函数体内的 i 只是一个自由变量名,执行时统一回溯到外层作用域,只能取得循环结束时的最终值。
解法:默认参数即时求值
利用默认参数在函数创建时求值的机制,将外层变量的值在循环当前轮次作为默认值固定下来:lambda x, i=i: x + i。
另一种优雅且无副作用的替代方案是使用标准库提供的 functools.partial,它能显式且安全地冻结位置参数:
from functools import partial

operations = [partial(lambda val, step: val + step, step=i) for i in range(3)]
print([op(10) for op in operations])  # 输出: [10, 11, 12]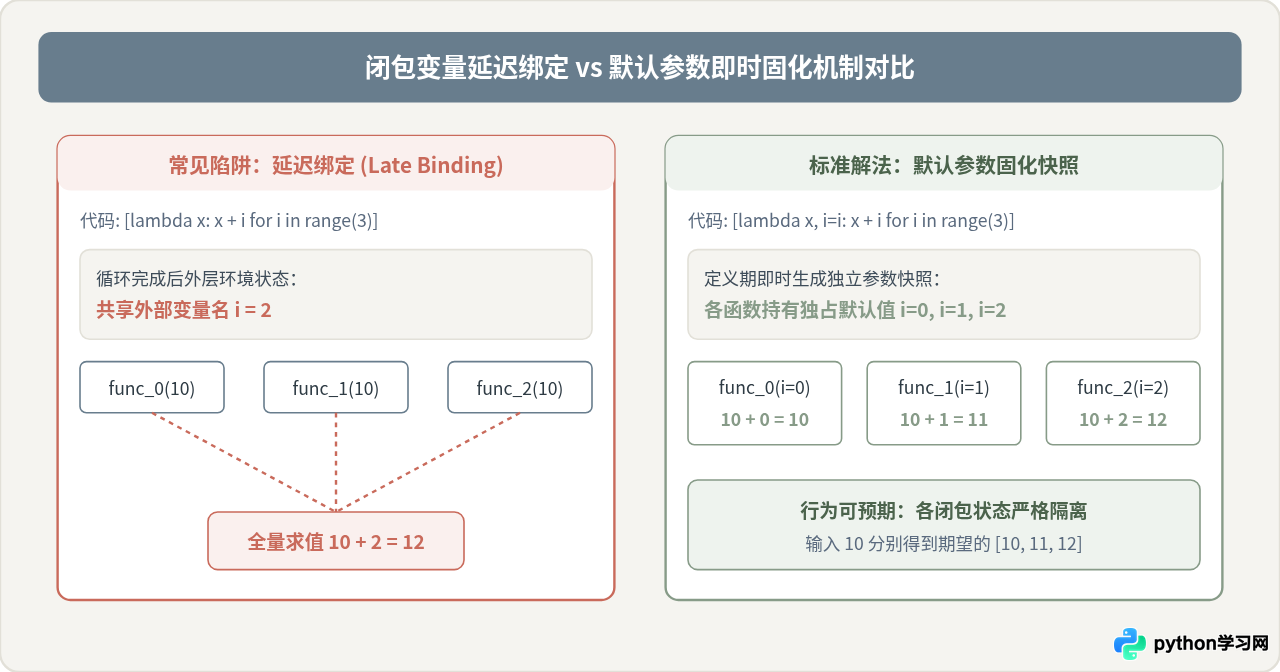
陷阱三:遍历容器的同时直接修改元素
在清洗数据或过滤节点时,不少初学者会写出边迭代边删除的代码:
nums = [1, 2, 2, 3, 4, 2, 5]
for x in nums:
    if x == 2:
        nums.remove(x)

print(nums)  # 期望清除所有 2,实际输出: [1, 3, 4, 2, 5]
运行结果中依然残留了元素 2。其机理在于:Python 列表的迭代器在内部维护着一个递增的整型索引偏移量。当在索引 k 处执行 remove() 时,其后方的所有元素会整体向左移动一位;而迭代器在下一轮循环中继续将索引递增到 k+1,导致原本紧随其后的相邻元素被无声漏检。
如果是字典结构,在 for k in d: 中进行 del d[k] 甚至会直接抛出运行时异常:RuntimeError: dictionary changed size during iteration。
- 不可变过滤模式(首选): 使用列表推导式或生成器表达式创建过滤后的新容器:
nums = [x for x in nums if x != 2],时间复杂度为 \(O(N)\),逻辑最为清晰。 - 倒序原地删除模式: 如果必须原地修改且内存受限,可以采用倒序索引
for i in range(len(nums) - 1, -1, -1):,后方删除不影响前方未访问元素的下标定位。
陷阱四:浅拷贝与多维列表初始化的引用混叠
在动态规划、矩阵运算或棋盘类算法题中,常需初始化一个 \(M \times N\) 的二维矩阵。最常见的隐蔽错误写法是使用乘法运算符嵌套复制:
# 陷阱:3行3列的零矩阵
matrix = [[0] * 3] * 3

# 修改坐标 (0, 0) 为 1
matrix[0][0] = 1

# 打印矩阵
for row in matrix:
    print(row)
# 实际输出整列都变成了 1:
# [1, 0, 0]
# [1, 0, 0]
# [1, 0, 0]
乘法运算符 [obj] * 3 执行的是浅拷贝,外层列表存储的三个元素,实际上是指向堆中同一个子列表 [0, 0, 0] 的指针。因此,修改任意一行的某个位置,其余各行都会“同步变动”。
正确初始化方式: 必须使用独立的推导式分别创建每一行的独立实例:
matrix = [[0 for _ in range(3)] for _ in range(3)]
matrix[0][0] = 1  # 此时仅第一行被修改: [[1, 0, 0], [0, 0, 0], [0, 0, 0]]
算法题中的高效调试与排查四步法
当编写好的算法题代码出现诡异 Bug 或边界用例挂起时,切忌盲目胡乱猜测修改。推荐按以下四个步骤进行系统化定位:
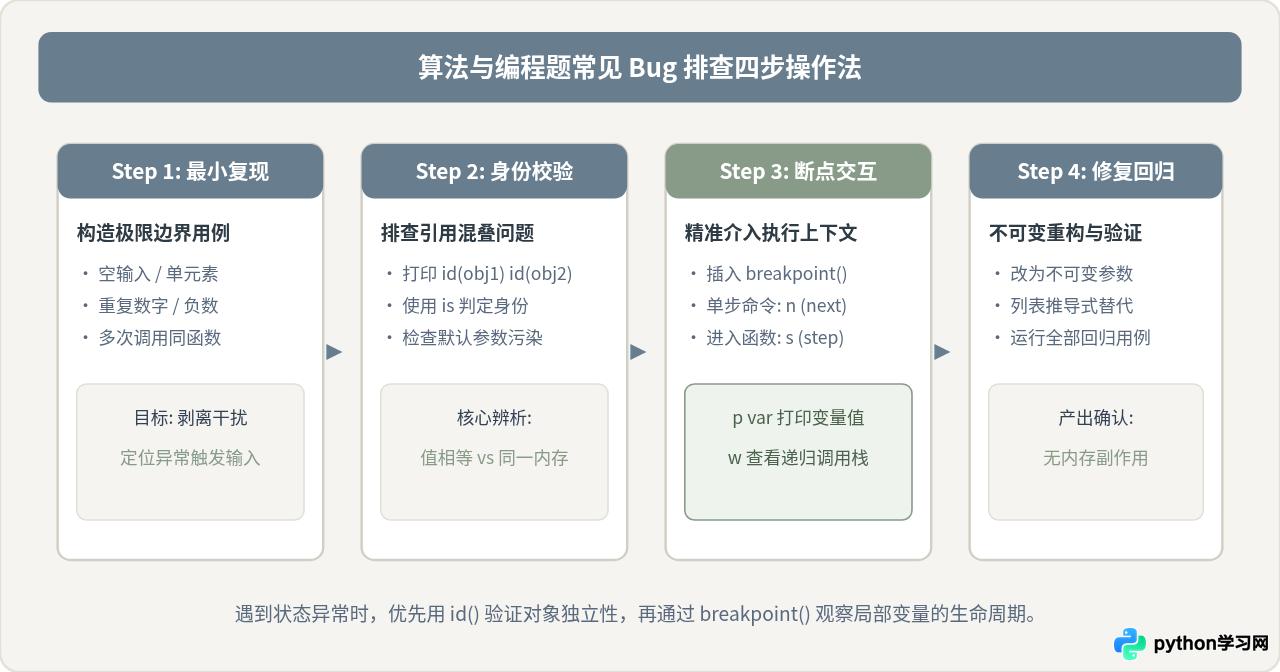
实战调试示例:利用内置 pdb 单步追踪递归状态
在 Python 3.7+ 中,直接在代码中调用内置函数 breakpoint(),即可在程序运行至该处时中断并唤起交互式调试器。无需安装任何第三方库:
def dfs_search(node, visited=None):
    if visited is None:
        visited = set()

    # 插入断点观察每一步的图遍历状态
    breakpoint()

    visited.add(node.val)
    for neighbor in node.neighbors:
        if neighbor.val not in visited:
            dfs_search(neighbor, visited)
    return visited
在调试提示符 (Pdb) 下,最常用的调试指令如下:
p variable_name:打印指定变量的当前值或计算表达式;p id(variable_name):查看对象的内存地址,快速确认是否存在不应共享的同一引用;n(next):执行当前行并暂停在下一行(不进入被调函数内部);s(step into):单步进入当前调用的子函数内部(例如深入递归子调用);w(where):打印当前的函数调用栈帧,清晰展现深层递归的来龙去脉;c(continue):恢复程序正常运行,直到下一个断点或结束。
防坑全景总结与规范清单
掌握常见陷阱不仅能帮助我们在刷题与面试中快速规避低级错误,更能从根本上加深对 Python 内存模型与执行机制的理解。下图将本节讨论的核心陷阱与防范规范汇总为一张全景图:
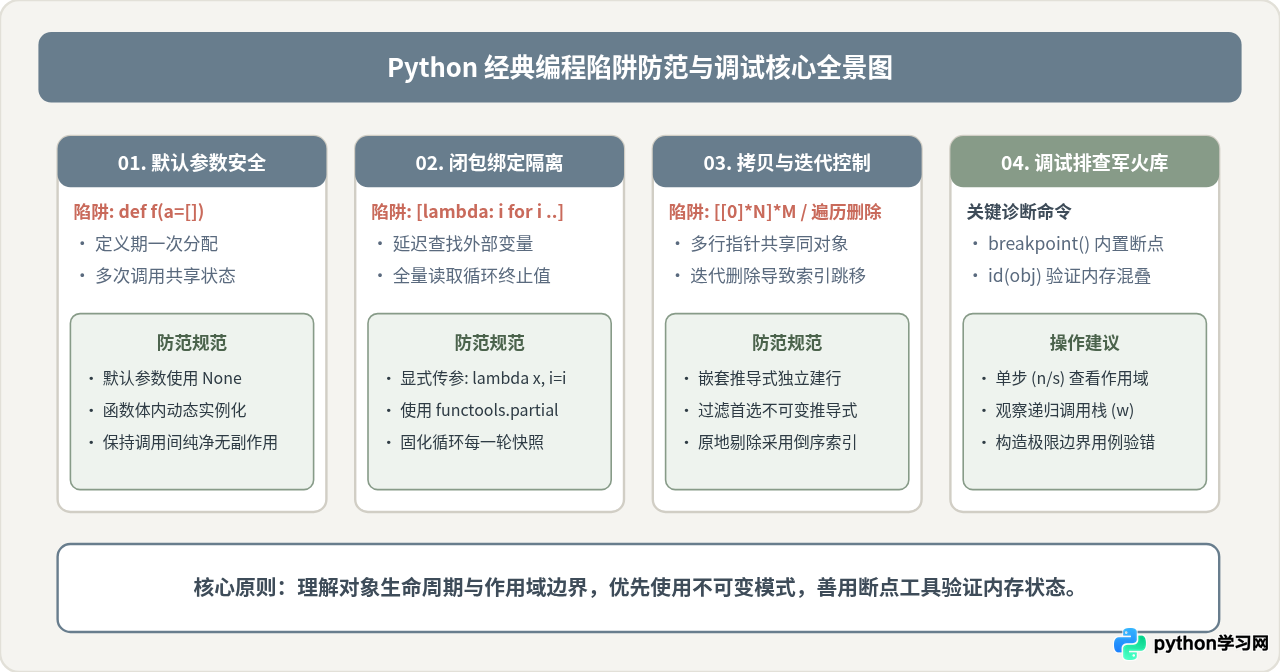
在日常练习和面试解题过程中,保持对可变状态和作用域时序的敏感度,将“防御性设计”(如使用不可变默认值、推导式生成独立容器)作为第一直觉,遇到异常输出时结合 id() 判定与 breakpoint() 单步探查,即可从容化解绝大多数难以察觉的语法与逻辑陷阱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









